高性价比的 GPT-5.6 API 定价
Kie.ai 帮助开发者将模型成本与请求的实际难度精准匹配。复杂的任务可调用 GPT-5.6 Sol API,平衡的生产任务可交由 Terra 处理,而高频的轻量级请求可通过 Luna 运行。这使得产品在保持卓越输出质量的同时,无需为每次交互承担旗舰级模型的成本。
GPT-5.6 将 Sol、Terra 与 Luna 整合为一个三阶模型家族,专为前沿智能、高效的日常工作,以及跨技术和专业领域的高并发快速执行而打造。
Automatically append previous messages to maintain multi-turn context. May increase token usage.
Automatically append previous messages to maintain multi-turn context. May increase token usage.
Automatically append previous messages to maintain multi-turn context. May increase token usage.
Complete guide to using gpt-5-6-sol
在 Kie.ai 选择 GPT-5.6 Sol、Terra 或 Luna,为各项 AI 应用精准匹配前沿能力、平衡性能或高性价比的极速体验。
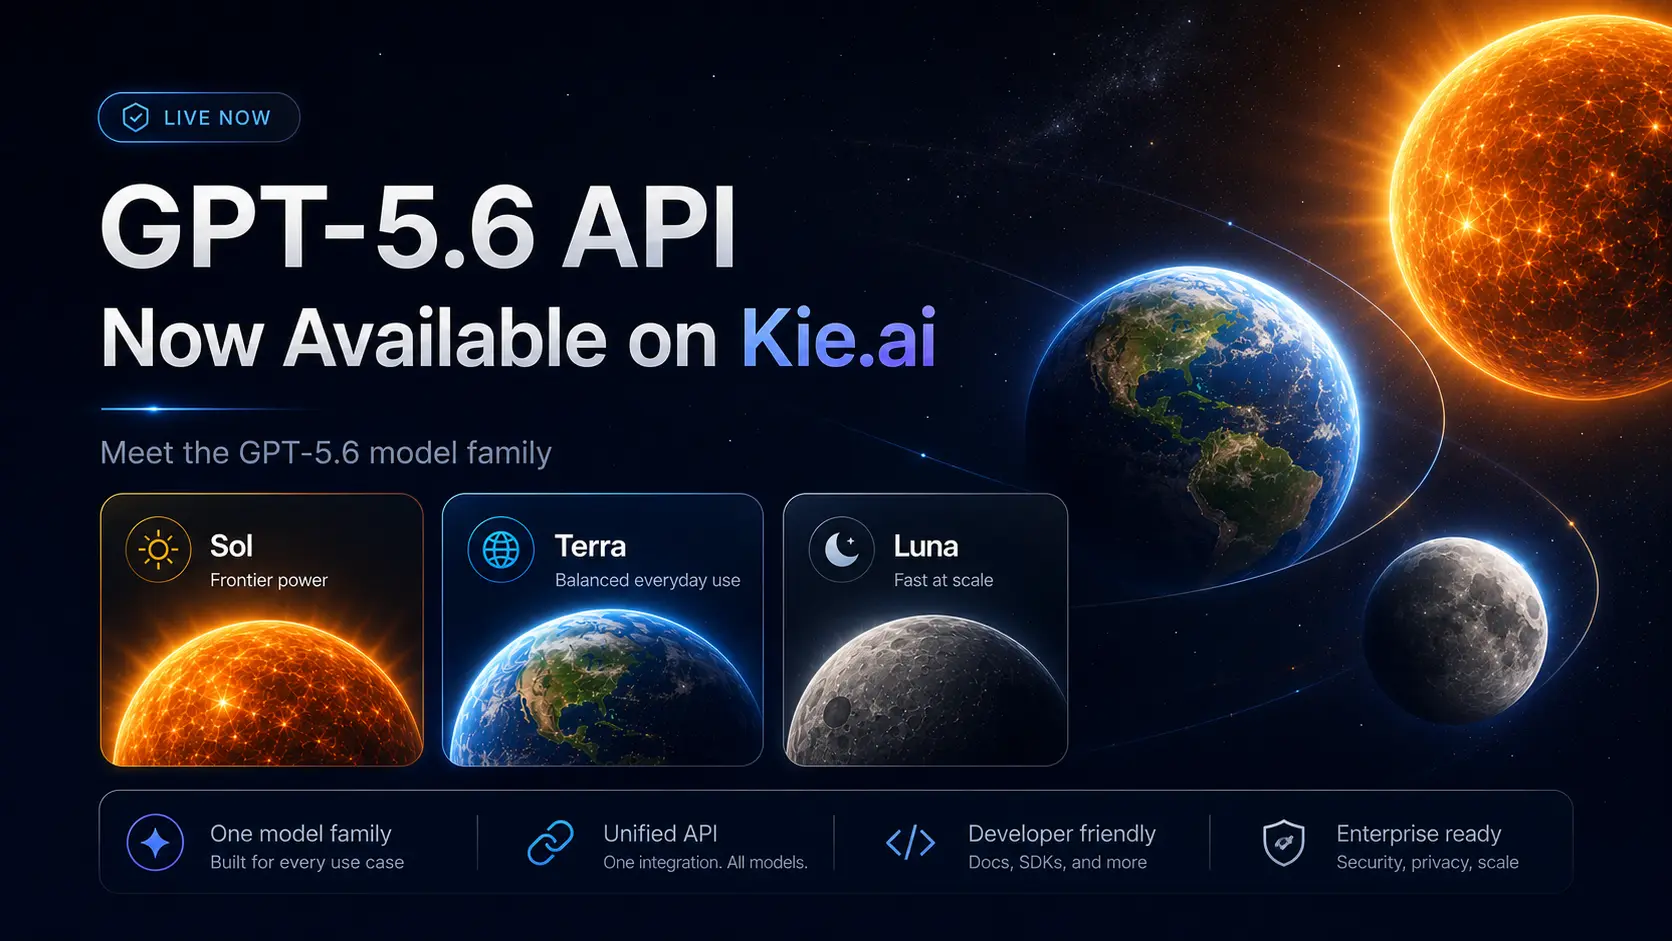
GPT-5.6 于 2026 年 7 月 9 日发布,是 OpenAI 专为满足不同维度的智能、效率、速度和规模需求而打造的三层模型系列。Sol 以前沿的能力应对最严苛的任务,Terra 将强大的性能与日常实用的高效性相平衡,Luna 则为高吞吐量应用提供快速、经济的执行能力。通过 Kie.ai,您可以全面接入该系列模型,包括 GPT-5.6 Sol API、GPT-5.6 Terra API 和 GPT-5.6 Luna API。 如果您正在比较 GPT-5.6 的三个层级并希望处理复杂任务而无需逐层选择,可进一步了解 GPT-6 Astra API。
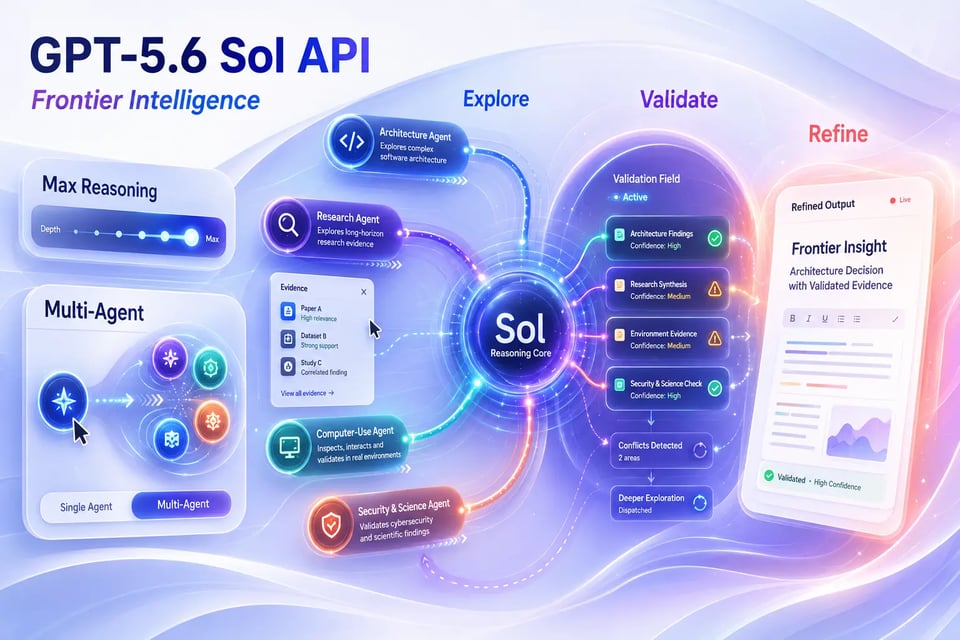
GPT-5.6 Sol API 是旗舰层级,专为需要高级推理、编码、工具调用和细致结果优化的复杂工作打造。其能力广泛涵盖软件工程、长周期研究、专业知识工作、计算机操作、网络安全、科学分析及精美成果生成。极致推理与多智能体执行,为需要深度探索、并行处理和严格验证的任务提供了更强的处理能力。
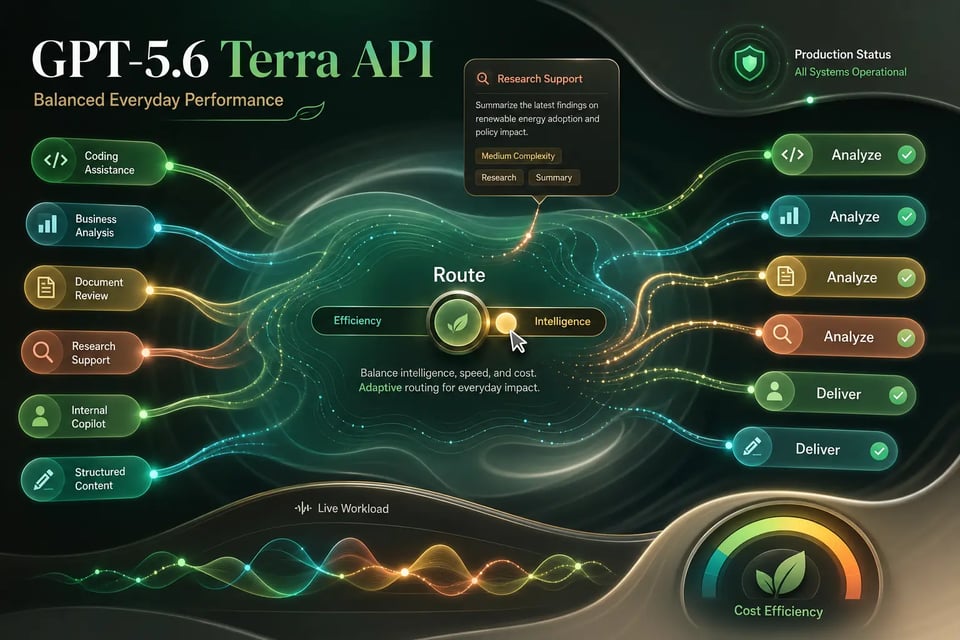
GPT-5.6 Terra API 结合了高智能与高性价比,是常规生产环境的理想之选。它非常适合代码辅助、业务分析、文档审查、研究支持、内部 Copilot、结构化内容生成等任务。对于需要可靠性能,但无需每次请求都依赖旗舰层级的常用 AI 功能,Terra 都能提供坚实的支持。
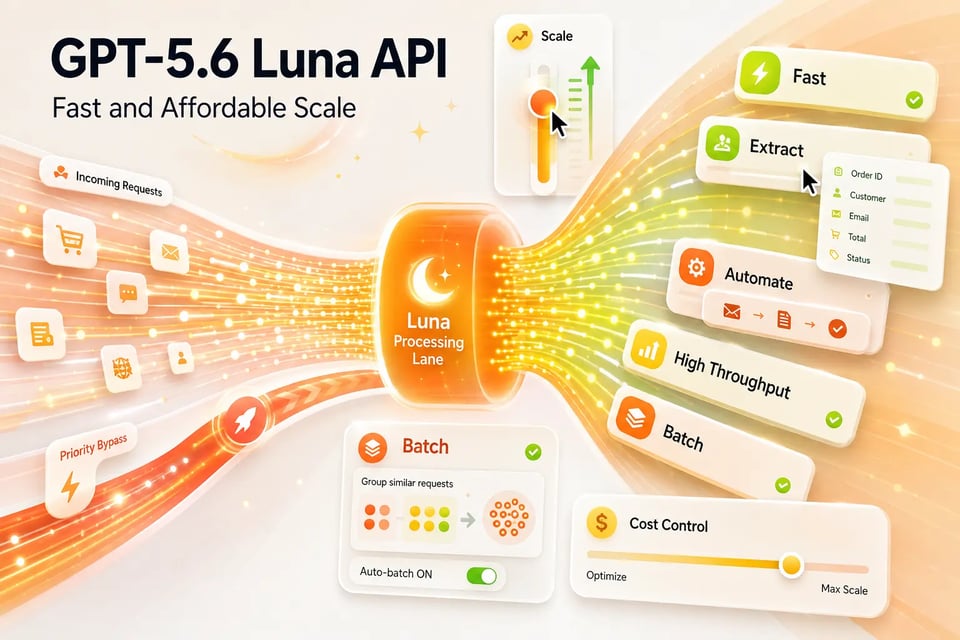
GPT-5.6 Luna API 是该系列中速度最快、最经济的层级,为处理高频请求或海量用户的应用提供了高效的基础。它非常适合响应式助手、信息提取、分类、内容处理、轻量级自动化等对延迟、吞吐量和成本控制有严格要求的可扩展功能。 若还需要根据文字提示快速批量生成日常视觉素材,可使用 GPT Image 2.5 API on Kie.ai。
GPT-5.6 API 旨在让每个 Token 发挥更大价值,在处理复杂任务时,有效减少冗余输出、模型调用往返及中间处理环节。程序化工具调用(Programmatic Tool Calling)支持基于内存的轻量级程序协调多种工具,不仅能过滤海量结果、保留关键信息,还能在工作推进时决定下一步行动。Max 设置可扩展推理预算,用于更深度的探索与验证;而 Ultra 模式则能协调并行智能体(Agents),在应对高要求请求时更快交付更出色的结果。请查阅最新 Kie.ai API 文档,了解支持的推理级别、工具调用选项及请求参数。
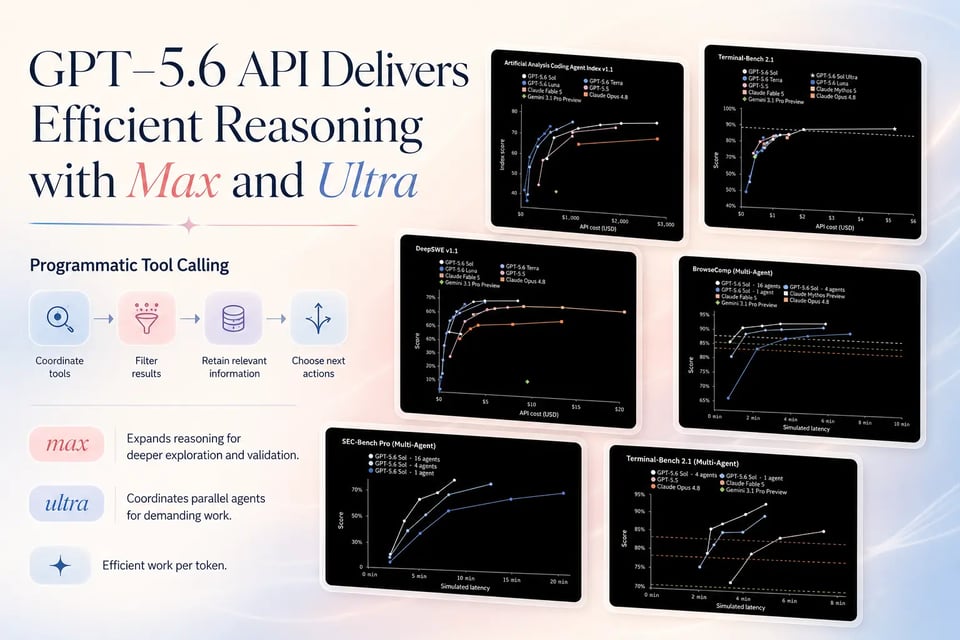
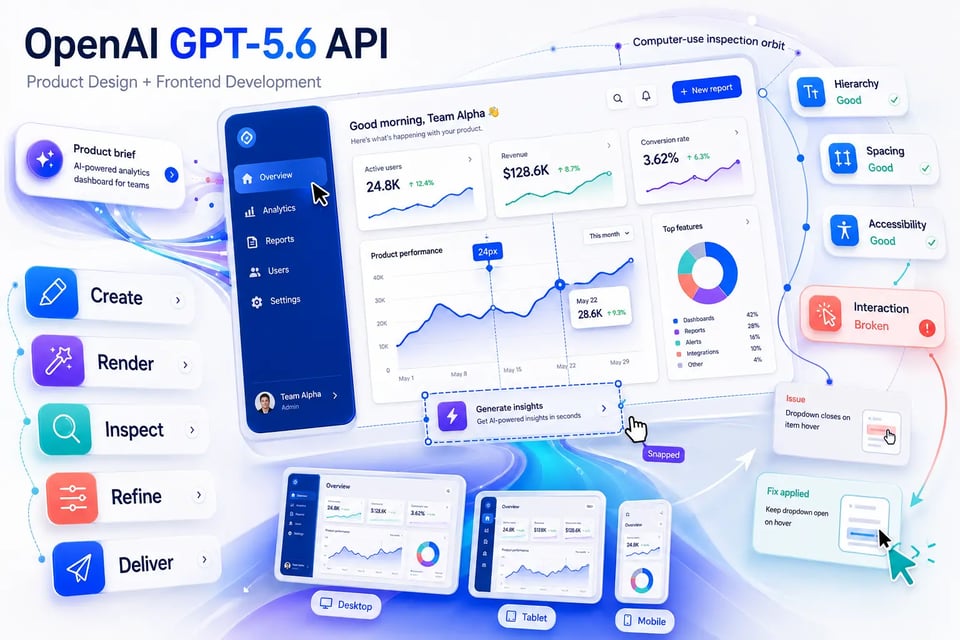
除了生成代码或内容,OpenAI GPT-5.6 API 还能检查渲染结果,评估最终体验的实际视觉与交互表现。其提升的计算机操作能力有助于精准识别层级不清、间距不一、导航混乱、交互失效及视觉细节未完善等问题。通过这一额外的检查与优化闭环,可生成连贯性更强、功能更完善且达到生产级标准的界面、可视化图表与交互产出。
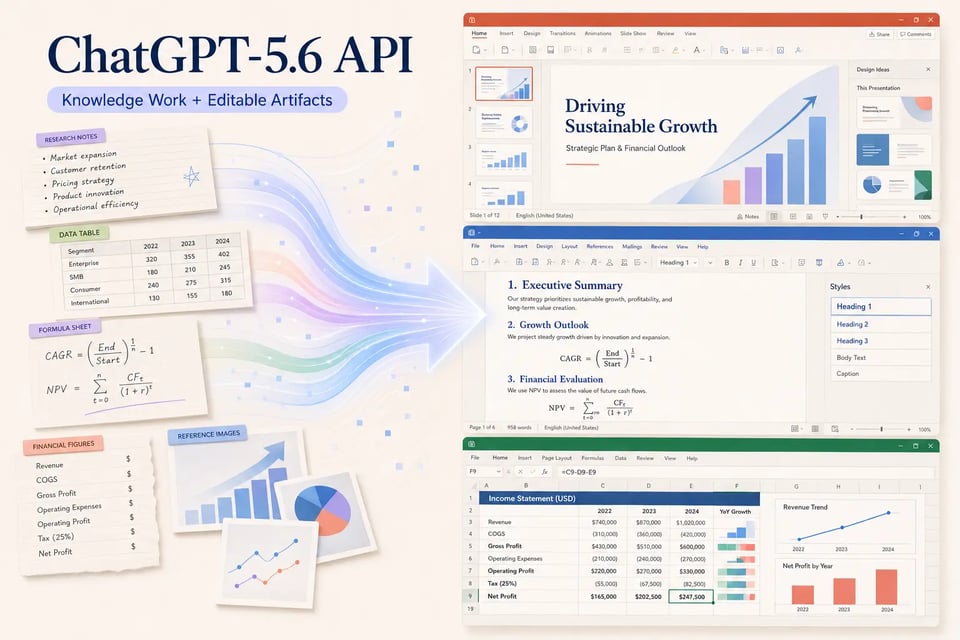
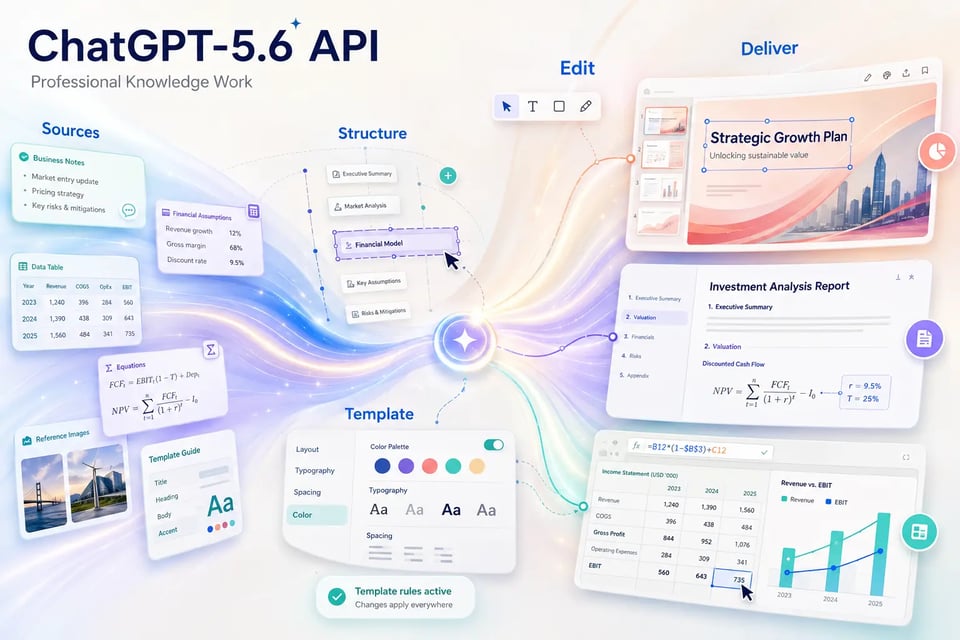
在专业内容输出方面,ChatGPT-5.6 API 强化了从碎片化素材到最终可编辑交付物的完整工作流。演示文稿的叙事结构更加清晰,版式更具一致性;文档与电子表格在排版、公式排版、财务逻辑、格式化及信息层级处理上表现更佳。同时,凭借更出色的模板理解能力,ChatGPT-5.6 API 能够更加精准地保留原有的重复版式、间距规范、色彩搭配、幻灯片母版规则以及参考文件规范。
作为前沿级模型,GPT-5.6 Sol API 在网络安全、生命科学、化学、定量生物学及内部 AI 研究等领域实现了重大能力飞跃。更强的长程推理能力显著提升了漏洞分析、安全代码评估、科学解析、研究调试、内核优化、实验执行与训练系统分析的表现。这些能力的提升也得到了其在 ExploitBench、GeneBench Pro、LifeSciBench 以及 OpenAI 内部研究评估中更高基准测试成绩的印证。

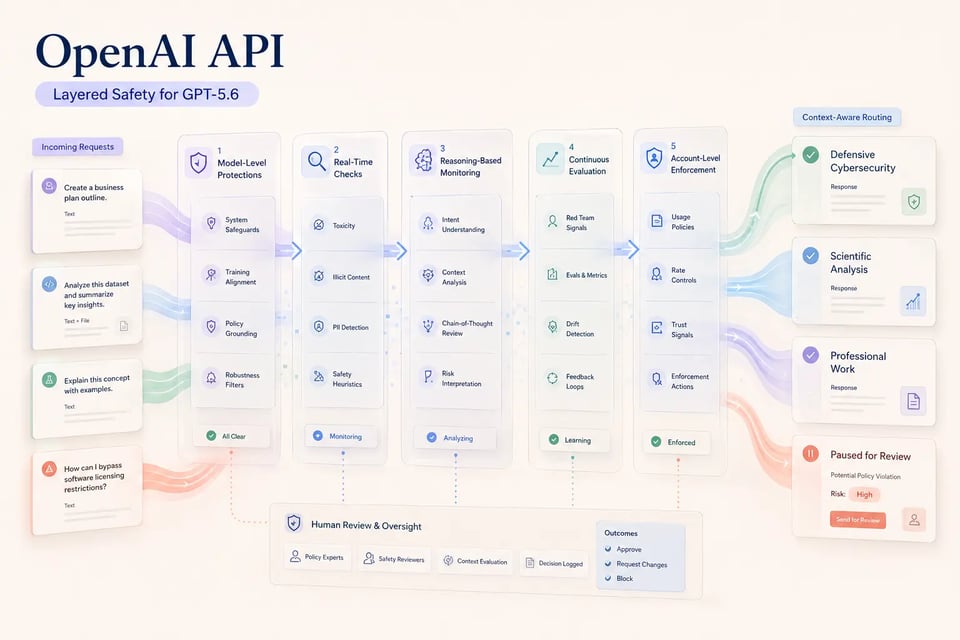
随着模型能力的提升,OpenAI API 针对各层级 GPT-5.6 的优势与风险,部署了经过精准校准的分层安全防护系统。模型内置的防护机制与实时检测、基于推理的监控、持续评估及账户级管控协同运作。敏感功能将受到更严格的访问控制,同时确保合法的防御、科研及专业工作在安全防护下顺畅进行,这些防护机制在设计上注重结合上下文,而非仅依赖基础的分类器拦截。
GPT-5.6 Sol、Terra 与 Luna 专为平衡不同的能力、速度与运行成本而设计。Sol 在复杂推理、代码编写、计算机操作、网络安全及科学研究等领域领跑全系;Terra 以较低的成本保持了强悍的性能;Luna 则为高频任务提供了最快、最实惠的选择。以下基准测试结果及价格均来自 OpenAI 的正式发布版本。所列价格为 OpenAI 官方费率而非 Kie.ai 定价,实际的性能表现、延迟及 Token 消耗可能会因推理级别、工具调用、提示词设计和任务复杂度而有所不同。
| 对比维度 | GPT-5.6 Sol | GPT-5.6 Terra | GPT-5.6 Luna |
|---|---|---|---|
| Official Positioning | Flagship frontier model | Balanced lower-cost model for everyday work | Fastest and most affordable model |
| Capability Direction | Maximum intelligence and efficiency | Strong performance with practical cost efficiency | Fast execution for high-volume workloads |
| Core Strengths | Advanced coding, knowledge work, computer use, cybersecurity, science, and complex reasoning | Everyday coding, analysis, professional work, and balanced production tasks | Frequent requests, scalable processing, and cost-sensitive workloads |
| Agents’ Last Exam | 52.70% | 50.40% | 50.30% |
| Artificial Analysis Coding Agent Index v1.1 | GPT-5.6 的发布时间是什么时候? | 77.4 | 74.6 |
| SWE-Bench Pro | 64.60% | 63.40% | 62.70% |
| Terminal-Bench 2.1 | 88.80% | 87.40% | 84.70% |
| BrowseComp | 90.40% | 87.50% | 83.30% |
| OSWorld 2.0 | 62.60% | 50.20% | 45.60% |
| SEC-Bench Pro | 71.20% | 57.70% | 48.90% |
| GeneBench Pro | 28.70% | 23.30% | 10.80% |
| MRCR v2, 256K–512K | 91.50% | 89.60% | 41.30% |
| OpenAI Official Input Price | $5 per 1M tokens | $2.50 per 1M tokens | $1 per 1M tokens |
| OpenAI Official Output Price | $30 per 1M tokens | $15 per 1M tokens | $6 per 1M tokens |
GPT-5.6 Sol 在专业推理、智能体编程、终端操作、网页浏览、数学及通用智能领域均展现出强大的竞争力,而非仅针对单一评估类别进行优化。以下对比数据源自 OpenAI 正式发布版的公开结果。破折号表示该模型在对应评估中未报告成绩,而实际表现可能因推理算力、工具、提示词及评估设置的不同而有所差异。GPT-5.6 Sol 在 Agents’ Last Exam、Coding Agent Index、DeepSWE、Terminal-Bench 2.1、BrowseComp、GPQA Diamond 和 FrontierMath Tier 1–3 等评估中处于领先地位。而在 SWE-Bench Pro、GDPval-AA v2 及 Toolathlon 等特定评估中,Claude 模型依然保持优势,这表明在选择模型时应考量具体任务,而非仅依赖单一的汇总评分。
| 评估维度 | 基准测试 | GPT-5.6 Sol | GPT-5.5 | Claude Mythos 5 | Claude Fable 5 | Claude Opus 4.8 | Gemini 3.1 Pro Preview |
|---|---|---|---|---|---|---|---|
| Professional Work | Agents’ Last Exam | 52.70% | 46.90% | — | 40.50% | 45.20% | 32.10% |
| Professional Work | GDPval-AA v2 | 1,747.8 Elo | 1,493.7 Elo | — | 1,759.6 Elo | 1,600.1 Elo | 962.3 Elo |
| General Intelligence | Artificial Analysis Intelligence Index v4.1 | 58.9 | 54.8 | — | 59.9 | 55.7 | 46.5 |
| Agentic Coding | Artificial Analysis Coding Agent Index v1.1 | GPT-5.6 的发布时间是什么时候? | 76.4 | — | 77.2 | 72.5 | 42.7 |
| Software Engineering | SWE-Bench Pro | 64.60% | 59.40% | 80.30% | 80.00% | 69.20% | 54.20% |
| Long-Horizon Engineering | DeepSWE v1.1 | 72.70% | 67.00% | — | 69.70% | 59.00% | 11.80% |
| Terminal Coding | Terminal-Bench 2.1 | 88.80% | 85.60% | 88.00% | 83.10% | 78.90% | 70.70% |
| Agentic Browsing | BrowseComp | 90.40% | 84.40% | 88.00% | — | 84.30% | 85.90% |
| Scientific Reasoning | GPQA Diamond | 94.60% | 93.60% | 94.10% | 92.60% | 92.00% | 94.30% |
| Advanced Mathematics | FrontierMath Tier 1–3 v2 | 89.00% | 85.30% | — | 87.00% | 80.00% | 59.60% |
| Tool Use | Toolathlon | 58.00% | 55.60% | 61.70% | 61.70% | 59.90% | 48.80% |
Kie.ai 提供了从初始模型测试到生产环境部署的直接路径。开发者可以创建 API 密钥,对比 Sol、Terra 和 Luna,使用真实输入验证提示词,并将所选层级集成到应用程序中。在配置请求参数前,请查阅最新的 Kie.ai 文档,以了解支持的模型、推理级别、输入格式、工具、频率限制及响应结构。
GPT-5.6 现已超越基础对话,全面扩展至融合推理、编程、工具调用、计算机操作、视觉检查及可编辑产物生成的多阶段复杂任务。Sol 适合最严苛的任务,而 Terra 和 Luna 则让相同的生成能力在平衡的生产工作负载与高并发请求中更具实用性。
软件团队可将 GPT-5.6 API 应用于执行规划、代码库级调试、重构、测试、终端操作及长周期工程任务。编程式工具调用有助于编码智能体协调各项工具、过滤中间结果、监控进度并选择下一步操作,而无需将每次工具响应都发送进行另一次完整的模型往返交互。
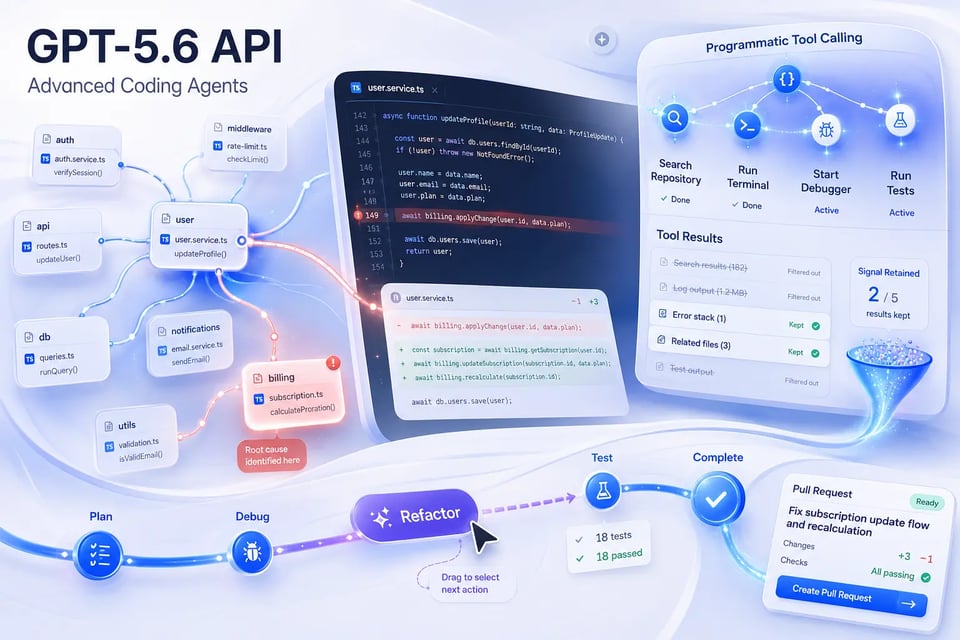
仅凭一份宏观的产品简报,OpenAI GPT-5.6 API 即可生成精美的界面、交互式演示、数据可视化视图及功能原型。得益于更强大的计算机操作能力,模型能够在交付最终成果前,自动检查渲染效果,精准识别视觉与功能缺陷,并对间距、视觉层级、导航及交互体验进行精细调优。
专业团队可借助 ChatGPT-5.6 API,将碎片化文档与业务上下文高效转化为结构化的演示文稿、报告、电子表格及其他可编辑的交付物。凭借更出色的模板理解能力,模型能在可重复的企业日常工作中,精准保留原有布局、排版、间距、配色、复用内容模式、数学公式及财务逻辑。
在安全与科研环境中,OpenAI API 全面支持漏洞分析、安全代码审查、补丁验证、威胁建模,以及基因组学、生命科学、化学和定量生物学研究。此外,GPT-5.6 还能有效辅助 AI 开发工作,涵盖诊断科研系统故障、优化底层内核与训练策略、执行实验、解读数据结果,并通过迭代分析持续改进技术系统。

Kie.ai 将 GPT-5.6 Sol、Terra 和 Luna 整合至专为开发者打造的平台中,让模型层级对比、测试真实场景请求、集成管理及生产成本控制变得更加轻松。从初期评估到长期部署,开发者可直接获取实用文档、灵活的模型选项、快速响应的技术支持及其他 OpenAI 模型,无需维护多套独立的接入路径。
Kie.ai 帮助开发者将模型成本与请求的实际难度精准匹配。复杂的任务可调用 GPT-5.6 Sol API,平衡的生产任务可交由 Terra 处理,而高频的轻量级请求可通过 Luna 运行。这使得产品在保持卓越输出质量的同时,无需为每次交互承担旗舰级模型的成本。
清晰的文档涵盖了身份验证、请求构建、支持的模型、推理控制、响应处理、工具选项及常见集成需求。开发者可在接入前查阅最新的 Kie.ai API 文档,确保请求逻辑与当前支持的参数及平台更新保持一致。
在构建完整的应用之前,Kie.ai Playground 提供了一个实用的测试环境,方便团队测试提示词(Prompts)并对比 Sol、Terra 和 Luna 模型。团队可基于真实输入评估响应质量、输出格式、推理行为、延迟及 Token 消耗,从而减少后期不必要的开发调整。
接入完整的 GPT-5.6 系列模型,让模型对比与基于任务的路由更加直观。开发者可将高要求的任务分配给 Sol,将日常重复性请求交给 Terra,将大规模处理任务交由 Luna,并在同一平台对整体集成进行统一管理。
产品无需一次性将所有请求迁移至最新一代模型。Kie.ai 在提供 GPT-5.6 的同时,还支持其他 OpenAI 模型,为开发者在受控迁移、降级处理、对比测试,以及根据不同任务类别调用不同模型时提供极大的灵活性。
在身份验证、测试、部署或生产监控过程中可能会遇到技术问题。Kie.ai 提供全天候持续支持,协助开发者解决接入问题、排查 API 的异常行为,确保由 GPT-5.6 驱动的应用程序始终稳定可靠地运行。