Automatically append previous messages to maintain multi-turn context. May increase token usage.
How can I help you today?
README
Complete guide to using gpt-6-2-astra
GPT-6.2 Astra API para engenharia complexa, ciência e trabalho profissional

curl https://api.kie.ai/codex/v1/responses \-H "Authorization: Bearer $KIE_API_KEY" \-H "Content-Type: application/json" \-d '{"model": "gpt-6-2-astra","input": "Design an idempotent webhook handler for payment retries.","reasoning": { "effort": "medium" },"stream": false}'
Principais recursos do GPT-6.2 Astra


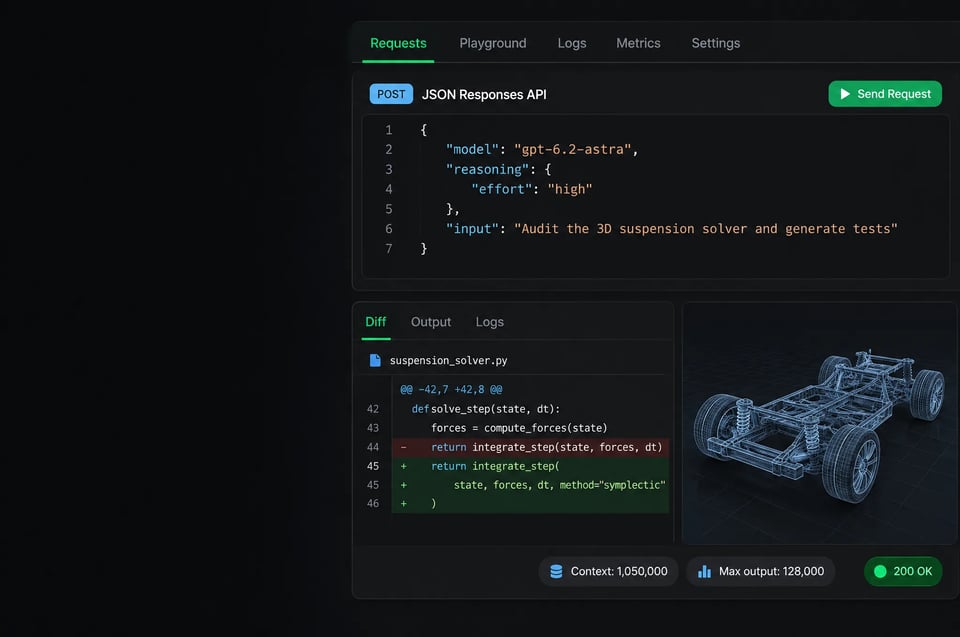
Código mais limpo, front-ends web e design 3D

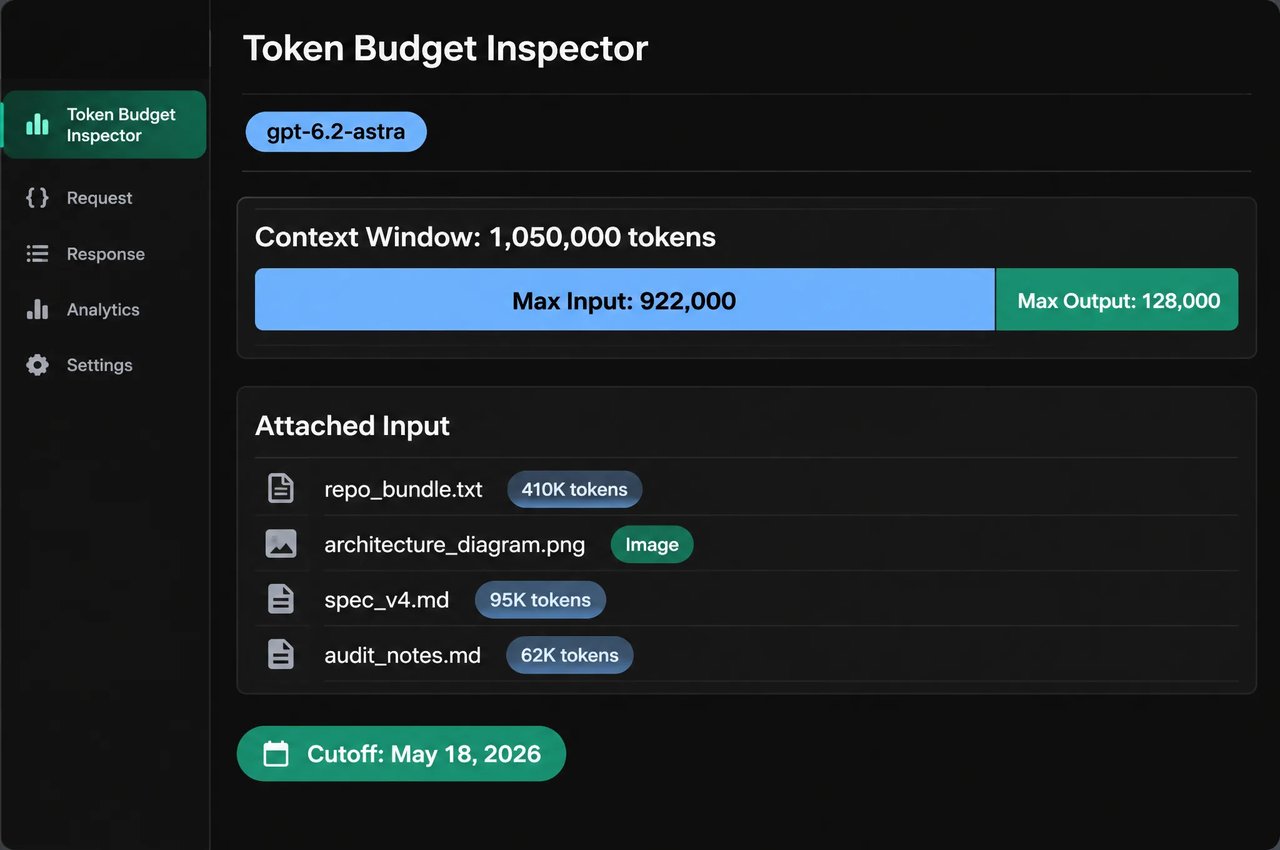
Contexto de 1.050.000 tokens e até 128.000 tokens de saída

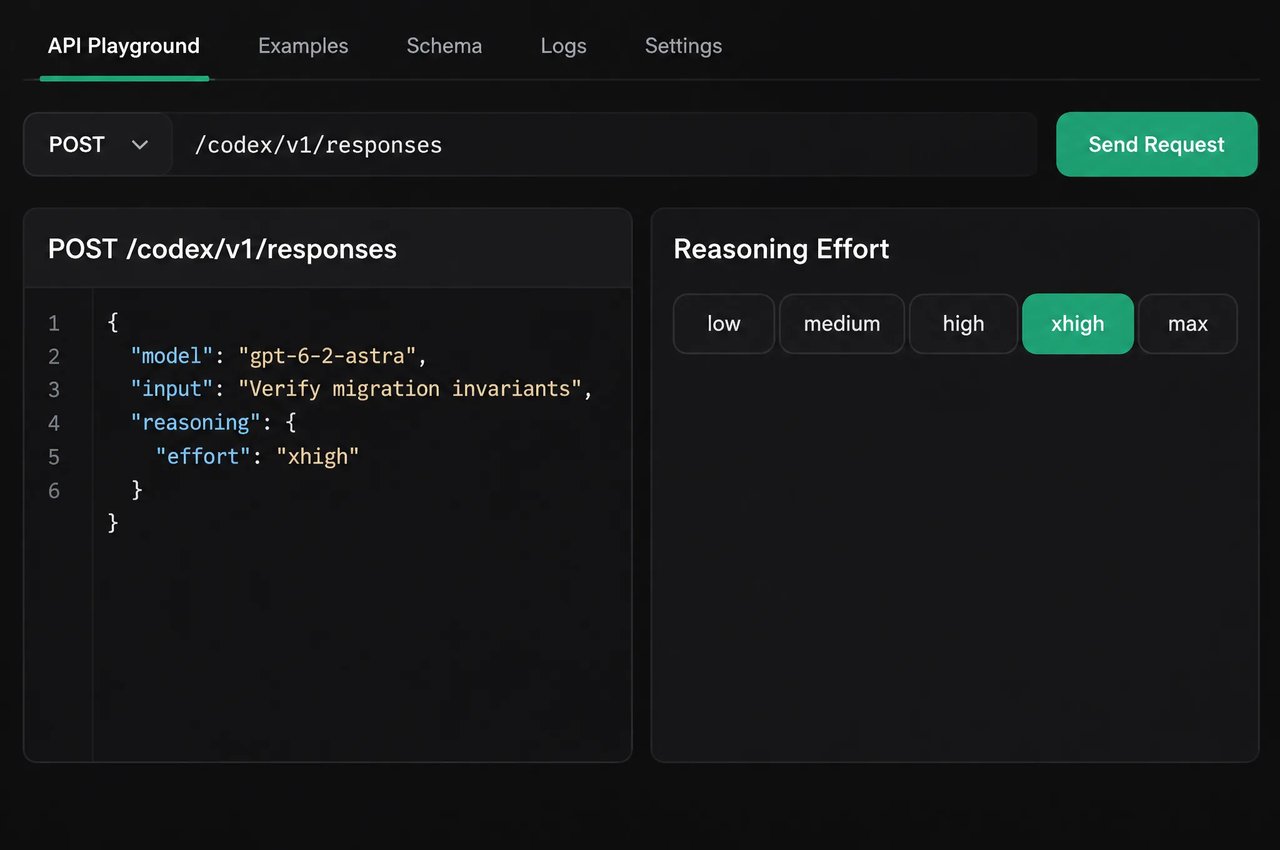
Cinco níveis de esforço de raciocínio, de low a max

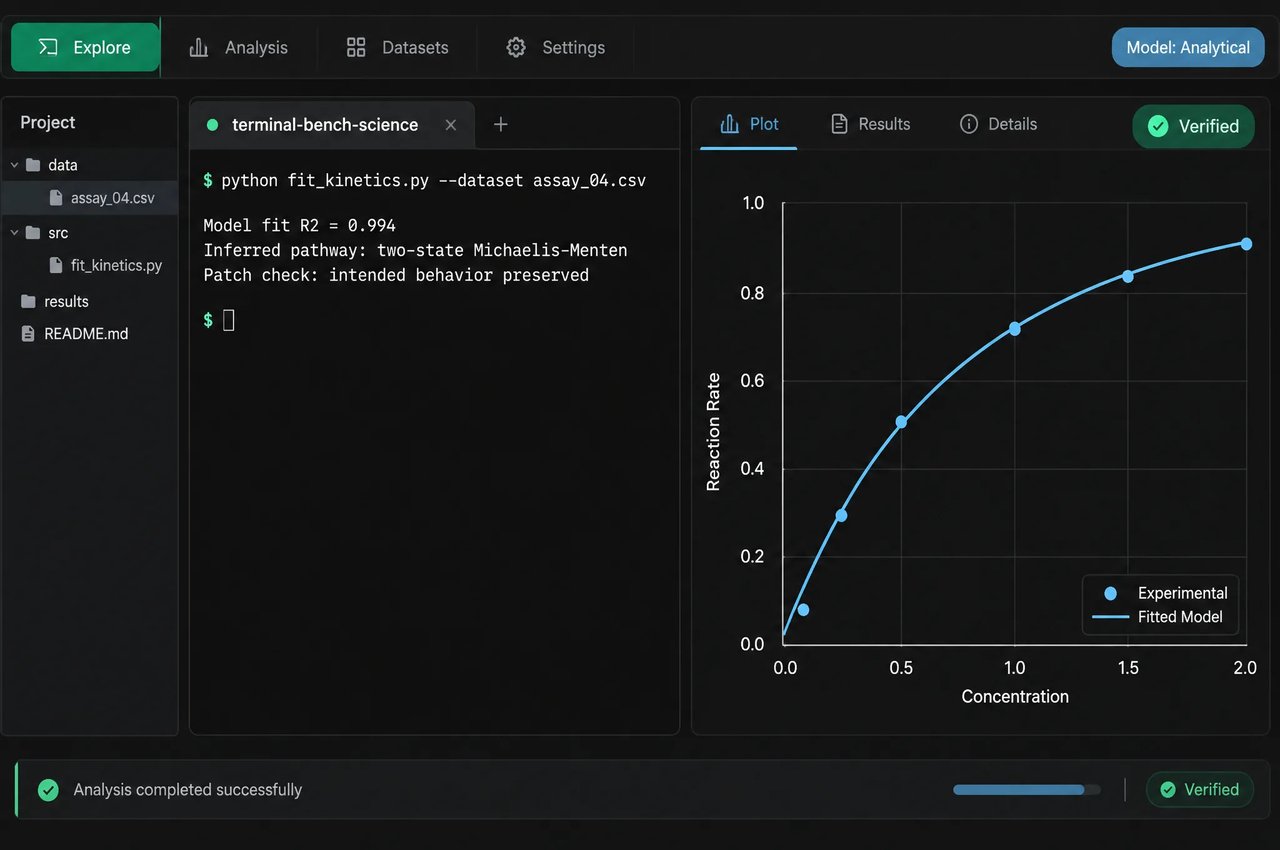
Pesquisa científica e segurança defensiva

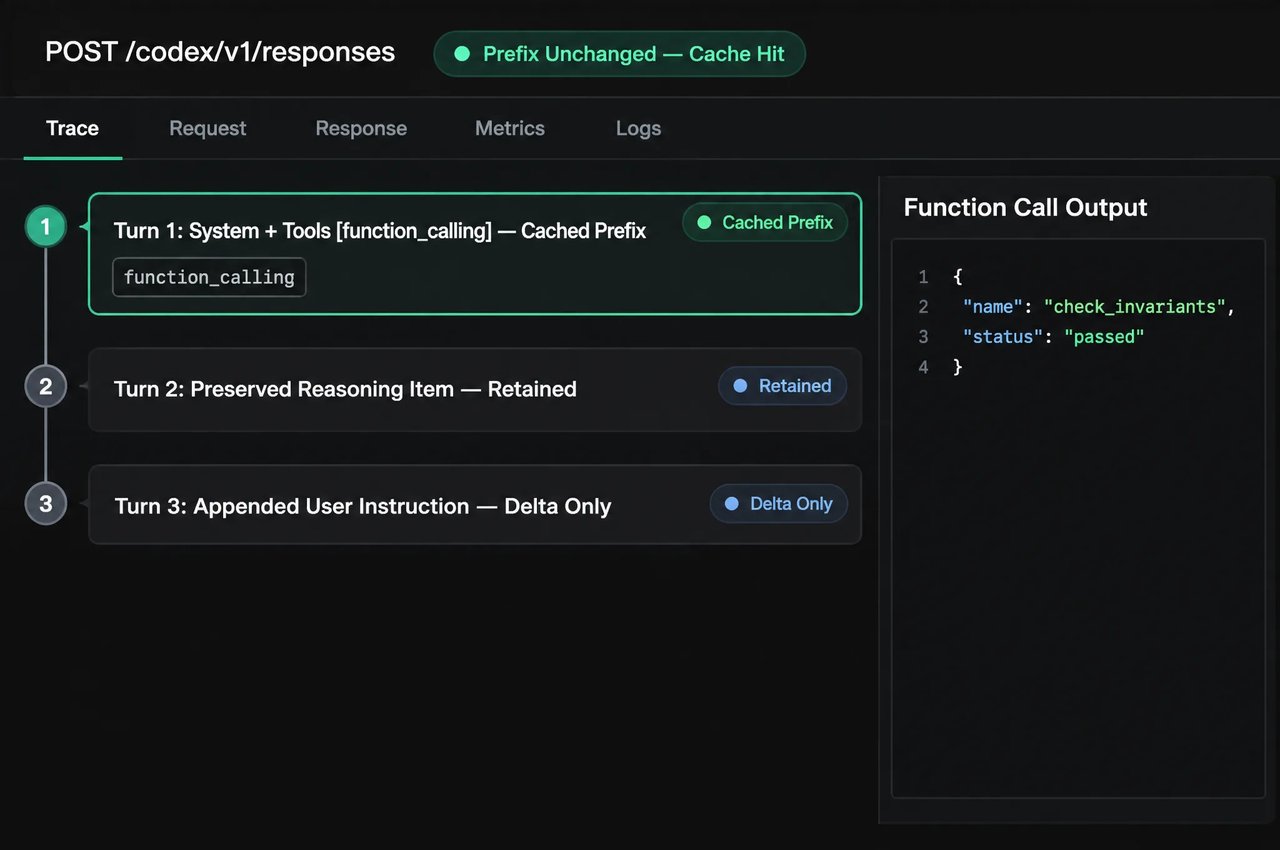
Ferramentas da Responses API e raciocínio preservado
Especificações do GPT-6.2 Astra
Especificações do GPT-6.2 Astra da documentação da OpenAI, junto com os detalhes do endpoint no Kie.ai.
| Specification | GPT-6.2 Astra |
|---|---|
| Developer | OpenAI |
| ID do modelo | gpt-6-2-astra no Kie.ai (gpt-6.2-astra também é aceito) |
| Data de lançamento | 17 de novembro de 2026 |
| Modalities | Entrada de texto e imagem; saída de texto (áudio e vídeo não suportados) |
| Janela de contexto | 1.050.000 tokens (até 922.000 tokens de entrada) |
| Máximo de tokens de saída | 128.000 tokens |
| Esforço de raciocínio | low, medium, high, xhigh, max |
| Endpoint e ferramentas no Kie.ai | POST /codex/v1/responses; custom function calling or web_search (one per request); text, input_image and input_file |
| Recursos no Kie.ai | Streaming (padrão), chamada de função ou busca na web (uma por requisição), entrada de imagem e arquivo, cache de prompt |
| Parâmetros e recursos não suportados | Parâmetros: temperature, top_p, logprobs, top_logprobs; recursos: ajuste fino, saídas previstas |
| Data-limite do conhecimento | 18 de maio de 2026 |
Destaques de benchmark do GPT-6.2 Astra
Resultados de avaliação relatados pela OpenAI em seu anúncio de lançamento de 17 de novembro de 2026, nas publicações de lançamento e no Cartão do Sistema.
| Benchmark | Resultado do GPT-6.2 Astra | O que mede |
|---|---|---|
| Agents' Last Exam | +5,2 pontos em relação ao GPT-6 Astra (novo recorde) | Fluxos de trabalho profissionais de longo horizonte com múltiplas etapas |
| Terminal-Bench-Science 0.1 | +9 pontos percentuais em relação ao GPT-6 Astra (novo recorde) | Trabalho científico realizado em um terminal |
| GDPval v2 | +6,2 pontos percentuais em relação ao GPT-6 Astra com 22% menos tokens de saída | Tarefas de consultoria, finanças e design com múltiplas etapas |
| AA-AnalystAgent | 62,5% das perguntas respondidas corretamente em todas as 5 tentativas independentes (novo recorde) | Análise financeira e de despesas em planilhas e relatórios reais |
| AA-3D | 1.318 Elo, em primeiro lugar (GPT-6.2 Sol: 1.259 Elo) | Preferência humana em avaliações às cegas de aplicações 3D interativas no navegador |
| BenchCAD 2.1 Core | 32% de melhoria em relação ao GPT-6 Astra | Building 3D: criação de peças e conjuntos a partir de desenhos de engenharia |
| Avaliações de cibersegurança | Alvos do Cartão do Sistema: 36,4% resolvidos vs. 18,2% do GPT-6 Astra; ExploitBench Internal Port: +22 pontos em relação ao GPT-6 Astra | Avaliações de segurança separadas relatadas pela OpenAI |
Como trabalhar com o GPT-6.2 Astra
- 1
Etapa 1: escolha entre o GPT-6.2 Astra e o GPT-6.2 Sol
Use o GPT-6.2 Astra para seus projetos mais difíceis em engenharia, pesquisa científica, entregas profissionais, front-ends e design 3D. Para programação no dia a dia, a OpenAI recomenda começar com o GPT-6.2 Sol, seu modelo eficiente e versátil para o trabalho cotidiano. - 2
Etapa 2: defina o esforço de raciocínio de low a max
No Kie.ai, passe reasoning.effort como low, medium, high, xhigh ou max em /codex/v1/responses. A OpenAI recomenda começar com medium em uma nova integração, ou alterar as configurações legadas none e minimal para low. Omita temperature, top_p, logprobs e top_logprobs. - 3
Etapa 3: mantenha os prefixos de prompt inalterados
A partir do GPT-6.2, a API da OpenAI descarta itens de raciocínio quando detecta edições de prefixo no meio da conversa (como alterações nas instruções ou chamadas de ferramentas), um rebaixamento de modelo ou uma alteração no usuário final ou na organização. A OpenAI recomenda manter os prefixos de prompt inalterados e anexar novas instruções para ajudar a preservar o raciocínio entre turnos e manter a entrada anterior elegível para cache de prompt. - 4
Etapa 4: chame /codex/v1/responses para ferramentas e entradas multimodais
No Kie.ai, envie requisições para POST /codex/v1/responses com definições de funções personalizadas ou {"type":"web_search"} (escolha um tipo de ferramenta por requisição). O modelo Because GPT-6.2 Astra escreve de forma mais concisa e direta por padrão; por isso, revise os prompts de sistema legados que repetem instruções para "ser conciso".