Automatically append previous messages to maintain multi-turn context. May increase token usage.
How can I help you today?
README
Complete guide to using deepseek-v4-1-flash
API DeepSeek V4.1 Flash para Chat Multimodal
A DeepSeek projetou o V4.1 Flash para oferecer maior capacidade, inferência mais rápida e maior taxa de transferência: um modelo MoE de 552B de parâmetros que usa apenas 8B de parâmetros ativos para entrada e 16B para saída, lê imagens e textos nativamente e, segundo a ficha do modelo, suporta contextos de até um milhão de tokens. A atualização de 17 de outubro, DeepSeek V4.1 Flash 1017, mantém o mesmo nome do modelo e formato de requisição. No Kie.ai, você chama a API DeepSeek 4.1 Flash no endpoint /openai/v1/responses compatível com o OpenAI Responses.
Parâmetros da API DeepSeek V4.1 Flash no Kie.ai
| Parameter | Value |
|---|---|
| Model | deepseek-v4-1-flash |
| Endpoint | POST /openai/v1/responses, compatible with the OpenAI Responses API |
| Janela de contexto | Até 1M de tokens (ficha do modelo da DeepSeek no Hugging Face) |
| Tipos de entrada | Texto e imagens (partes input_text e input_image em uma única mensagem); a saída é texto |
| Thinking | Ativado por padrão; reasoning.effort aceita none, minimal, low, medium, high, xhigh e max (none desativa o pensamento) |
| Tools | Apenas ferramentas de função; tool_choice auto (padrão), required ou uma função nomeada |
| Saída estruturada | text.format json_object ou json_schema |
| Streaming | stream true ou false |
| Não suportado | max_output_tokens, temperature e top_p não têm efeito neste modelo |
| Architecture | MoE de 552B de parâmetros, Codificador-Decodificador Causal, 8B de parâmetros ativos para entrada e 16B para saída (DeepSeek) |
Principais Recursos da API DeepSeek V4.1 Flash
Compreensão Nativa de Imagens
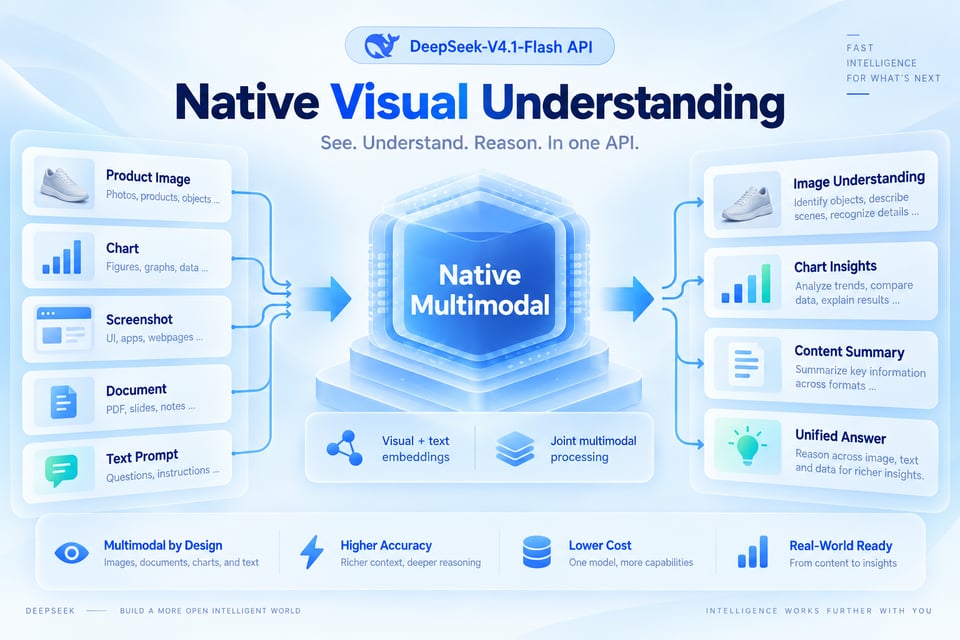
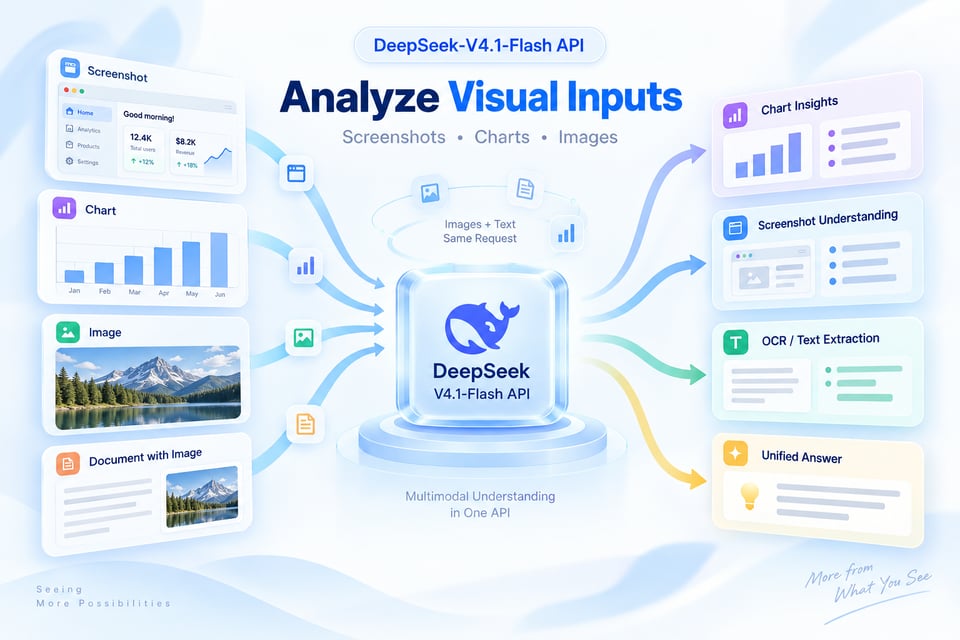
O DeepSeek V4.1 Flash processa imagens e textos nativamente. Combine partes input_image e input_text em uma única mensagem; image_url aceita uma URL acessível publicamente ou uma string base64 data:image. Em nosso teste no Kie.ai, ele leu com exatidão o título em uma imagem de banner e identificou o sol brilhante na figura.
Arquitetura MoE Efficient 552B
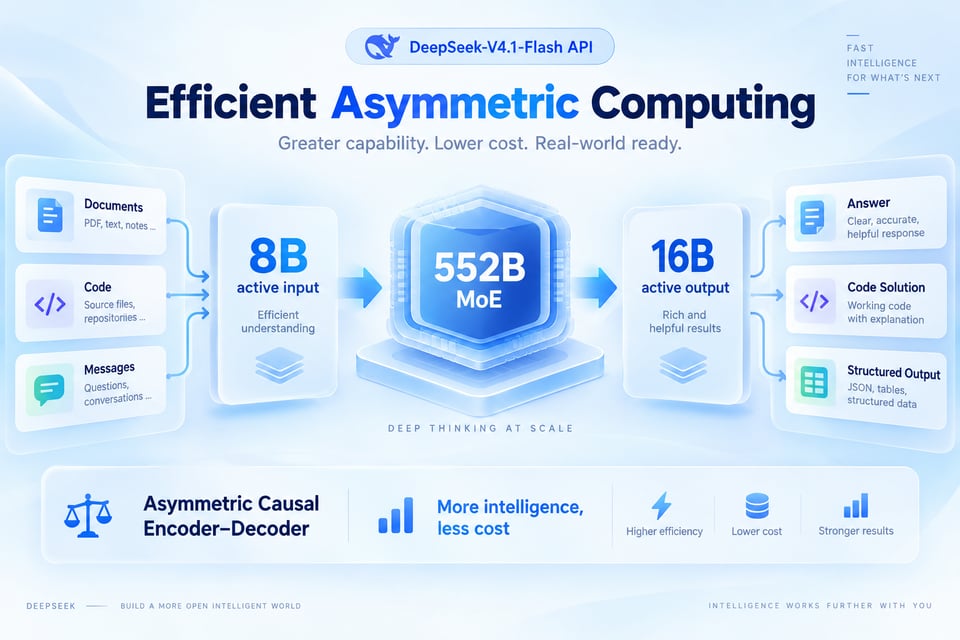
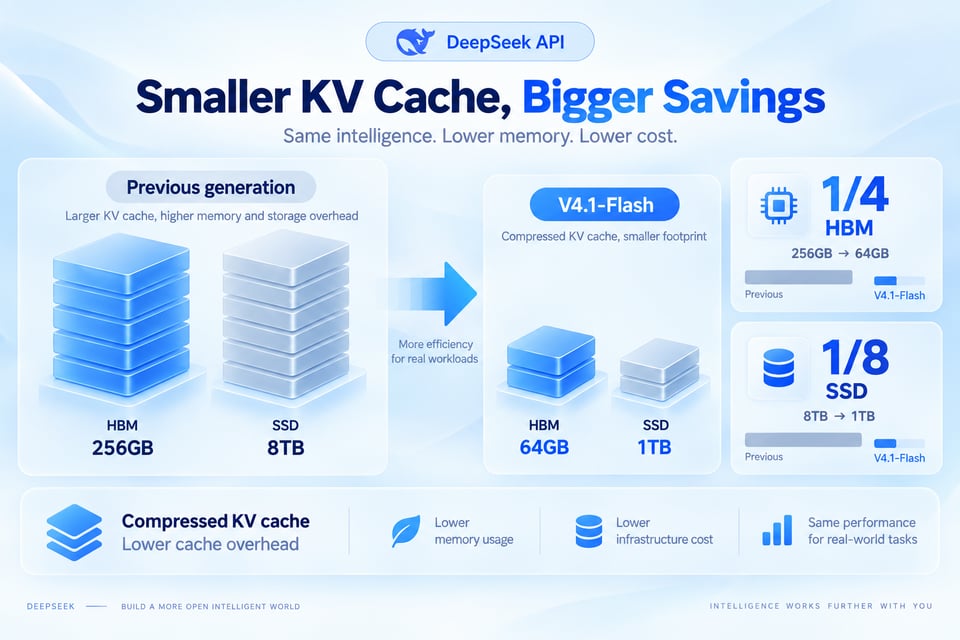
A DeepSeek descreve o V4.1 Flash como o menor modelo de sua nova família de arquiteturas: um modelo de Mistura de Especialistas de 552B de parâmetros em uma arquitetura de Codificador-Decodificador Causal que usa apenas 8B de parâmetros ativos para entrada e 16B para saída. A DeepSeek relata um cache KV que requer 1/4 da HBM e 1/8 do armazenamento SSD da geração anterior.
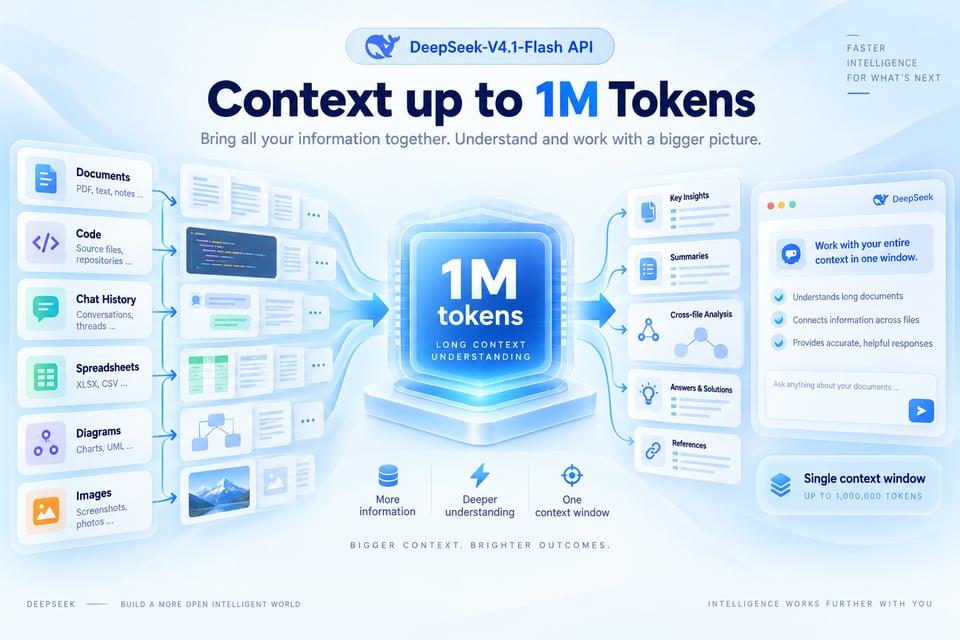
Até 1M de Tokens de Contexto
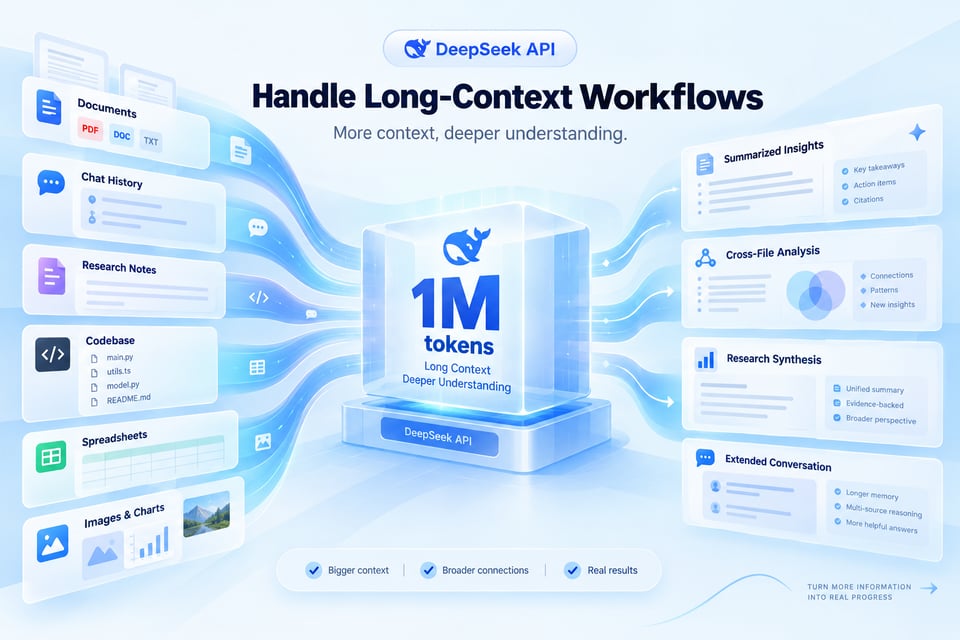
Segundo a ficha do modelo da DeepSeek, o V4.1 Flash lida com contextos de até um milhão de tokens, o que deixa espaço para documentos longos e grandes bases de código. A documentação do Kie.ai não lista um limite de contexto separado para este modelo.
Pensamento que Você Pode Aumentar ou Desativar
O modelo pensa por padrão. Defina reasoning.effort como none para desativar o pensamento, minimal para mantê-lo breve, ou low, medium, high, xhigh ou max para um raciocínio mais profundo.
Ferramentas de Função e Saída JSON
Declare ferramentas de função e deixe o modelo escolher com tool_choice auto, exija uma chamada ou fixe uma função nomeada; envie os resultados de volta como function_call_output vinculados por call_id. Defina text.format como json_object ou json_schema para obter uma saída que seu código possa analisar.
A Atualização 1017, Mesma Integração
O DeepSeek V4.1 Flash 1017, lançado em 17 de outubro de 2026, traz o que a DeepSeek chama de desempenho superior em benchmarks, conclusão de tarefas mais rápida e saídas mais curtas do que a versão anterior. O nome do modelo, o endpoint e o formato de requisição permanecem inalterados, portanto as integrações existentes continuam funcionando.
Resultados de Benchmark do DeepSeek V4.1 Flash 1017 vs a Versão Anterior
Resultados divulgados pela DeepSeek em sua ficha do modelo no Hugging Face para a atualização 1017. O Terminal-Bench 4.0 foi executado com a estrutura de teste do Claude Code e o DeepSWE v1.1 com a estrutura de teste do Mini-SWE-V2.
| Benchmark | V4.1 Flash 1017 | V4.1 Flash Anterior |
|---|---|---|
| HLE (sem ferramentas) | 42.6 | 36.8 |
| Terminal-Bench 4.0 | 42.3 | 31.2 |
| DeepSWE v1.1 | 77.0 | 74.2 |
| ProgramBench | 29.1 | 20.3 |
| NL2Repo-Bench | 68.2 | 65.4 |
| Apex Bench v1.1 | 72.1 | 64.6 |
| Chartography (com ferramentas) | 83.0 | 78.9 |
| BabyVision (com ferramentas) | 92.5 | 89.6 |
Como usar a API DeepSeek V4.1 Flash no Kie.ai
Passo 1. Obtenha sua chave de API
Passo 2. Envie uma requisição
Passo 3. Adicione imagens, ferramentas e saída JSON
Por que usar a API DeepSeek V4.1 Flash no Kie.ai
A mesma chave em todo o marketplace do Kie.ai
Todos os modelos no mercado do Kie.ai usam o mesmo método de autenticação: um cabeçalho Authorization: Bearer YOUR_API_KEY com a chave da sua página de Gerenciamento de Chaves de API do Kie.ai.
Créditos gratuitos e saldo único
Novos usuários do Kie.ai recebem 80 créditos gratuitos para testes. Sua conta tem um saldo de créditos único usado por todos os serviços de geração, e você pode consultá-lo com a API Get Remaining Credits.
Nada para hospedar ou instalar
O Kie.ai disponibiliza este modelo como uma API com um ambiente de testes; não há aplicativo para baixar ou instalar. Não há GPUs nem pesos de modelo para gerenciar.
O que você pode criar com a API DeepSeek V4.1 Flash
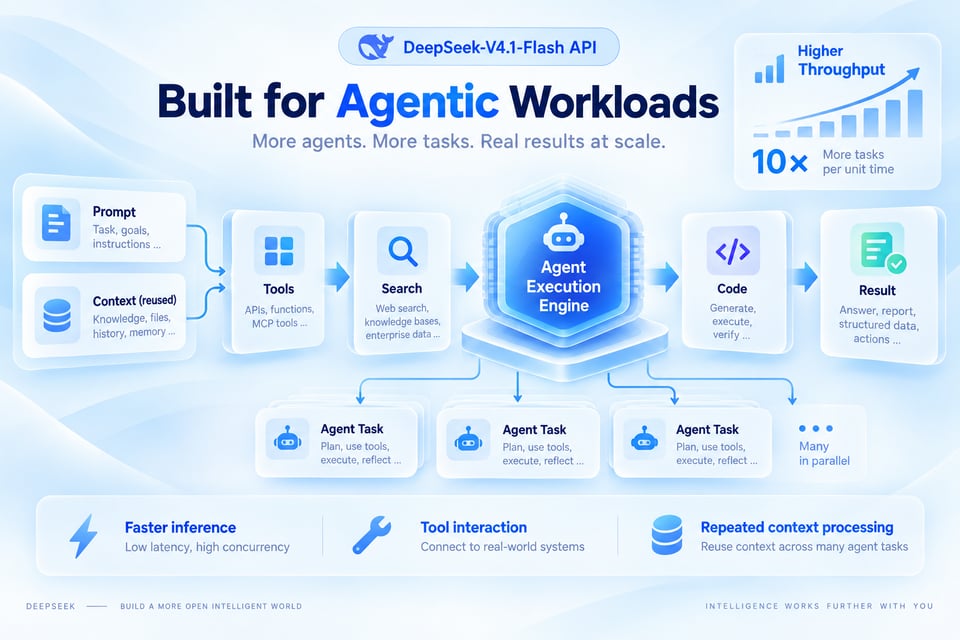
A DeepSeek projetou o V4.1 Flash para inferência mais rápida e maior taxa de processamento. Para um modelo maior de pesos abertos com janela de contexto de 1 milhão de tokens no mesmo endpoint, confira a API Kimi K3.1 Pro.
Chat e perguntas e respostas sobre imagens
Responda a perguntas sobre capturas de tela, gráficos, banners e fotos junto com texto na mesma mensagem.
Perguntas sobre documentos longos e bases de código
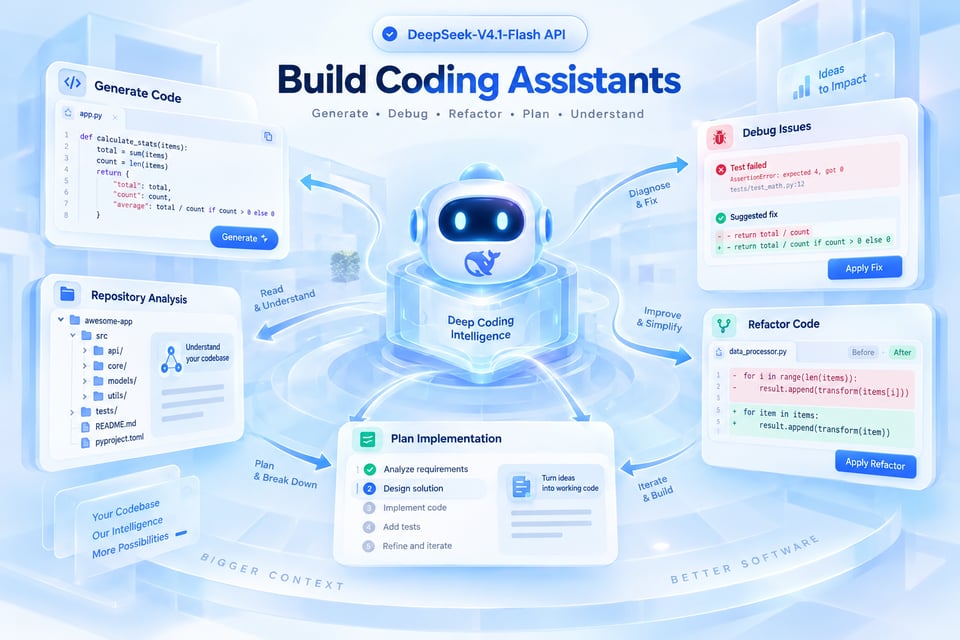
Analise documentos longos ou grandes bases de código em uma única requisição; a ficha do modelo da DeepSeek indica contextos de até um milhão de tokens.
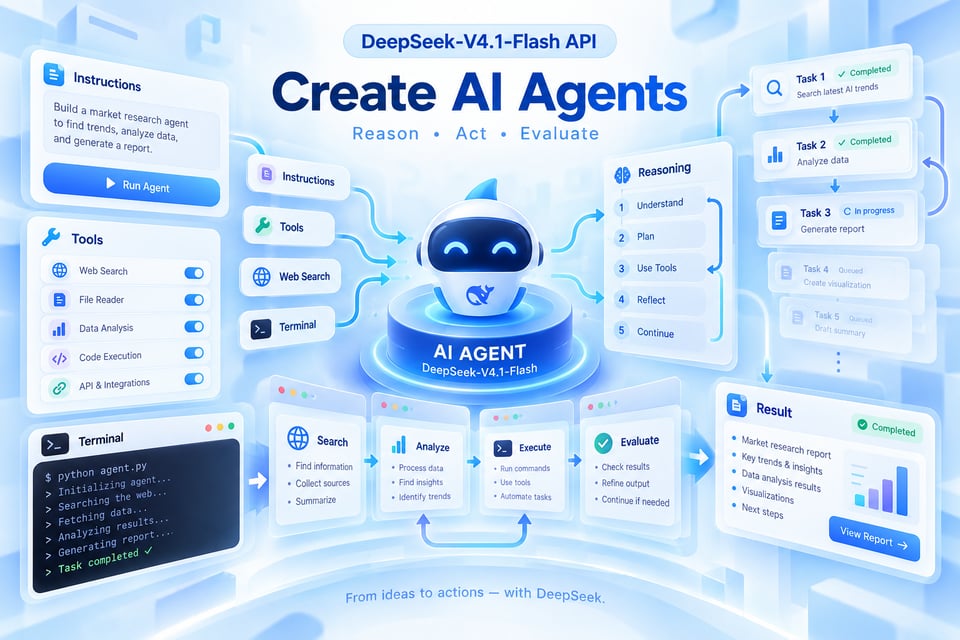
Extração estruturada
Extraia campos de textos ou imagens para um JSON que segue o seu esquema usando text.format json_schema.
Recursos de chat de alto volume
Alimente recursos de chat em que a taxa de processamento é essencial, com o pensamento reduzido ou desativado para requisições simples.