Automatically append previous messages to maintain multi-turn context. May increase token usage.
How can I help you today?
README
Complete guide to using gpt-6-2-sol
GPT-6.2 Sol API para Programação do Dia a Dia e Fluxos de Trabalho Multietapas com Agentes

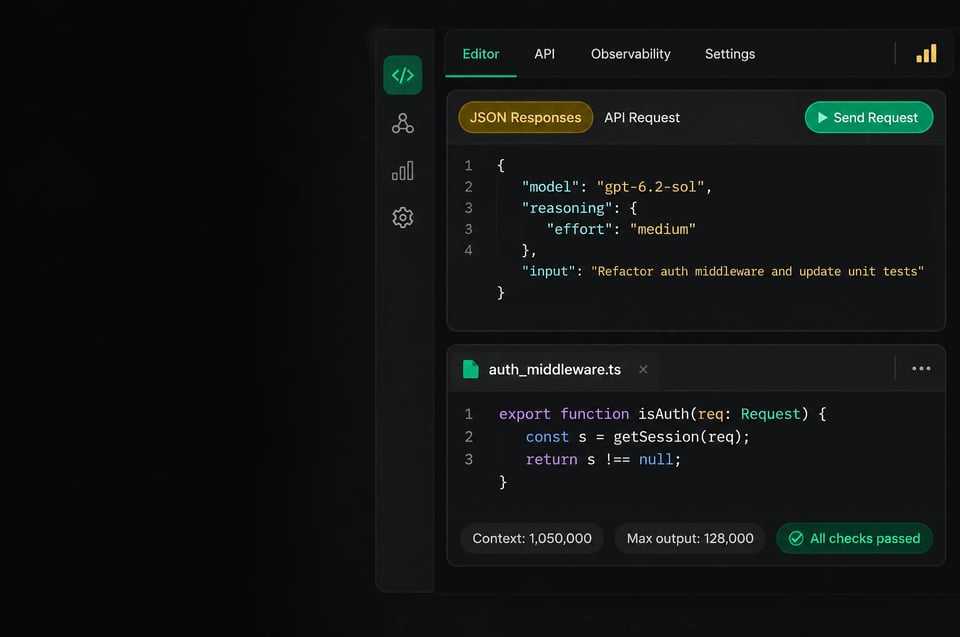
curl https://api.kie.ai/codex/v1/responses \-H "Authorization: Bearer $KIE_API_KEY" \-H "Content-Type: application/json" \-d '{"model": "gpt-6-2-sol","input": "Compare blue-green and canary rollouts for a stateless API.","reasoning": { "effort": "medium" },"stream": false}'
Principais Recursos do GPT-6.2 Sol


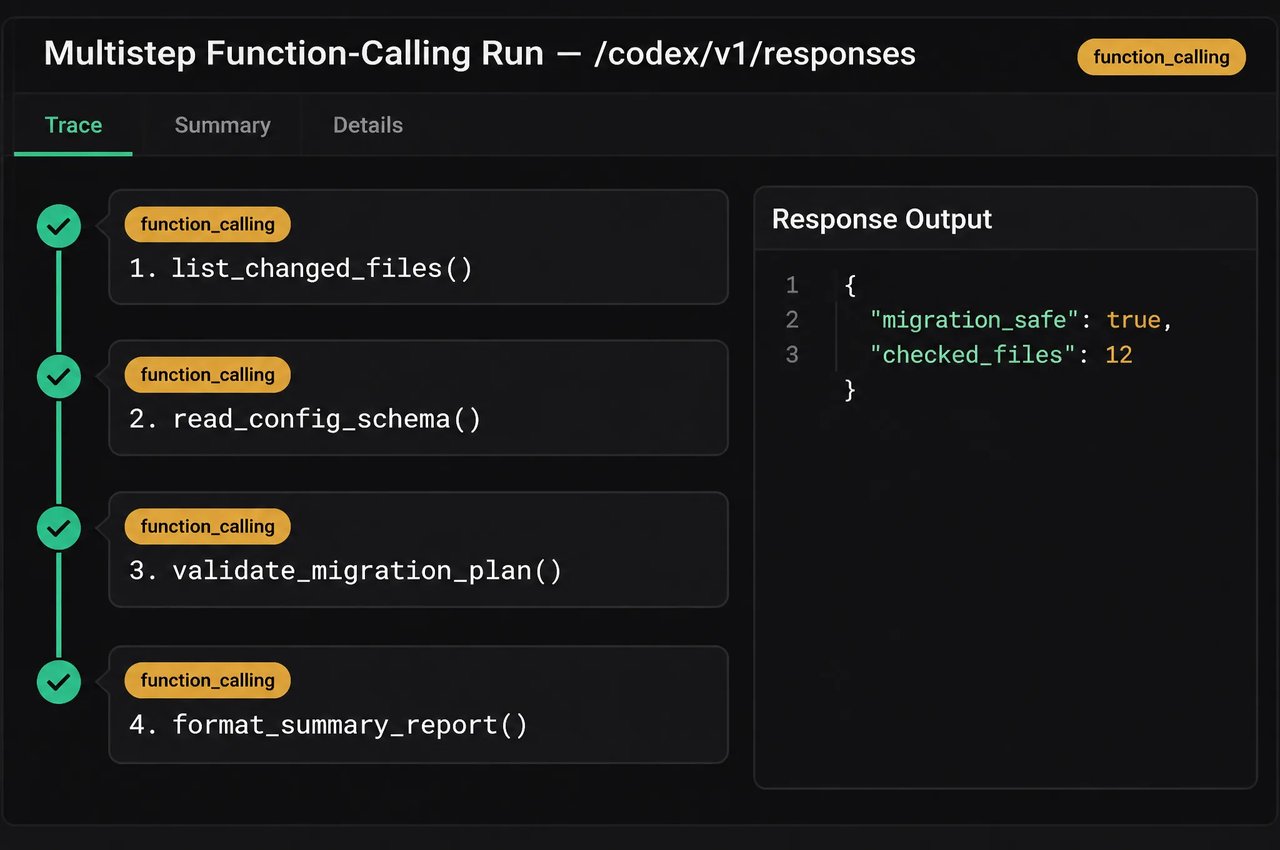
Fluxos de Trabalho Multietapas com Agentes e Chamada de Ferramentas

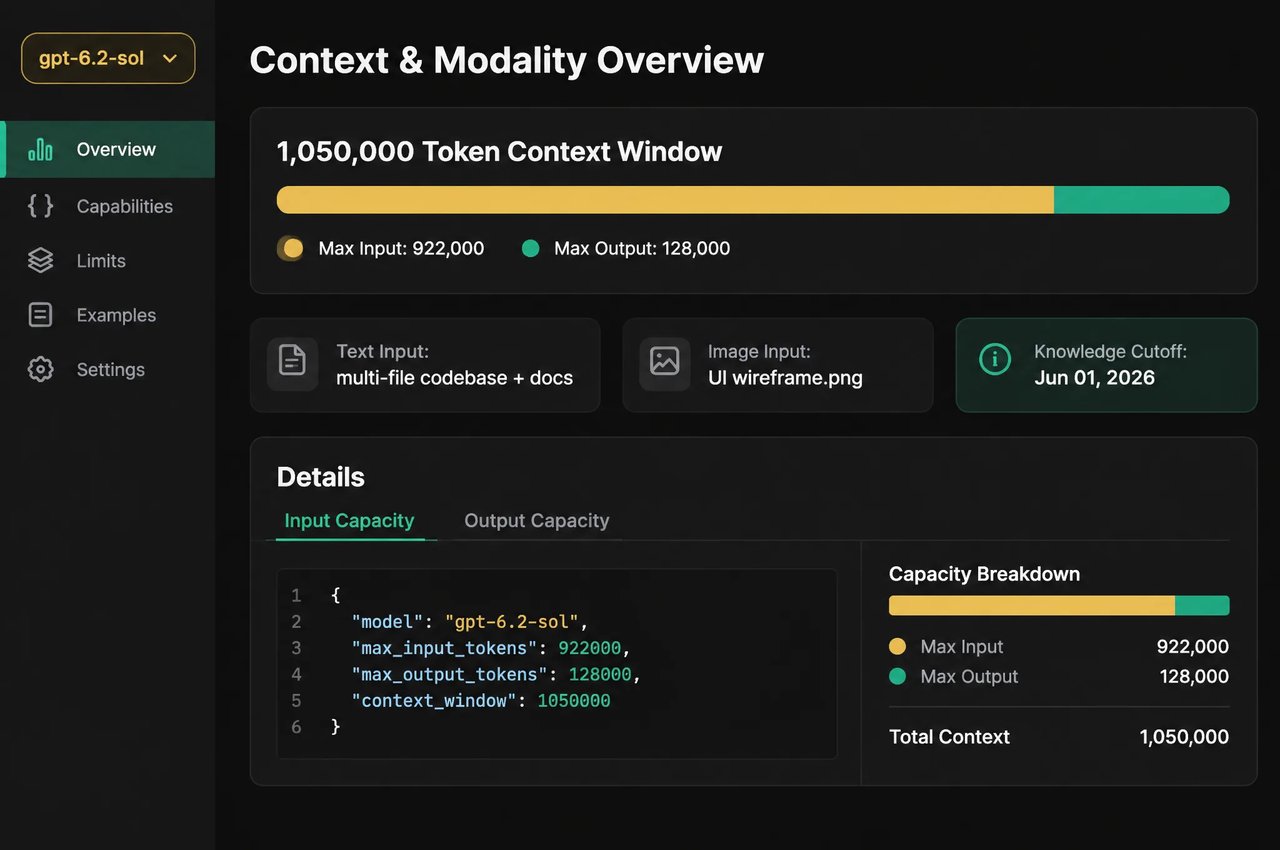
Contexto de 1.050.000 Tokens e Corte de Junho de 2026

Escrita Clara, Natural e Tarefas do Dia a Dia

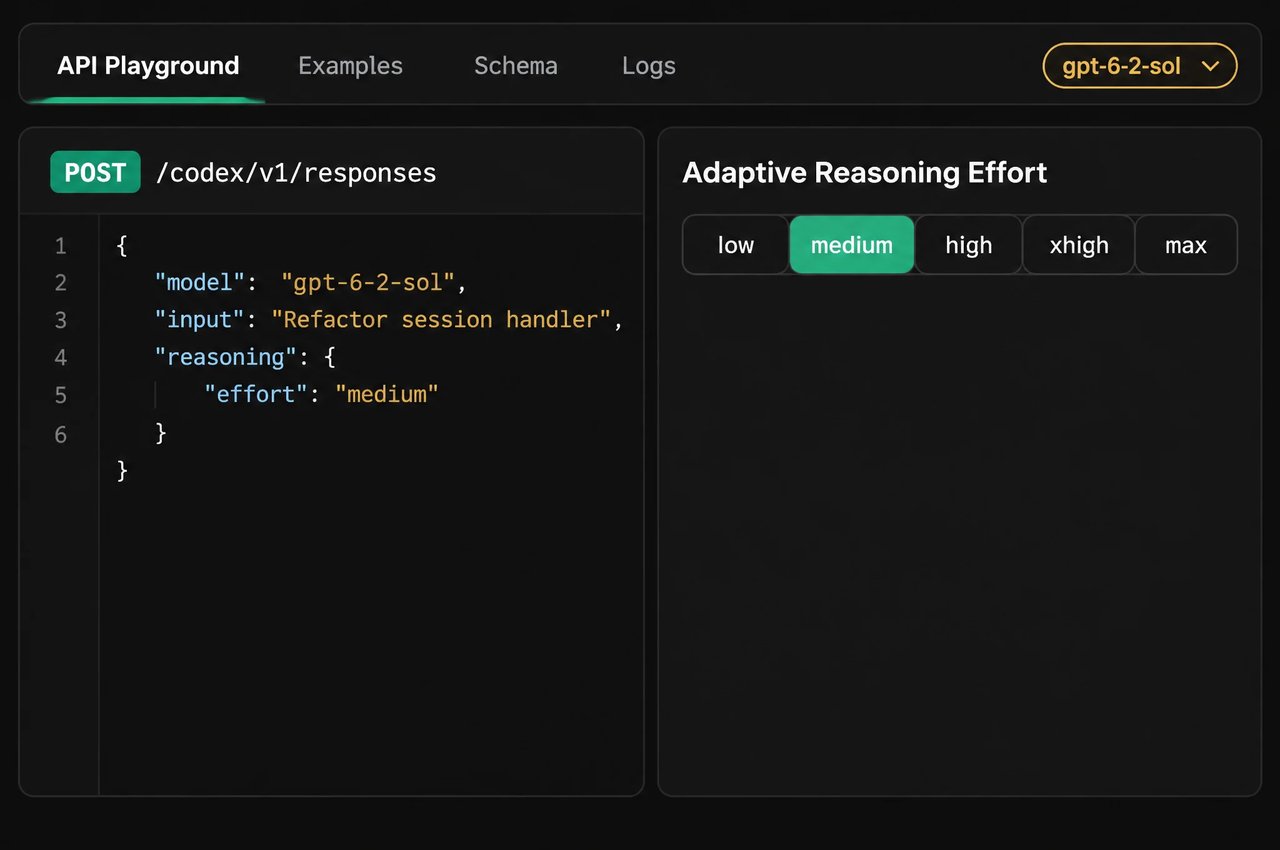
Raciocínio Adaptativo de low a max

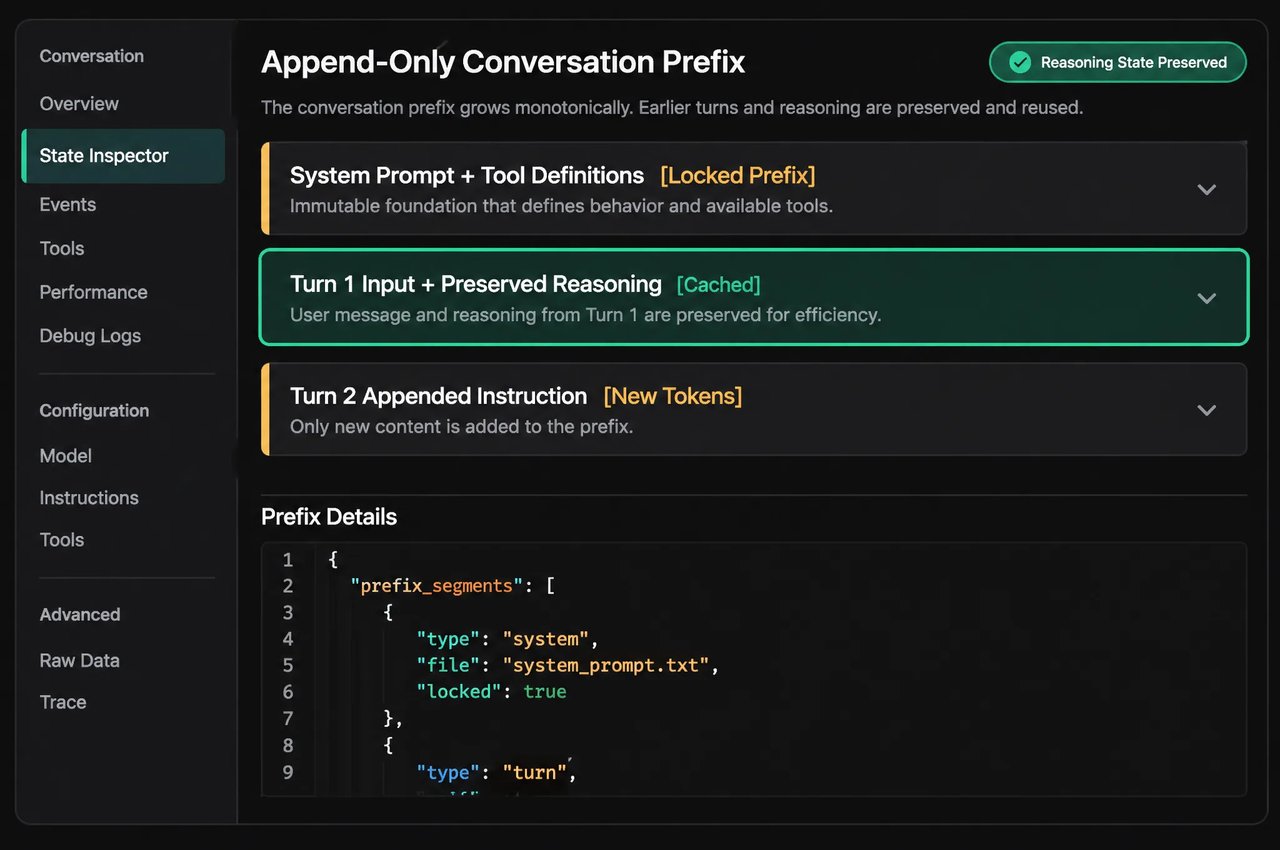
Raciocínio Preservado e Cache de Prompts
Especificações do GPT-6.2 Sol
Especificações do GPT-6.2 Sol da documentação da OpenAI, juntamente com detalhes do endpoint do Kie.ai.
| Specification | GPT-6.2 Sol |
|---|---|
| Developer | OpenAI |
| ID do Modelo | gpt-6-2-sol no Kie.ai (gpt-6.2-sol também aceito) |
| Data de lançamento | 17 de novembro de 2026 |
| Modalities | Entrada de texto e imagem; saída de texto (áudio e vídeo não suportados) |
| Janela de contexto | 1.050.000 tokens (até 922.000 tokens de entrada) |
| Máximo de tokens de saída | 128.000 tokens |
| Esforço de raciocínio | low, medium, high, xhigh, max |
| Endpoint e ferramentas do Kie.ai | POST /codex/v1/responses; custom function calling or web_search (one per request); text, input_image and input_file |
| Recursos do Kie.ai | Streaming (padrão), chamada de função ou pesquisa na web (uma por solicitação), entrada de imagem e arquivo, cache de prompts |
| Parâmetros e recursos não compatíveis | Parâmetros: temperature, top_p, logprobs, top_logprobs; recursos: ajuste fino, saídas previstas |
| Data de corte do conhecimento | 1º de junho de 2026 |
Destaques da avaliação do GPT-6.2 Sol
Resultados de avaliação divulgados pela OpenAI no anúncio de lançamento de 17 de novembro de 2026, nas publicações de lançamento e no System Card.
| Benchmark | Resultado do GPT-6.2 Sol | O que mede |
|---|---|---|
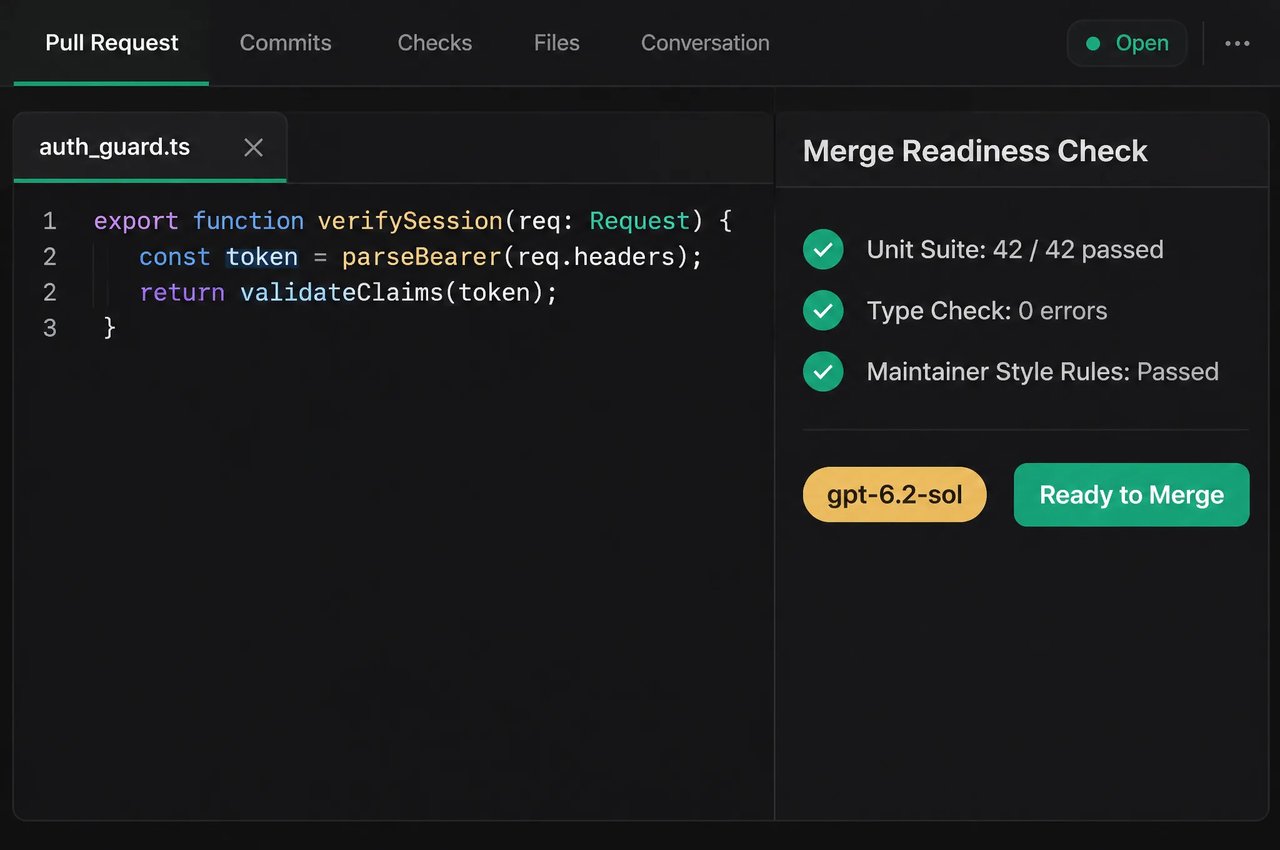
| FrontierCode 2.0 (com esforço max) | A no máximo 0,5 ponto do GPT-6.2 Astra | Alterações reais em bases de código avaliadas segundo os critérios de integração dos mantenedores |
| GDPval v2 | +5,3 pontos em relação ao GPT-6.1 Sol | Tarefas de consultoria, finanças e design com várias etapas |
| LifeVal | Supera o GPT-6 Astra | Tarefas personalizadas de planejamento e tomada de decisão do dia a dia |
| AA-3D | 1.259 Elo (GPT-6.2 Astra: 1.318 Elo) | Preferência humana em avaliação cega de criações 3D interativas no navegador |
| Alvos de cibersegurança da ficha do sistema | 25,0% dos alvos resolvidos contra 11,4% do GPT-6.1 Sol | Avaliação de alvos de cibersegurança na ficha do sistema do GPT-6.2 |
Como trabalhar com o GPT-6.2 Sol
- 1
Etapa 1: Comece com o GPT-6.2 Sol e passe para o Astra quando necessário
A OpenAI recomenda começar com o GPT-6.2 Sol para a programação do dia a dia e o apresenta como seu modelo de referência para o trabalho cotidiano. Para seus projetos mais difíceis, passe para o GPT-6.2 Astra, o modelo de ponta da OpenAI. - 2
Etapa 2: Escolha o esforço de raciocínio de low a max
No Kie.ai, passe reasoning.effort como low, medium, high, xhigh ou max em /codex/v1/responses. A OpenAI recomenda começar com medium em uma nova integração ou trocar as configurações legadas none e minimal por low. Omita temperature, top_p, logprobs e top_logprobs. - 3
Etapa 3: Chame /codex/v1/responses para usar ferramentas e entradas multimodais
No Kie.ai, envie requisições para POST /codex/v1/responses com definições de funções personalizadas ou {"type":"web_search"} (escolha um tipo de ferramenta por requisição) e anexe URLs de imagens ou arquivos junto ao texto quando necessário. - 4
Etapa 4: Mantenha os prefixos de prompt inalterados entre as interações
A partir do GPT-6.2, a API da OpenAI descarta itens de raciocínio quando detecta edições de prefixo no meio da conversa (como alterações nas instruções ou nas chamadas de ferramentas), uma troca para um modelo menos avançado ou uma mudança de usuário final ou organização. A OpenAI recomenda manter os prefixos de prompt inalterados e acrescentar novas instruções ao final para ajudar a preservar o raciocínio entre as interações e manter a entrada anterior elegível para o armazenamento em cache de prompts.