Gemini 4 Hydrogen
gemini-4-hydrogen-openai

O Google descreve o Gemini 4 Hydrogen como um modelo rápido e eficiente para programação do dia a dia. Ele é adaptado do Gemini 4 Carbon e sucede o Gemini 3.8 Flash. No Kie.ai, ele atualmente suporta apenas requisições de chat.

Model Type:
Pricing: Input 120 credits / 1M tokens (≈ $0.60), Output 600 credits / 1M tokens (≈ $3.00) — both 60% below official pricing. High-tier top-ups come with bonus credits that lower the effective price by about 10%.

Automatically append previous messages to maintain multi-turn context. May increase token usage.

Function calling
Grounding with Google Search
Source:Google Search
Thinking process
Reasoning effort
Stream Response

How can I help you today?

README

Complete guide to using Gemini 4 Hydrogen

Gemini 4 Hydrogen API para programação rápida e tarefas do dia a dia

O Gemini 4 Hydrogen lê texto, imagens, vídeo, áudio e arquivos PDF e responde em texto. A entrada e a saída compartilham uma janela de contexto de até 1M tokens, e quatro níveis de pensamento, de low a xhigh, permitem equilibrar profundidade de raciocínio e velocidade.
Gemini 4 Hydrogen API para programação rápida e tarefas do dia a dia

Principais recursos do Gemini 4 Hydrogen

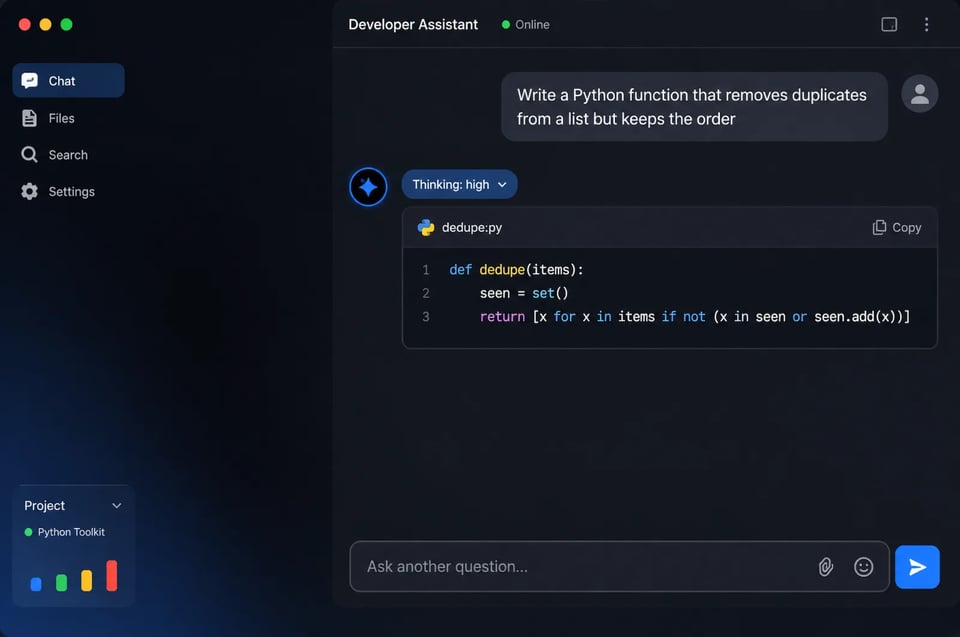
O Google posiciona o Hydrogen para execução rápida em tarefas do dia a dia, como escrever e corrigir código, responder a perguntas sobre entradas longas e resumir documentos, enquanto o Gemini 4 Carbon e o Argon cuidam do raciocínio profundo e de longo horizonte.
O modelo rápido da família Gemini 4
01

O modelo rápido da família Gemini 4

O Google posiciona o Hydrogen como o modelo rápido da família Gemini 4, projetado para execução rápida. No Artificial Analysis Intelligence Index, ele atinge 51 pontos em seu nível de pensamento padrão (high), contra 50 do Gemini 4 Argon.
Quatro níveis de pensamento até Xhigh
02

Quatro níveis de pensamento até Xhigh

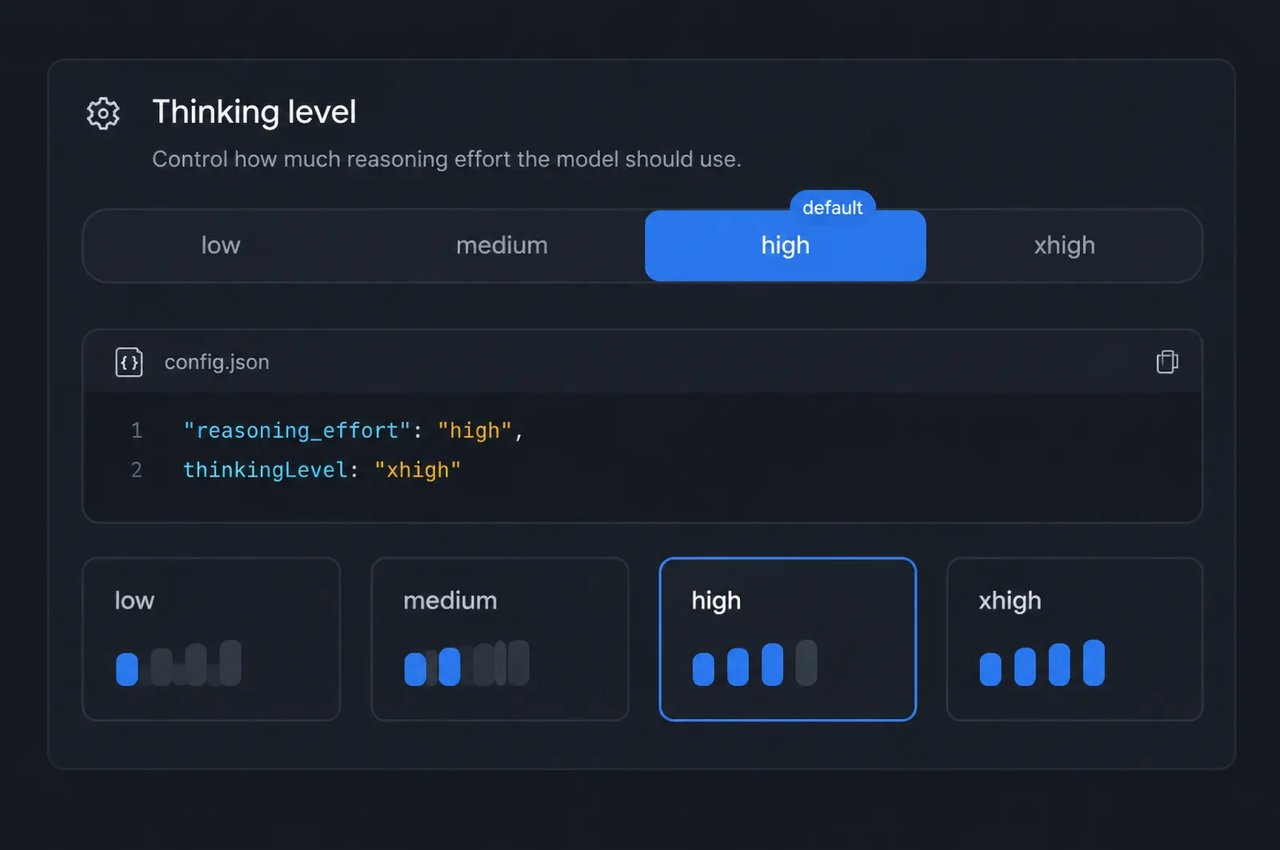
Os níveis low, medium, high e xhigh equilibram a qualidade da resposta com a latência e o uso de tokens. O padrão é high. O nível xhigh é uma novidade do Hydrogen e alcançou 54 no Artificial Analysis Intelligence Index nos resultados do Google. No Kie.ai, defina reasoning_effort ou thinkingLevel.
Janela de contexto de até 1M tokens
03

Janela de contexto de até 1M tokens

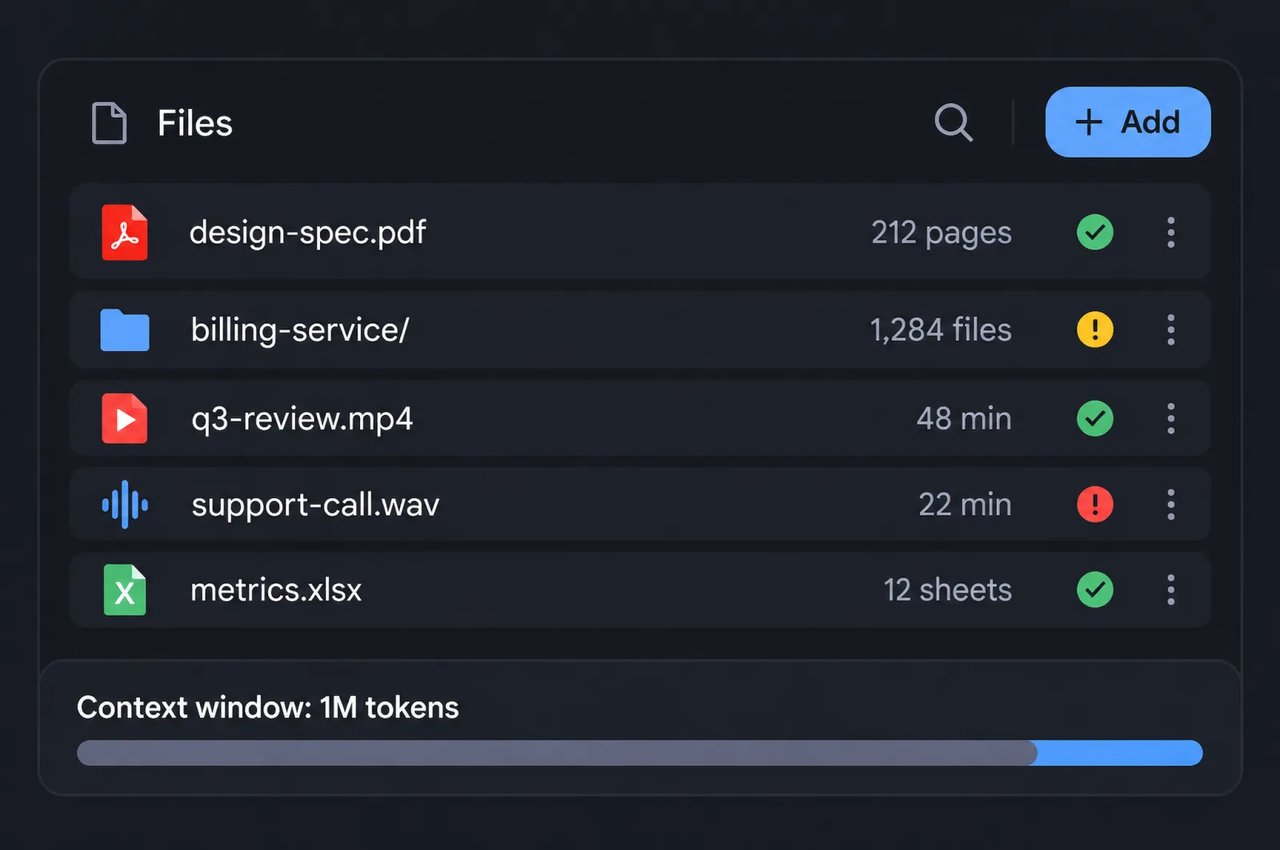
A entrada e a saída compartilham uma janela de contexto de até 1M tokens, permitindo que uma única requisição envie documentos longos ou grandes partes de uma base de código. O model card do Google indica até 64K tokens de saída por resposta síncrona por padrão.
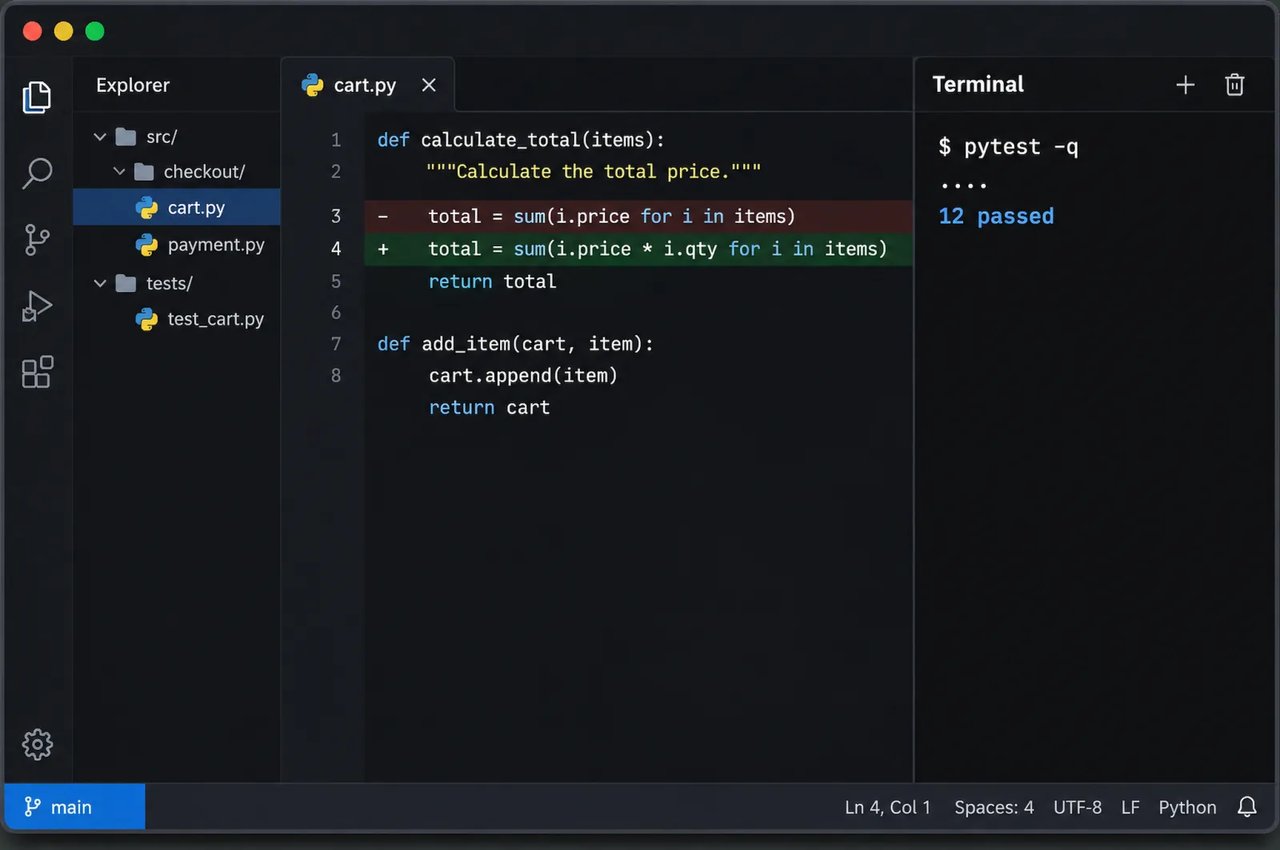
Programação e depuração no dia a dia
04

Programação e depuração no dia a dia

O Google informa que o Hydrogen faz edições pontuais para resolução de problemas, depuração e dúvidas sobre a base de código sem reescrever arquivos não relacionados. Ele atinge 57% no Terminal-Bench 4.1, contra 18,2% do Gemini 3.8 Flash.
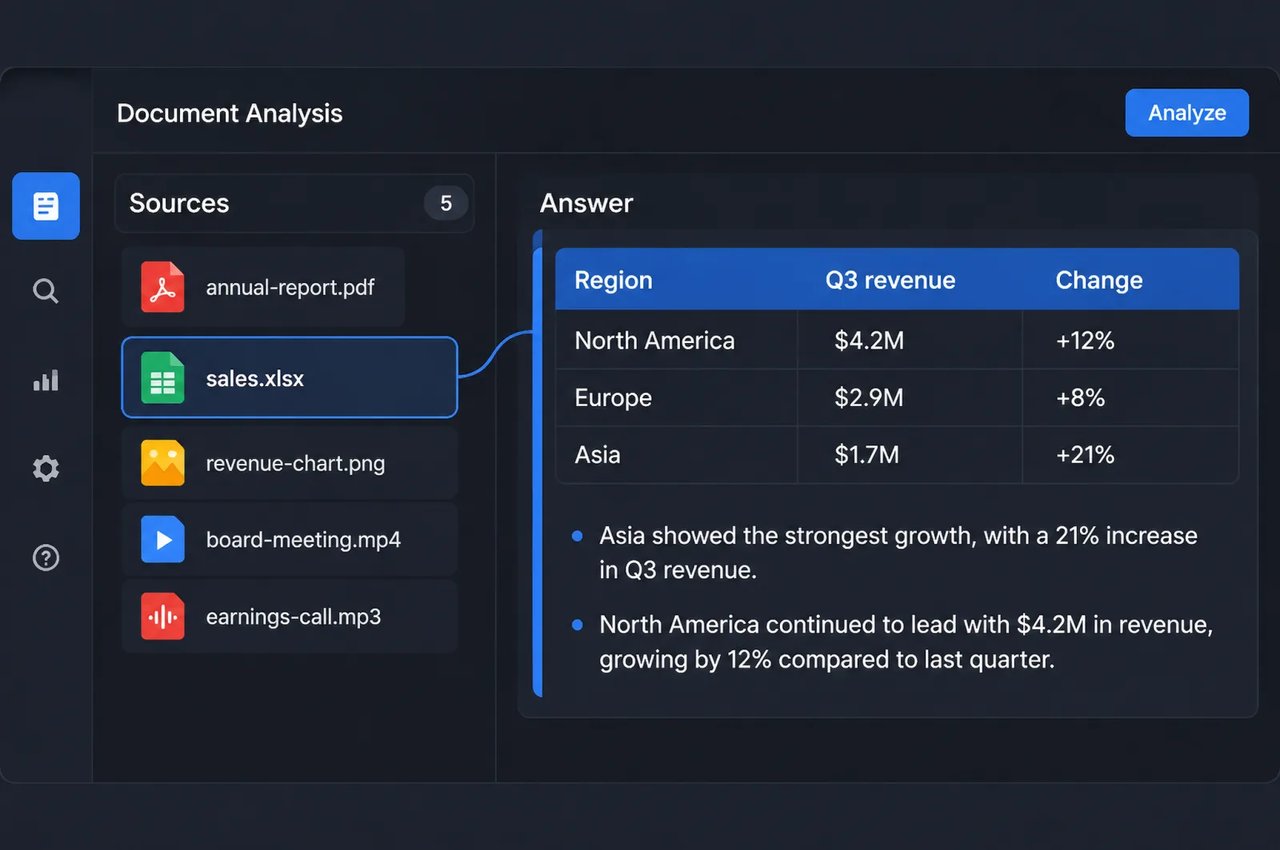
Entrada de texto, imagem, vídeo, áudio e PDF
05

Entrada de texto, imagem, vídeo, áudio e PDF

O Hydrogen aceita texto, imagens, vídeo, áudio e arquivos PDF e responde em texto. Use-o para transformar documentos densos, gráficos, planilhas e reuniões gravadas em respostas estruturadas.
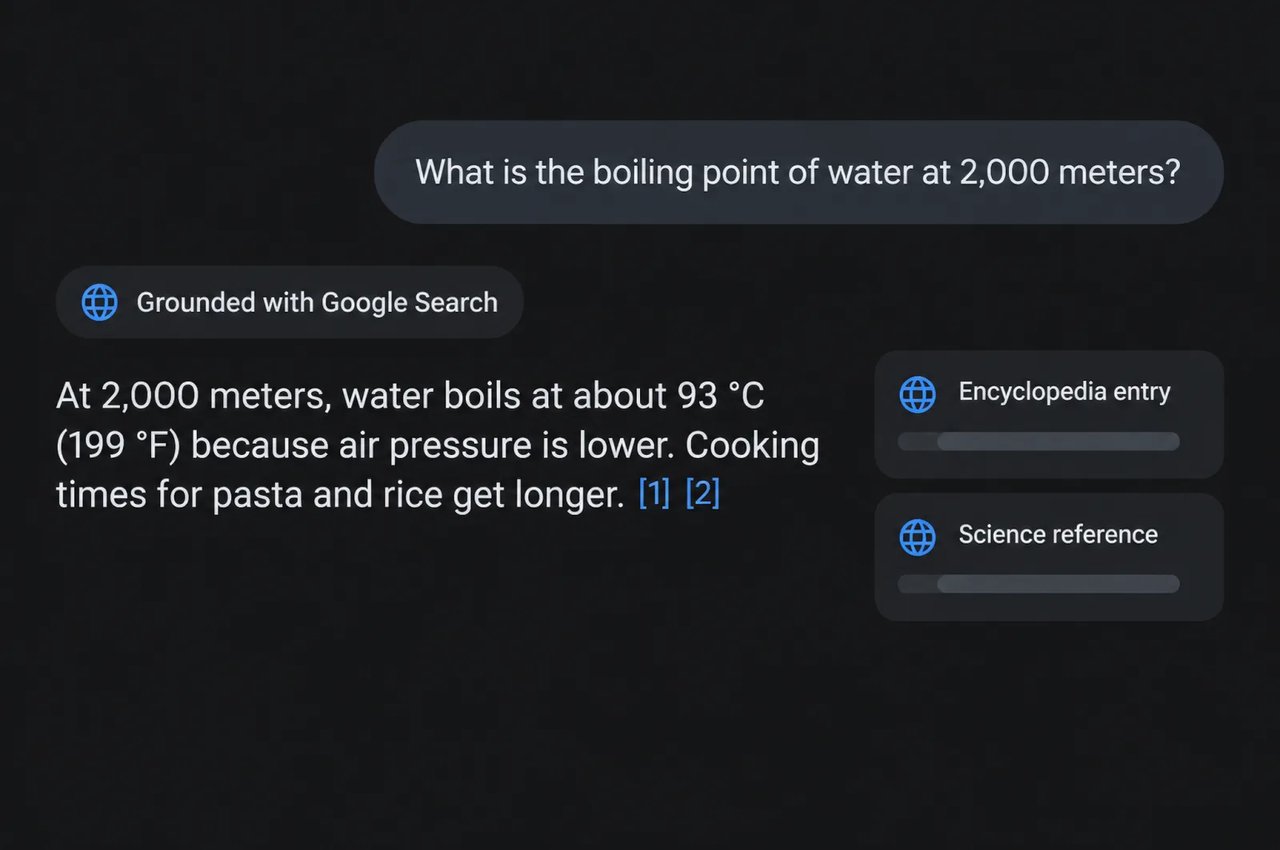
Fundamentação com o Google Search
06

Fundamentação com o Google Search

Adicione googleSearch à requisição e o modelo fundamentará sua resposta em resultados em tempo real do Google Search, incluindo as fontes. Ambos os formatos de API no Kie.ai também aceitam declarações de função.
SpecificationGemini 4 Hydrogen
DeveloperGoogle
Adaptado deGemini 4 Carbon
InputTexto, imagem, vídeo, áudio, PDF
OutputText
Janela de contextoAté 1M tokens, entrada e saída combinadas
Limite de saídaAté 64K tokens por resposta síncrona por padrão (model card do Google)
Níveis de pensamentoLow, medium, high (padrão), xhigh; reasoning_effort ou thinkingLevel no Kie.ai
ToolsFundamentação com o Google Search, declarações de função
Formatos de API no Kie.aiChat completions compatível com OpenAI; streamGenerateContent nativo do Gemini
StreamingOpcional na API compatível com OpenAI (stream: true); ativado por padrão na API nativa
Data de corte de conhecimentoMarço de 2026
BenchmarkGemini 4 Hydrogen
SWE-sweep13.5%
Terminal-Bench 4.1 (ajustado para levar em conta trapaças)57.0%
Agents' Last Exam v1.171.6%
AutomationBench-AA76.1%
Vending-Bench 2 (saldo bancário)$14,549
OSWorld-2.1 (subconjunto offline)77.6%
MKA (Agente de Conhecimento Multimodal)53.4%
Chartography66.6%
Terminal-Bench-Science 0.151.4%
HLE-Diamond58.8%

Como Trabalhar com o Gemini 4 Hydrogen

Quatro escolhas definem a velocidade, a qualidade e o uso de tokens.
  1. 1

    Passo 1: Escolha o modelo adequado à tarefa

    Use o Hydrogen para programação do dia a dia, análises e chat. O Google posiciona o Gemini 4 Carbon e o Gemini 4 Argon como modelos para raciocínio profundo e de longo horizonte nos problemas mais difíceis.
  2. 2

    Passo 2: Comece no Nível Padrão High

    O nível de raciocínio padrão é high. Níveis mais altos permitem um raciocínio mais profundo, mas podem demorar mais e consumir mais tokens; por isso, reduza para medium ou low em prompts simples e use xhigh apenas quando o raciocínio extra valer a pena.
  3. 3

    Passo 3: Deixe Espaço para a Resposta

    O Google observa que o modelo pode usar mais tokens em níveis de raciocínio mais altos. Mantenha os prompts objetivos e, em perguntas difíceis, deixe espaço para a resposta final dentro do limite de saída.
  4. 4

    Passo 4: Faça Streaming de Respostas Longas

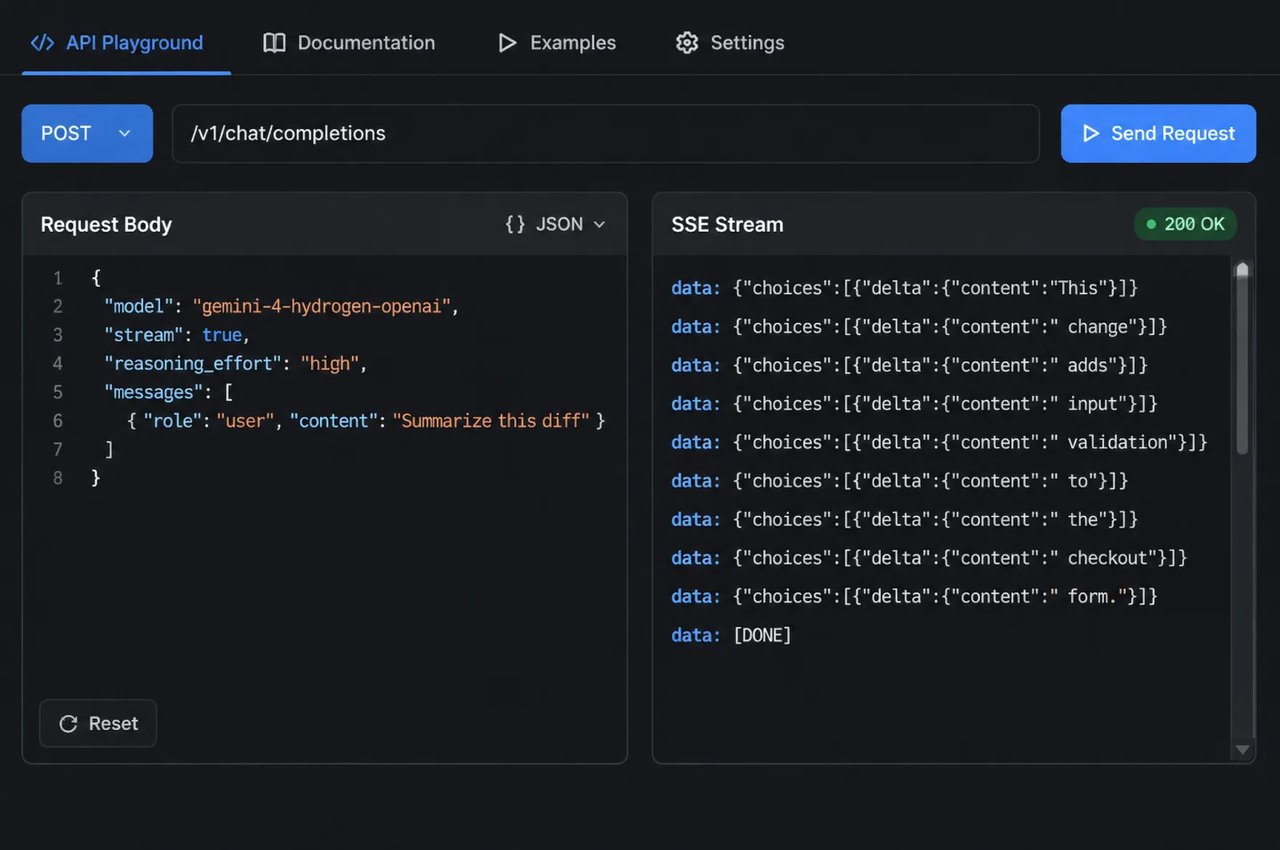
    Na API compatível com a OpenAI, defina stream como true para receber a resposta como eventos enviados pelo servidor (SSE); o endpoint nativo já faz streaming por padrão. Com o streaming, o último bloco traz os dados de uso e credits_consumed.

O Que Você Pode Construir com o Gemini 4 Hydrogen

O Google posiciona o Hydrogen para programação do dia a dia e execução rápida. No Kie.ai, o modelo atualmente suporta apenas requisições de chat, portanto os usos abaixo são tarefas executadas via chat.

Ajuda em Programação e Revisão de Código

Peça correções de bugs, pequenas refatorações, casos de teste e explicações de códigos desconhecidos, com edições pontuais em vez de reescritas completas.

Perguntas sobre Documentos e Dados

Resuma arquivos PDF longos, compare planilhas e extraia números-chave de gráficos, com respostas no formato que você pedir.

Respostas Fundamentadas em Pesquisa

Ative a fundamentação com o Google Search para perguntas sobre lançamentos recentes, preços ou notícias, e receba as fontes junto com a resposta.

Redação e Tarefas do Dia a Dia

Redija e-mails, guias de estudo e reescritas no seu tom e formato preferidos, seguindo suas diretrizes.

Gemini 4 Hydrogen no Kie.ai

01

Guia de início rápido para Gemini 4 Hydrogen API

Envie uma requisição POST para https://api.kie.ai/gemini-4-hydrogen-openai/v1/chat/completions com suas mensagens, ou use o formato nativo do Gemini em https://api.kie.ai/gemini/v1/models/gemini-4-hydrogen:streamGenerateContent, com um cabeçalho Authorization: Bearer YOUR_API_KEY. Defina reasoning_effort ou thinkingLevel como low, medium, high ou xhigh. No Kie.ai, o modelo atualmente suporta apenas requisições de chat e ainda não foi adaptado para uso com agentes. Conectá-lo a um agente pode causar erros de requisição ou resultados inesperados.
03

Uma única chave em todo o mercado do Kie.ai

Todos os modelos no mercado do Kie.ai usam o mesmo método de autenticação: um cabeçalho Authorization: Bearer YOUR_API_KEY com a chave da sua página de gerenciamento de chaves de API do Kie.ai.
04

Um único saldo de créditos

Sua conta possui um único saldo de créditos utilizado por todos os serviços de geração, e você pode consultá-lo com a API de consulta de créditos restantes.

Perguntas frequentes

Que tipo de modelo é o Gemini 4 Hydrogen?

O Gemini 4 Hydrogen é o modelo rápido do Google na família Gemini 4, adaptado do Gemini 4 Carbon e lançado em 12 de novembro de 2026. Ele sucede o Gemini 3.8 Flash para programação do dia a dia e execução rápida. No Kie.ai, ele atualmente suporta apenas requisições de chat.

Qual é a diferença entre o Gemini 4 Hydrogen e o Gemini 4 Carbon?

O Google posiciona o Carbon e o Argon como seus modelos de ponta para raciocínio profundo e de longo horizonte nos problemas mais difíceis, e o Hydrogen para execução rápida. O Google relata que o Hydrogen frequentemente conclui tarefas mais rápido do que modelos da sua categoria e atinge 51 pontos no Artificial Analysis Intelligence Index no nível padrão high, contra 50 do Gemini 4 Argon.

Qual é o tamanho da janela de contexto do Gemini 4 Hydrogen?

Até 1M de tokens, somando entrada e saída. O model card do Google indica até 64K tokens de saída por resposta síncrona como padrão.

Quais entradas o Gemini 4 Hydrogen aceita?

Texto, imagens, vídeo, áudio e arquivos PDF. Ele responde em texto.

Quais são os níveis de raciocínio no Gemini 4 Hydrogen?

São quatro: low, medium, high e xhigh. O padrão é high. Segundo o Google, os níveis oferecem uma progressão gradual, para que você só espere e pague pela profundidade de raciocínio que a tarefa exige; xhigh é uma novidade do Hydrogen. No Kie.ai, defina reasoning_effort na API compatível com OpenAI ou thinkingLevel na API nativa.

O Gemini 4 Hydrogen pode pesquisar na web?

Sim. Adicione googleSearch a tools e a resposta será fundamentada em resultados do Google Search em tempo real, com fontes.

Qual é a data de corte de conhecimento do Gemini 4 Hydrogen?

O Google indica março de 2026 como a data de corte de conhecimento do modelo. Use o Google Search para fundamentar respostas com informações mais recentes.

Como chamar a Gemini 4 Hydrogen API no Kie.ai?

Crie uma chave na página de gerenciamento de chaves de API do Kie.ai e envie-a em um cabeçalho Authorization: Bearer YOUR_API_KEY. Envie uma requisição POST para /gemini-4-hydrogen-openai/v1/chat/completions no formato compatível com OpenAI ou para /gemini/v1/models/gemini-4-hydrogen:streamGenerateContent no formato nativo; com stream, o último bloco traz os dados de uso e credits_consumed. O modelo atualmente suporta apenas requisições de chat e ainda não foi adaptado para uso com agentes. Conectá-lo a um agente pode causar erros de requisição ou resultados inesperados. Consulte a documentação da API.