Defina você mesmo o formato de saída
A documentação pede para definir output_format explicitamente, portanto escolha PNG ou JPEG em cada requisição em vez de depender de um padrão.
O Qwen Image 3.0 é o modelo avançado de geração de imagens da Alibaba para imagens realistas, layouts estruturados, ricos detalhes visuais e tipografia de alta qualidade.
Click to upload or drag and drop
Supported formats: JPEG, PNG, WEBP, BMP, GIF, TIFF Maximum file size: 10MB; Maximum files: 3
Upload an image file to use as input for the API
The positive prompt that describes the image content, style, and composition you want to generate or edit. Both Chinese and English are supported.
0/5000The output image resolution.
The output image size.
Generate image format
Whether to enable intelligent prompt rewriting. Default: true (recommended). When enabled, the model optimizes the positive prompt, which significantly improves results for simple descriptions.
The negative prompt that describes content you do not want to appear in the image.
0/5000The random seed. Value range: [0, 2147483647]. A fixed seed helps maintain relatively stable results.
A configurable parameter. Defaults to true in the Playground.
Explore different use cases and parameter configurations
The positive prompt that describes the image content, style, and composition you want to generate or edit. Both Chinese and English are supported.
0/5000The output image resolution.
The output image size
Generate image format
Whether to enable intelligent prompt rewriting. Default: true (recommended). When enabled, the model optimizes the positive prompt, which significantly improves results for simple descriptions.
The negative prompt that describes content you do not want to appear in the image.
0/5000The random seed. Value range: [0, 2147483647]. A fixed seed helps maintain relatively stable results.
A configurable parameter. Defaults to true in the Playground.
Explore different use cases and parameter configurations
The positive prompt that describes the image content, style, and composition you want to generate or edit. Both Chinese and English are supported.
0/5000The output image resolution.
The output image size
Generate image format
Whether to enable intelligent prompt rewriting. Default: true (recommended). When enabled, the model optimizes the positive prompt, which significantly improves results for simple descriptions.
The negative prompt that describes content you do not want to appear in the image.
0/5000The random seed. Value range: [0, 2147483647]. A fixed seed helps maintain relatively stable results.
A configurable parameter. Defaults to true in the Playground.
Explore different use cases and parameter configurations
Click to upload or drag and drop
Supported formats: JPEG, PNG, WEBP, BMP, GIF, TIFF Maximum file size: 10MB; Maximum files: 3
Upload an image file to use as input for the API
The positive prompt that describes the image content, style, and composition you want to generate or edit. Both Chinese and English are supported.
0/5000The output image resolution.
The output image size.
Generate image format
Whether to enable intelligent prompt rewriting. Default: true (recommended). When enabled, the model optimizes the positive prompt, which significantly improves results for simple descriptions.
The negative prompt that describes content you do not want to appear in the image.
0/5000The random seed. Value range: [0, 2147483647]. A fixed seed helps maintain relatively stable results.
A configurable parameter. Defaults to true in the Playground.
Explore different use cases and parameter configurations
Complete guide to using Qwen Image 3.0
O Qwen-Image-3.0 é o modelo de terceira geração da série Qwen-Image, desenvolvido para imagens ricas em informação: prompts de até 4,5 mil tokens, texto legível em tamanhos tão pequenos quanto 10px e renderização nativa em 12 idiomas. No Kie.ai, ele funciona como quatro modelos de API: padrão e Pro, cada um para texto para imagem e imagem para imagem.
O Qwen Image 3 e o Qwen Image 3 Pro aceitam os mesmos parâmetros no Kie.ai; a diferença está no modelo em si, não na requisição.
| Parameter | Value |
|---|---|
| Models | Padrão: qwen3/text-to-image, qwen3/image-to-image. Pro: qwen3/pro-text-to-image, qwen3/pro-image-to-image |
| Endpoint | POST /api/v1/jobs/createTask, then Get Task Details or a callBackUrl for the result |
| Prompt | Obrigatório; chinês ou inglês; até 5.000 caracteres por requisição. Segundo a equipe Qwen, o modelo processa prompts longos de cerca de 4,5 mil tokens |
| Prompt negativo | Opcional; até 5.000 caracteres |
| Imagens de entrada (imagem para imagem) | 1 a 3 URLs de imagem; JPEG, PNG, WebP, BMP, GIF ou TIFF; até 10 MB cada |
| Resolution | 1K ou 2K (para imagem para imagem, o padrão é 1K) |
| Proporção da imagem | 1:1, 3:2, 2:3, 4:3, 3:4, 16:9, 9:16, 21:9 (padrão 16:9) |
| Formato de saída | PNG ou JPEG |
| Reescrita de prompt | prompt_extend, ativado por padrão |
| Seed | Opcional, de 0 a 2.147.483.647; aleatório se omitido |
| Pricing | Varia conforme o modelo e a resolução; consulte o cartão de preços acima |
Cada exemplo abaixo foi gerado com o Qwen Image 3 Pro no Kie.ai em outubro de 2026 a partir do prompt descrito na legenda; as imagens são exibidas como foram geradas, apenas redimensionadas para a web.
O Qwen-Image-3.0 foi desenvolvido para seguir prompts longos de cerca de 4,5 mil tokens, permitindo que uma única requisição descreva um layout inteiro. Este infográfico veio de um único prompt com cerca de 110 palavras que especificava quatro painéis, seus rótulos, um gráfico de barras com quatro valores e uma legenda no rodapé; todos eles aparecem na imagem.

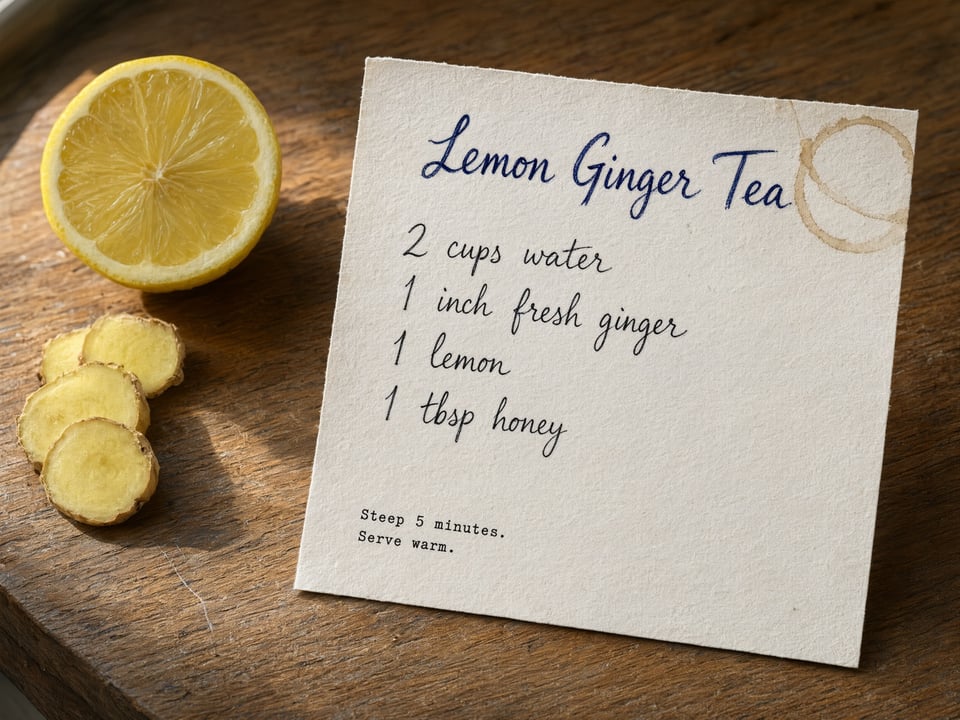
A equipe Qwen afirma que o modelo renderiza textos tão pequenos quanto 10px e detalhes finos de superfície. Aqui, a lista de ingredientes manuscrita e a pequena nota digitada permanecem legíveis, e a imagem também mostra fibras do papel, uma leve marca de xícara de café e os veios da madeira.
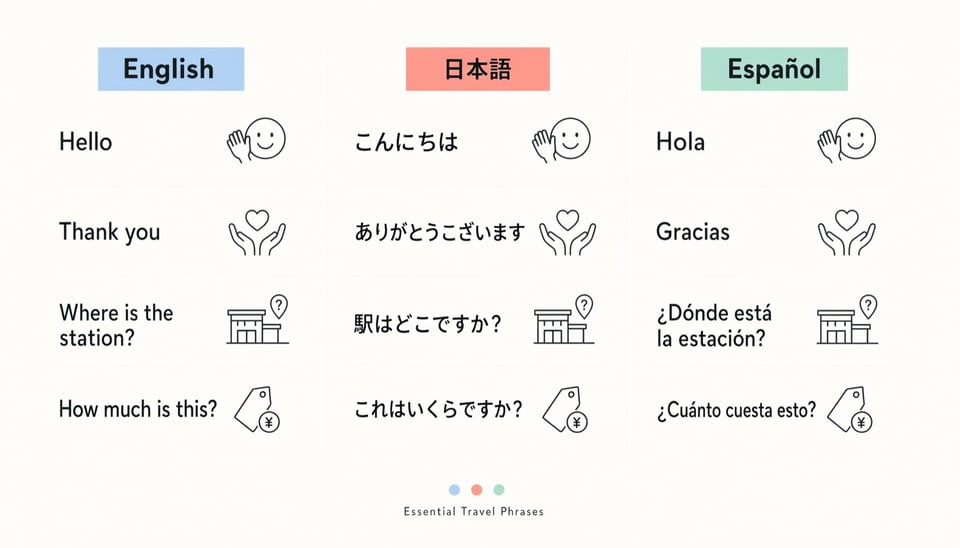
O Qwen-Image-3.0 renderiza texto nativamente em 12 idiomas. Este pôster apresenta as mesmas quatro frases em inglês, japonês e espanhol, incluindo kana e kanji japoneses, além de acentos e pontos de interrogação invertidos do espanhol.
A partir da ficha de receita acima, uma única instrução adicionou três notas manuscritas, duas delas com setas. Nesta edição, a ficha, a mesa e a iluminação permaneceram iguais enquanto as notas foram incluídas.

No Kie.ai, as duas versões recebem exatamente a mesma requisição, então alternar entre elas exige mudar apenas uma palavra no nome do modelo. Na arena de texto para imagem da Artificial Analysis, o Qwen-Image-3.0-Pro pontua 1.087 e o Qwen-Image-3.0 pontua 1.075, com faixas de pontuação que se sobrepõem. Como a diferença medida é pequena, uma escolha padrão prática é o modelo padrão; use o Pro para materiais finais com muito texto apenas se uma comparação lado a lado com seus próprios prompts mostrar diferença. Os preços de cada modelo estão no cartão de preços acima.A equipe Qwen posiciona o Qwen-Image-3.0 para imagens ricas em informação, como jornais, storyboards, provas e mockups de interface. Especificamente para texto, o ranking de renderização de texto da LMArena lista o Qwen-Image-3.0-Pro com 1.283, o GPT Image 2 (medium) com 1.425 e o Seedream 5.0 Pro com 1.255 (em 7 de outubro de 2026).
| Qwen Image 3 | Qwen Image 3 Pro | |
|---|---|---|
| Modelos no Kie.ai | qwen3/text-to-image, qwen3/image-to-image | qwen3/pro-text-to-image, qwen3/pro-image-to-image |
| Parâmetros da requisição | Igual ao Pro | Igual ao padrão |
| Pontuação de texto para imagem na Artificial Analysis (out. de 2026) | 1075 | 1087 |
| Pontuação de texto para imagem no LMArena (7 de out. de 2026) | Não listado | 1255 |
| Pontuação de renderização de texto no LMArena (7 de out. de 2026) | Não listado | 1283 |
| Pricing | Exibido no card de preços acima | Exibido no card de preços acima |
A equipe do Qwen criou o Qwen-Image-3.0 para imagens em que o texto e o layout precisam estar certos, não apenas o visual. Estes são os tipos de trabalho em que ele se encaixa.
Slides de aula, provas, páginas cheias de fórmulas e layouts em estilo de jornal, onde cada título, rótulo e equação precisa ser legível em uma única imagem.
Telas realistas para páginas da web, aplicativos móveis, jogos e transmissões ao vivo para inserir em apresentações comerciais, revisões de design ou testes iniciais com usuários antes que qualquer coisa seja construída.
Pôsteres, cardápios, sinalizações e artes para redes sociais que precisam do mesmo design em vários idiomas, gerados já com o texto no lugar em vez de adicionado depois.
Transformação de uma foto existente em uma figura rotulada para relatórios, notas de pesquisa ou documentação de produtos com imagem para imagem, mantendo o assunto original e adicionando as anotações.
A documentação pede para definir output_format explicitamente, portanto escolha PNG ou JPEG em cada requisição em vez de depender de um padrão.
O recurso de imagem para imagem aceita URLs de imagens hospedadas. Arquivos que ainda não estão hospedados podem ser enviados primeiro com a API de upload de arquivos do Kie.ai (Base64, fluxo de arquivo ou URL remota).
Em uma de nossas quatro imagens de teste, o modelo adicionou rótulos que não pedimos (veja o infográfico acima), portanto verifique o texto gerado antes de publicar, especialmente números e nomes. A reescrita de prompt (prompt_extend) vem ativada por padrão; se você precisar do seu texto exato, compare os resultados com ela ativada e desativada.
Todos os modelos do catálogo do Kie.ai usam o mesmo método de autenticação: um cabeçalho Authorization: Bearer YOUR_API_KEY com a chave da sua página de gerenciamento de chaves de API do Kie.ai.
Novos usuários do Kie.ai recebem 80 créditos grátis para testes. Sua conta tem um único saldo de créditos usado por todos os serviços de geração; consulte-o com a API Get Remaining Credits.
O Kie.ai disponibiliza este modelo como uma API com um Playground; não há aplicativo para baixar ou instalar. Não é preciso gerenciar GPUs nem pesos do modelo.