Automatically append previous messages to maintain multi-turn context. May increase token usage.
How can I help you today?
Automatically append previous messages to maintain multi-turn context. May increase token usage.
How can I help you today?
README
Complete guide to using Gemini 4 Neon
Gemini 4 Neon API para Programação Complexa, Análise e Ciência

curl https://api.kie.ai/gemini-4-neon-openai/v1/chat/completions \-H "Authorization: Bearer $KIE_API_KEY" \-H "Content-Type: application/json" \-d '{"messages": [{ "role": "user", "content": "Analyze the latency vs consistency trade-offs of multi-region consensus." }],"reasoning_effort": "high","stream": false}'
Principais Recursos do Gemini 4 Neon


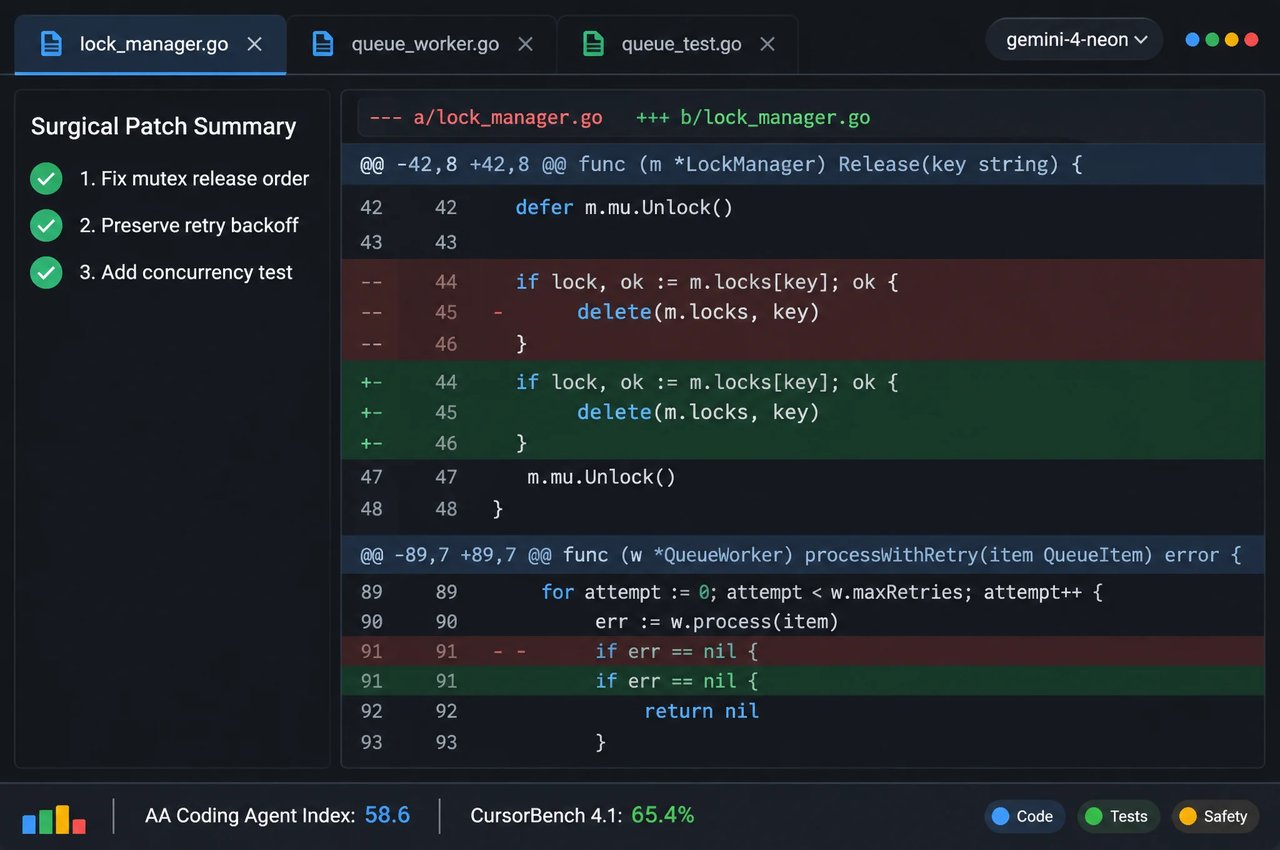
Programação em Nível de Repositório e Refatoração Multiarquivo

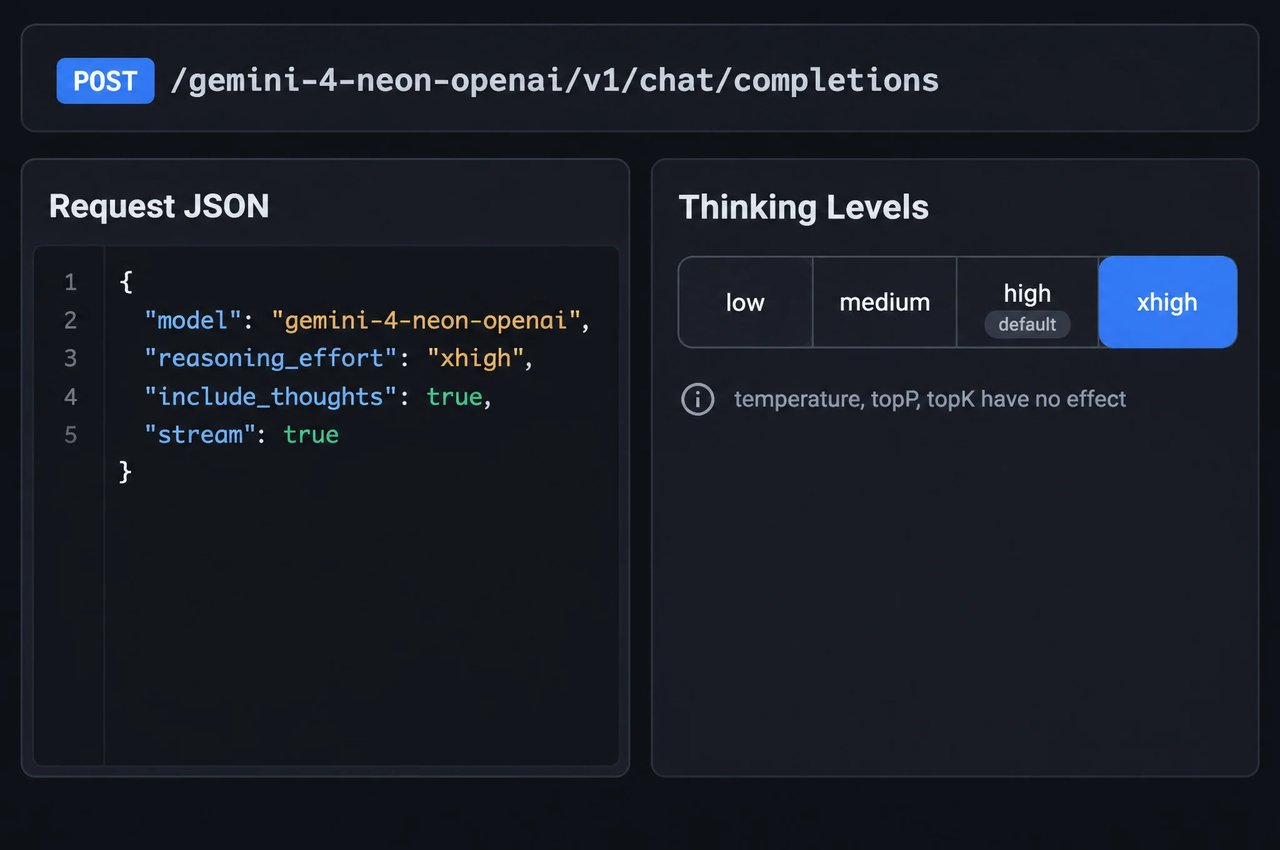
Quatro Níveis de Raciocínio de Low a Xhigh

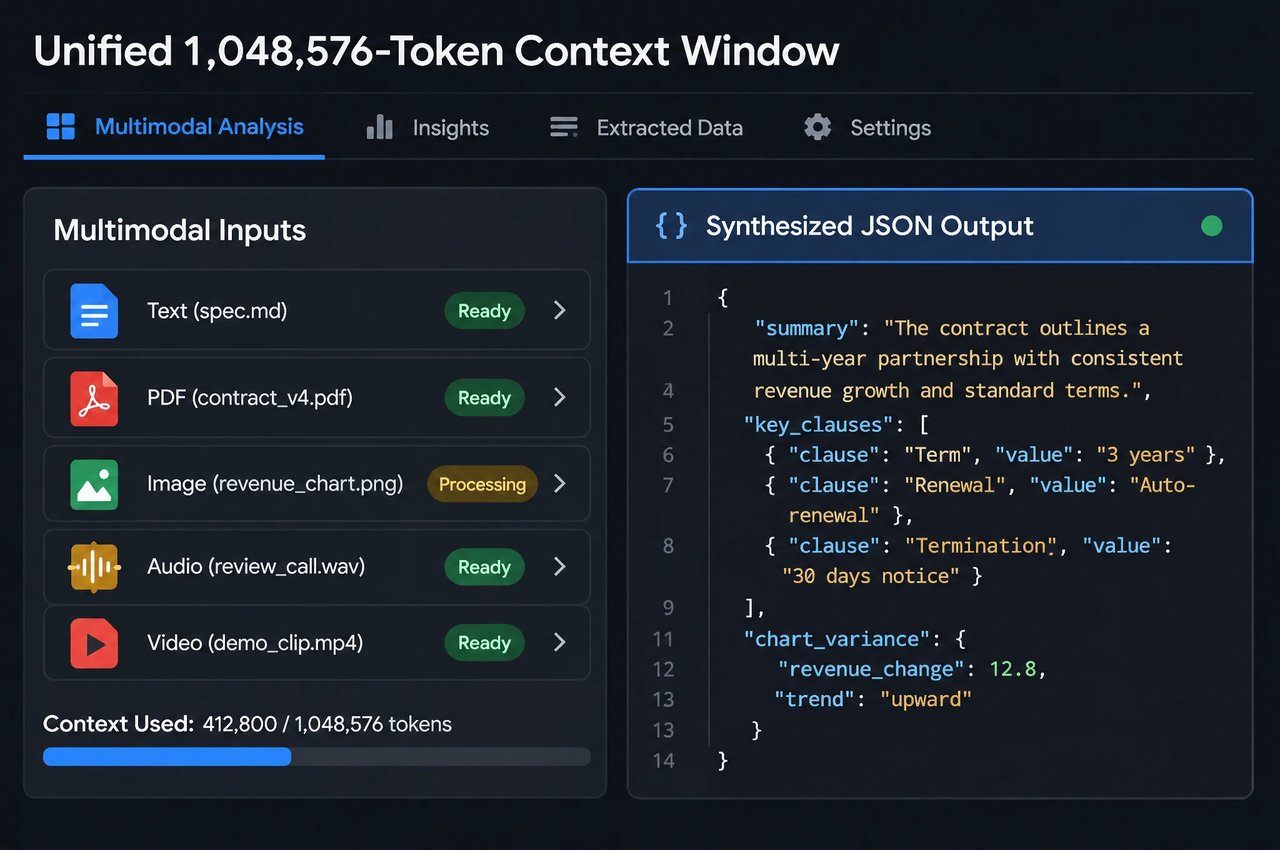
Janela de Contexto Multimodal Unificada de 1M de Tokens

Fluxos de Trabalho Analíticos, Jurídicos e Científicos

Geração Segura de Código, Grounding e Ferramentas
Especificações do Gemini 4 Neon
Especificações do modelo e parâmetros da API do Kie.ai para o Gemini 4 Neon a partir do model card do Google e da documentação da API do Kie.ai.
| Specification | Gemini 4 Neon |
|---|---|
| Developer | Google (Google DeepMind) |
| IDs de modelo no Kie.ai | gemini-4-neon-openai (compatível com OpenAI); gemini-4-neon (Gemini nativo) |
| Data de lançamento | 18 de novembro de 2026 |
| Adaptado de | Gemini 4 Carbon |
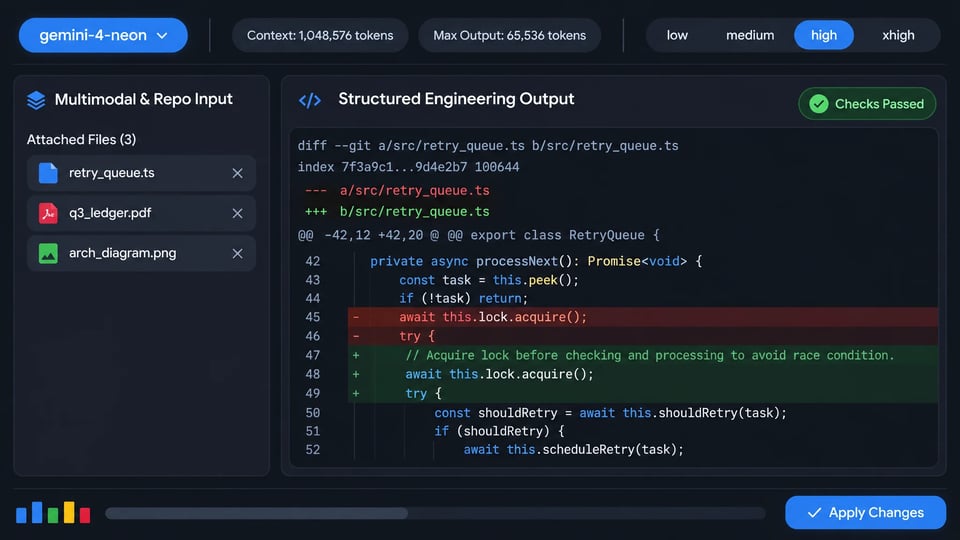
| Modalities | Entrada de texto, imagem, vídeo, áudio e PDF (até 10 arquivos por requisição); saída de texto |
| Janela de contexto | 1.048.576 tokens unificados entre entrada, raciocínio e saída |
| Máximo de tokens de saída | Até 65.536 tokens por resposta síncrona por padrão (tokens de raciocínio contam para a saída) |
| Níveis de raciocínio | low, medium, high (padrão), xhigh via reasoning_effort ou thinkingLevel (minimal ignorado; include_thoughts / includeThoughts opcionais) |
| Formatos de API no Kie.ai | POST /gemini-4-neon-openai/v1/chat/completions (stream default false); POST /gemini/v1/models/gemini-4-neon:streamGenerateContent (stream default true) |
| Ferramentas e parâmetros no Kie.ai | Embasamento com a Pesquisa Google (googleSearch), ferramentas de função, esquema JSON de response_format (compatível com OpenAI), cache implícito (temperature, topP e topK não têm efeito; apenas requisições de chat) |
| Data de corte do conhecimento | Março de 2026 |
Resultados de benchmark do Gemini 4 Neon
Resultados de avaliação divulgados pelo Google em seu anúncio de lançamento de 18 de novembro de 2026 e na ficha do modelo da DeepMind.
| Benchmark | Gemini 4 Neon | O que mede |
|---|---|---|
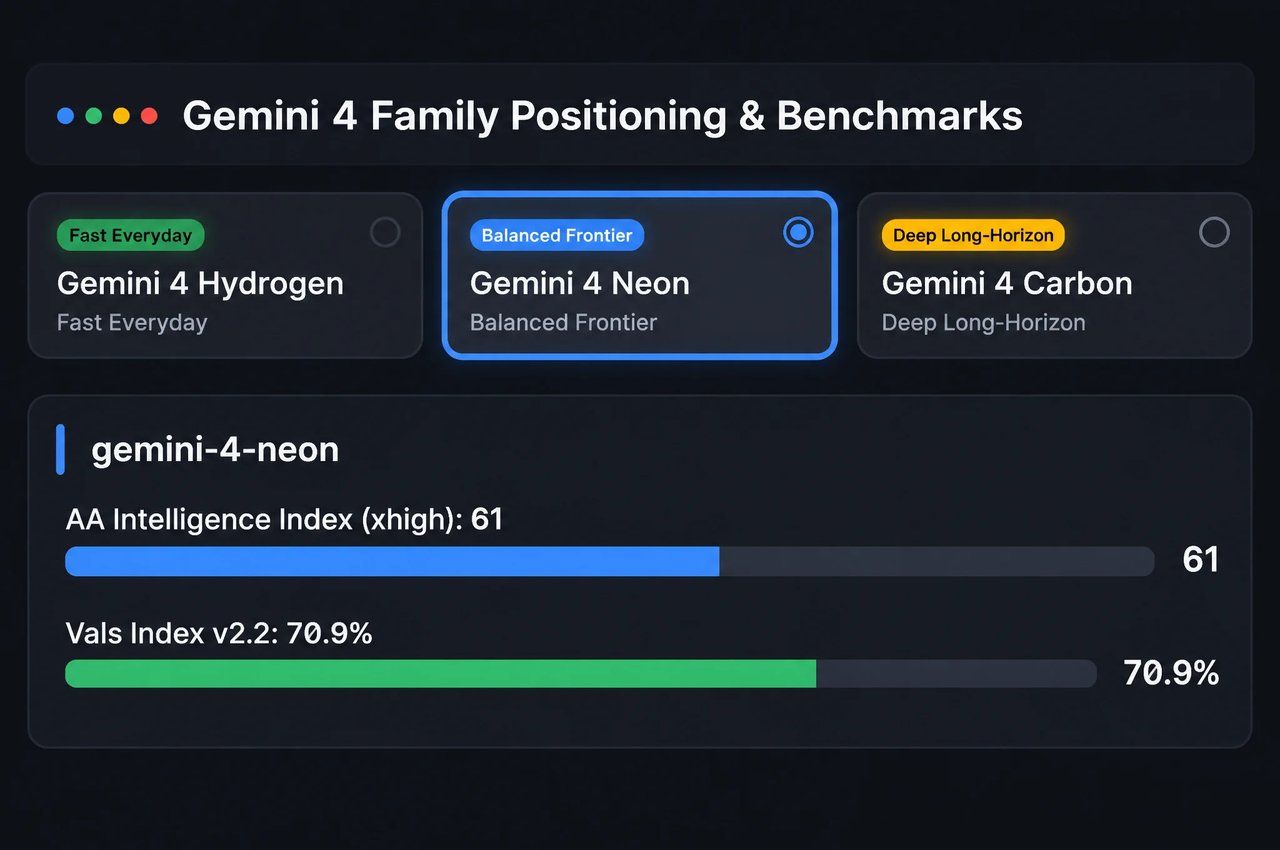
| AA Intelligence Index v5.0.1 | 61 (3º no geral, em xhigh) | Índice de capacidade geral |
| Vals Index v2.2 | 70,9% (2º no geral; 1º em Legal Research & Tax Agent) | Avaliações corporativas, jurídicas e tributárias |
| AA Coding Agent Index | 58,6 (1º no geral) | Avaliação de capacidade de engenharia de software |
| CursorBench 4.1 / Terminal-Bench 4.1 | 65,4% / 65,2% (ajustado para levar em conta trapaças) | Programação em repositórios e execução em terminal |
| FrontierCode 2.0 / SWE-sweep | 46,2% (em high) / 39,0% (ambiente Antigravity), 12,8% (mini-SWE) | Benchmarks de engenharia de software |
| Agents' Last Exam v1.1 / AutomationBench | 75,8% / 56,3% (1º no geral) | Trabalho de conhecimento em múltiplas etapas e automação de fluxos de trabalho |
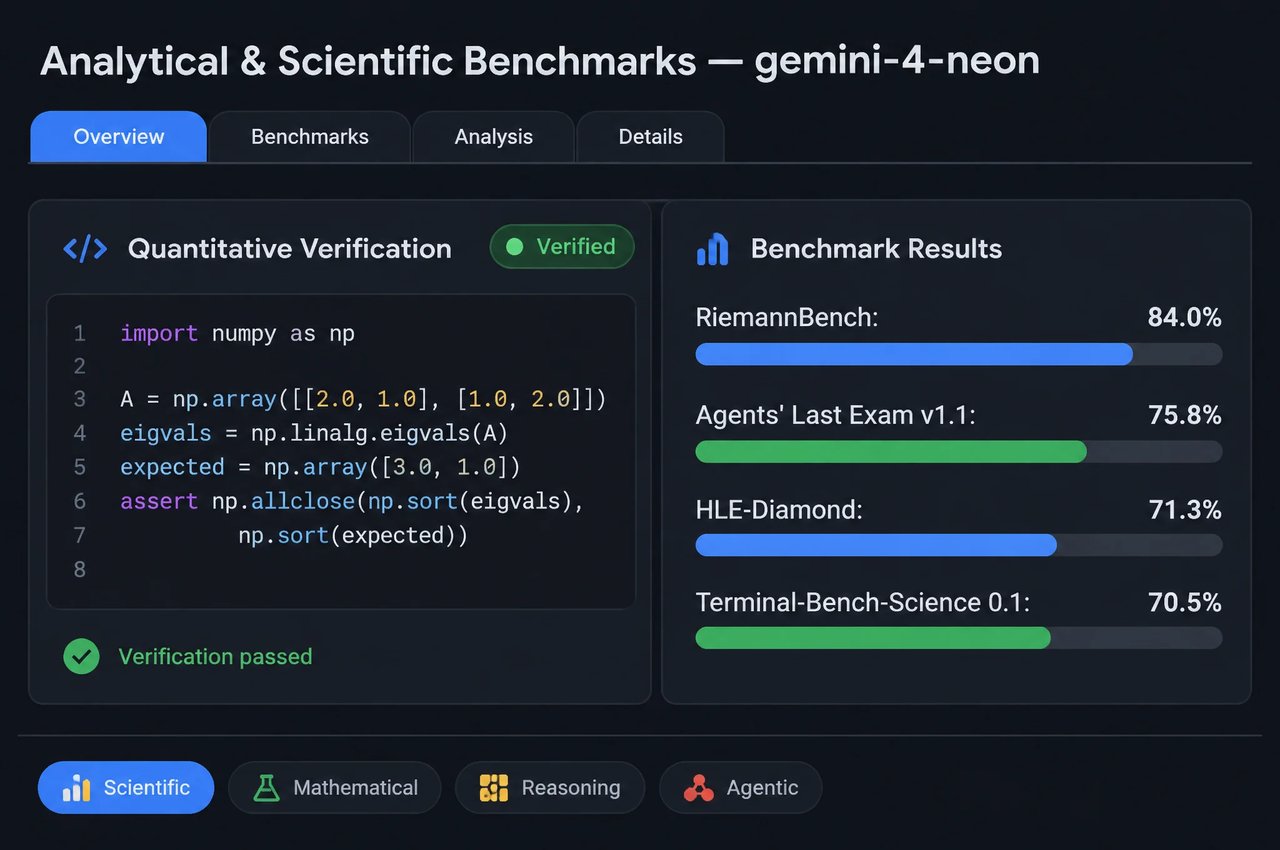
| RiemannBench / HLE-Diamond / Terminal-Bench-Science 0.1 | 84.0% / 71.3% / 70.5% | Matemática e raciocínio científico |
| GraphWalks (256K a 1M, BFS F1) | 95.2% | Recuperação e raciocínio em contexto longo |
| LVBench / Chartography / MKA | 89.0% / 73.5% / 56.5% | Vídeos longos, gráficos densos e raciocínio multimodal |
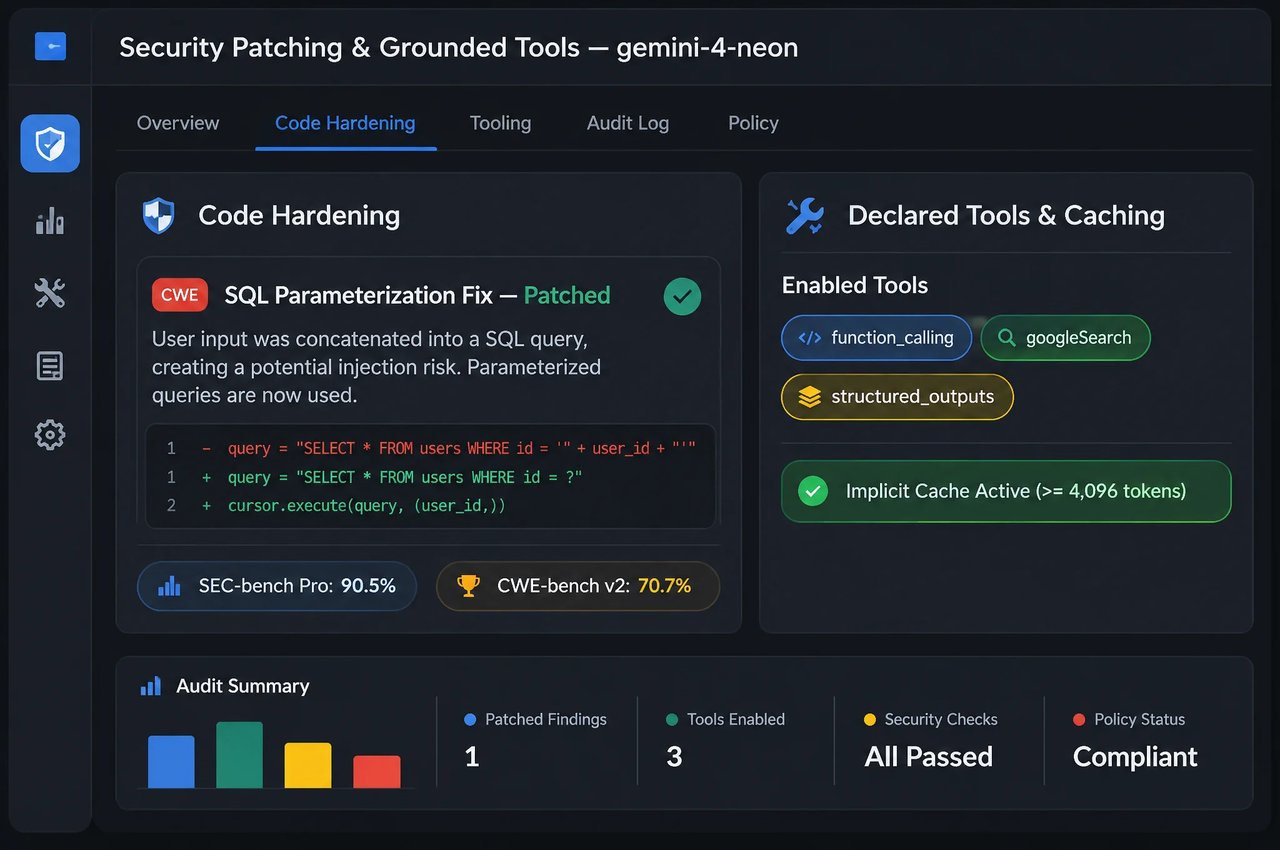
| Benchmarks SEC-bench Pro / CWE-bench v2 / WebExploitBench v1.2 | 90.5% / 70.7% / 51.3% | Detecção de vulnerabilidades, aplicação de patches e segurança web |
Como trabalhar com o Gemini 4 Neon
- 1
Passo 1: Escolha entre Hydrogen, Neon e Carbon
Use o Gemini 4 Neon para engenharia de software complexa, raciocínio analítico e fluxos de trabalho científicos em que você precisa de profundidade de raciocínio de ponta com conclusão eficiente de tarefas de ponta a ponta. Mantenha o Gemini 4 Hydrogen para programação e execução rápidas do dia a dia, e reserve o Gemini 4 Carbon para os projetos de longo prazo mais difíceis. - 2
Passo 2: Comece em High e Reserve Xhigh para Problemas Difíceis
High é o nível de pensamento padrão no Kie.ai. Defina reasoning_effort (compatível com OpenAI) ou generationConfig.thinkingConfig.thinkingLevel (nativo) como medium ou low para um uso mais enxuto de tokens em prompts mais simples, ou xhigh para problemas difíceis de múltiplas etapas em engenharia, análise e ciência. Deixe temperature, topP e topK sem definição, pois não têm efeito no Gemini 4. - 3
Passo 3: Deixe Espaço para Tokens de Pensamento e de Saída
Os tokens de entrada, pensamento e saída compartilham a janela de 1.048.576 tokens, e o limite padrão de saída de 65.536 tokens cobre tanto o pensamento quanto o texto visível da resposta. Para tarefas difíceis com xhigh, lembre-se de que um pensamento mais profundo consome mais desse limite compartilhado de saída, e envie até 10 arquivos de mídia por requisição. - 4
Passo 4: Use Grounding, Ferramentas de Função e Cache de Prefixo
Ative googleSearch quando uma pergunta precisar de fatos da web posteriores a março de 2026, declare ferramentas de função personalizadas em qualquer um dos endpoints ou passe um esquema JSON em response_format no endpoint compatível com OpenAI. Mantenha prefixos de prompt compartilhados inalterados entre os turnos para que o contexto repetido se qualifique para o preço de entrada em cache.