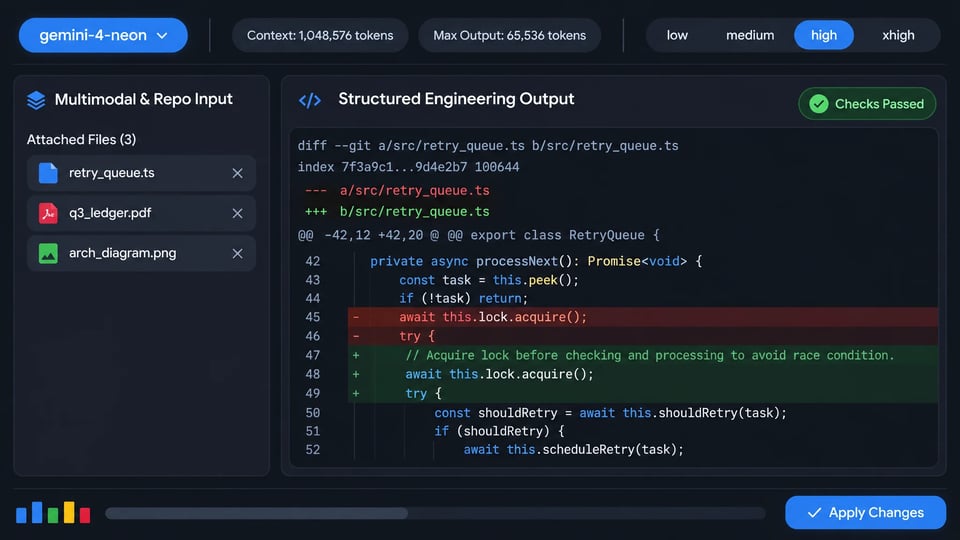
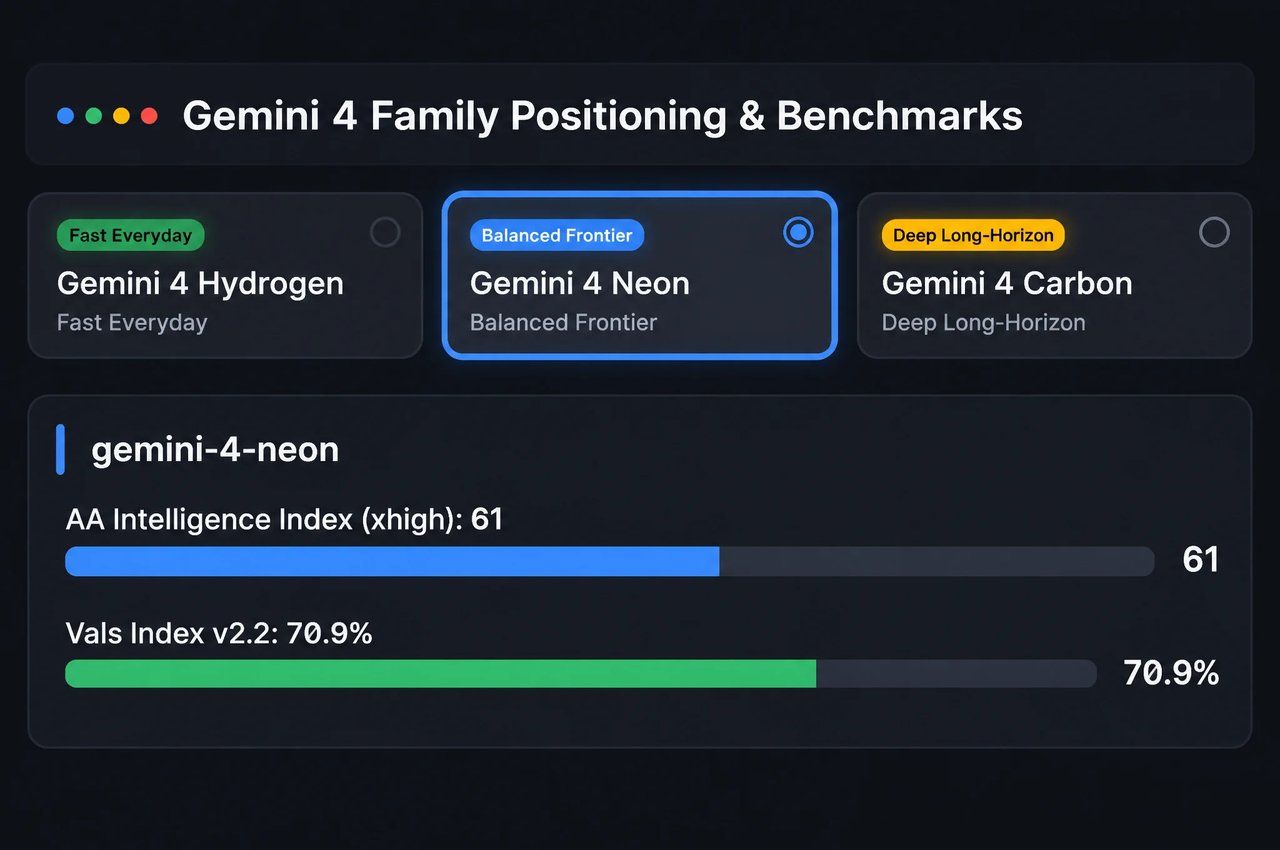
Google memperkenalkan Gemini 4 Neon (gemini-4-neon) pada 18 November 2026 untuk menyeimbangkan kedalaman penalaran tingkat terdepan dengan penyelesaian tugas menyeluruh yang efisien di berbagai alur kerja rekayasa perangkat lunak yang rumit, penalaran analitis, pekerjaan berbasis pengetahuan, dan sains. Diadaptasi dari Gemini 4 Carbon, model ini berada di antara Gemini 4 Hydrogen dan Gemini 4 Carbon dalam keluarga Gemini 4 serta menawarkan jendela konteks terpadu sebesar 1.048.576 token dengan empat tingkat pemikiran, dari low hingga xhigh. Di Kie.ai, model ini saat ini hanya mendukung permintaan obrolan.

Model Type:
Pricing: Input 240 credits / 1M tokens (≈ $1.20), Cached Input 12 credits / 1M tokens (≈ $0.06), Output 1200 credits / 1M tokens (≈ $6.00) — all 60% below official pricing. High-tier top-ups come with bonus credits that lower the effective price by about 10%.

Automatically append previous messages to maintain multi-turn context. May increase token usage.

Function calling
Grounding with Google Search
Source:Google Search
Thinking process
Reasoning effort
Stream Response

How can I help you today?

README

Complete guide to using Gemini 4 Neon

Gemini 4 Neon API untuk Pengodean Kompleks, Analisis, dan Sains

Gemini 4 Neon menerima teks, gambar, video, audio, dan PDF serta menghasilkan respons teks. Token masukan, pemikiran, dan keluaran berbagi jendela konteks terpadu 1.048.576 token, dengan batas maksimum bawaan 65.536 token keluaran per respons sinkron. Empat tingkat pemikiran — low, medium, high, dan xhigh — memungkinkan Anda menyesuaikan kedalaman penalaran dan penggunaan token untuk setiap beban kerja.
curl https://api.kie.ai/gemini-4-neon-openai/v1/chat/completions \
-H "Authorization: Bearer $KIE_API_KEY" \
-H "Content-Type: application/json" \
-d '{
"messages": [{ "role": "user", "content": "Analyze the latency vs consistency trade-offs of multi-region consensus." }],
"reasoning_effort": "high",
"stream": false
}'
Thinking

Kemampuan Utama Gemini 4 Neon

Diadaptasi dari Gemini 4 Carbon, Gemini 4 Neon berada di antara Hydrogen dan Carbon dalam keluarga Gemini 4, menyeimbangkan kedalaman penalaran tingkat terdepan dengan penyelesaian tugas ujung ke ujung yang efisien di seluruh rekayasa perangkat lunak yang kompleks, penalaran analitis, pekerjaan berbasis pengetahuan, dan alur kerja sains.
Penalaran Terdepan yang Seimbang dalam Keluarga Gemini 4
01

Penalaran Terdepan yang Seimbang dalam Keluarga Gemini 4

Sementara Gemini 4 Carbon menangani proyek jangka panjang tersulit dan Gemini 4 Hydrogen menjalankan eksekusi harian yang cepat, Google membangun Gemini 4 Neon untuk menyeimbangkan kedalaman penalaran dan efisiensi. Google melaporkan skor 61 (#3 secara keseluruhan) pada Artificial Analysis Intelligence Index pada tingkat xhigh dan 70,9% (#2 secara keseluruhan) pada Vals Index v2.2.
Pengodean Tingkat Repositori dan Refaktorisasi Multi-Berkas
02

Pengodean Tingkat Repositori dan Refaktorisasi Multi-Berkas

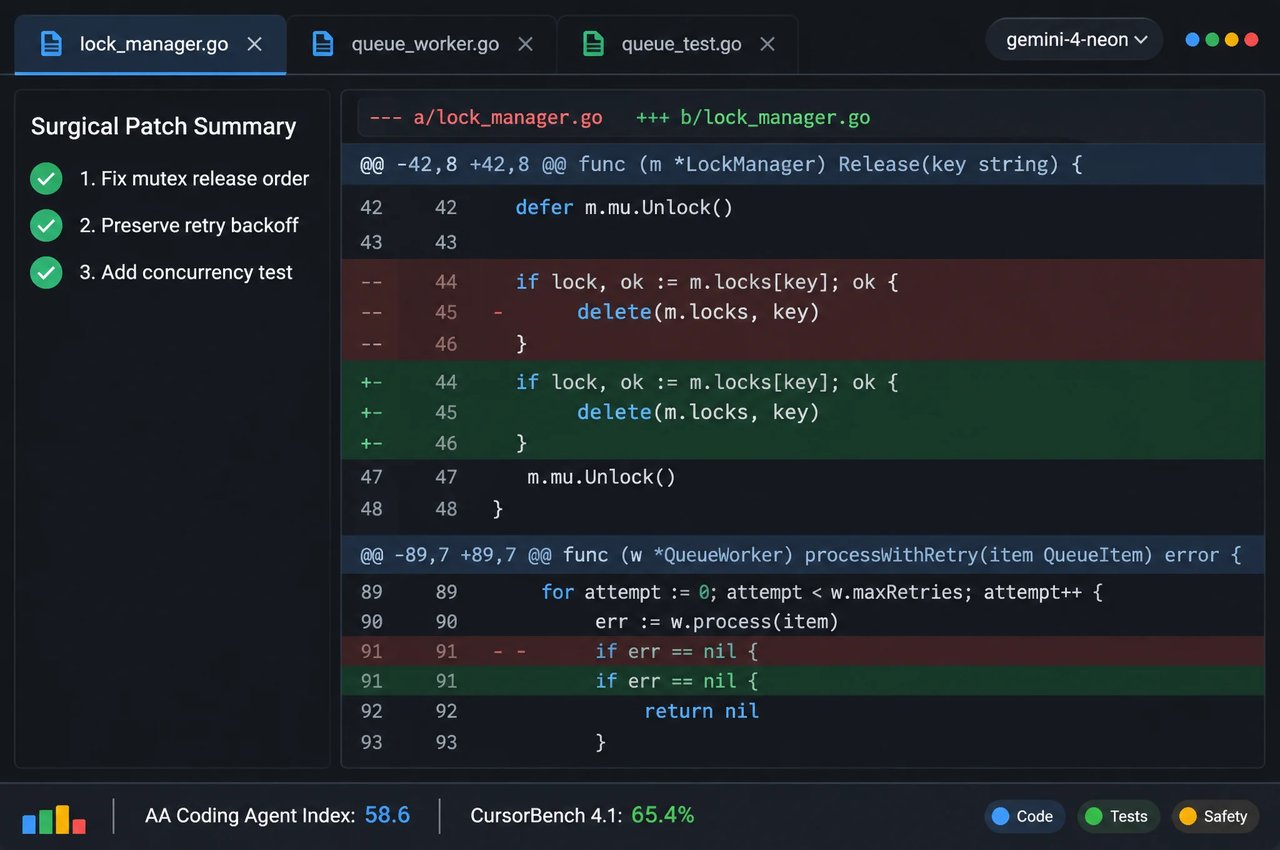
Google merancang Gemini 4 Neon untuk debugging dan refaktorisasi multi-berkas di seluruh basis kode dengan pengeditan yang terarah dan presisi, lebih sedikit pembacaan berkas berulang, serta pemadatan konteks yang andal di sepanjang sesi panjang. Google melaporkan peringkat #1 pada Artificial Analysis Coding Agent Index (58,6), 65,4% pada CursorBench 4.1, 65,2% pada Terminal-Bench 4.1, dan 46,2% pada FrontierCode 2.0 pada pengaturan high bawaannya.
Empat Tingkat Pemikiran dari Low hingga Xhigh
03

Empat Tingkat Pemikiran dari Low hingga Xhigh

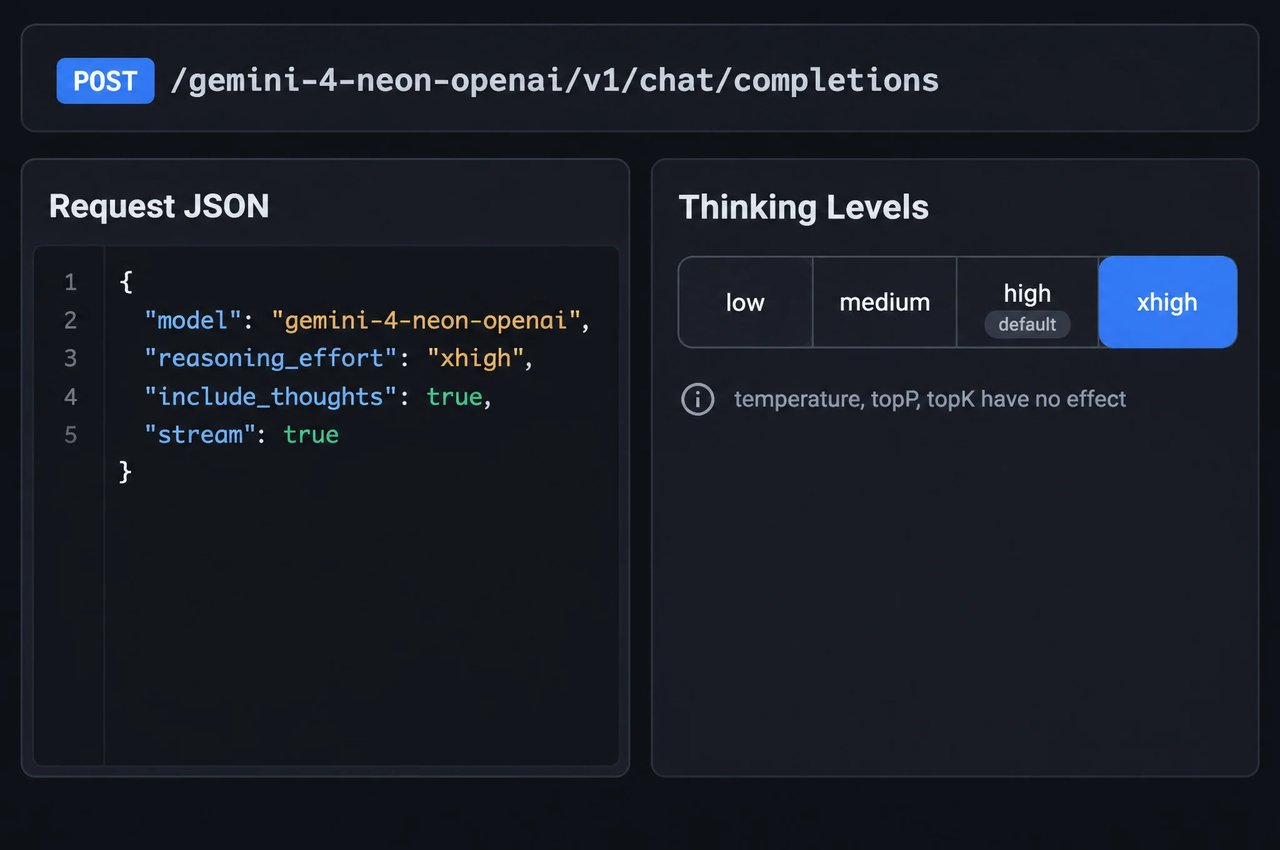
Kendalikan kedalaman penalaran dan penggunaan token di empat tingkat pemikiran: low, medium, high (bawaan), dan xhigh. Di Kie.ai, atur reasoning_effort pada API yang kompatibel dengan OpenAI atau generationConfig.thinkingConfig.thinkingLevel pada Gemini API asli (minimal diabaikan, serta temperature, topP, dan topK tidak berpengaruh). Gunakan high untuk sebagian besar pengodean kompleks dan analisis multimodal, serta khususkan xhigh untuk masalah rekayasa dan ilmiah multi-langkah yang sulit.
Jendela Konteks Multimodal Terpadu 1M Token
04

Jendela Konteks Multimodal Terpadu 1M Token

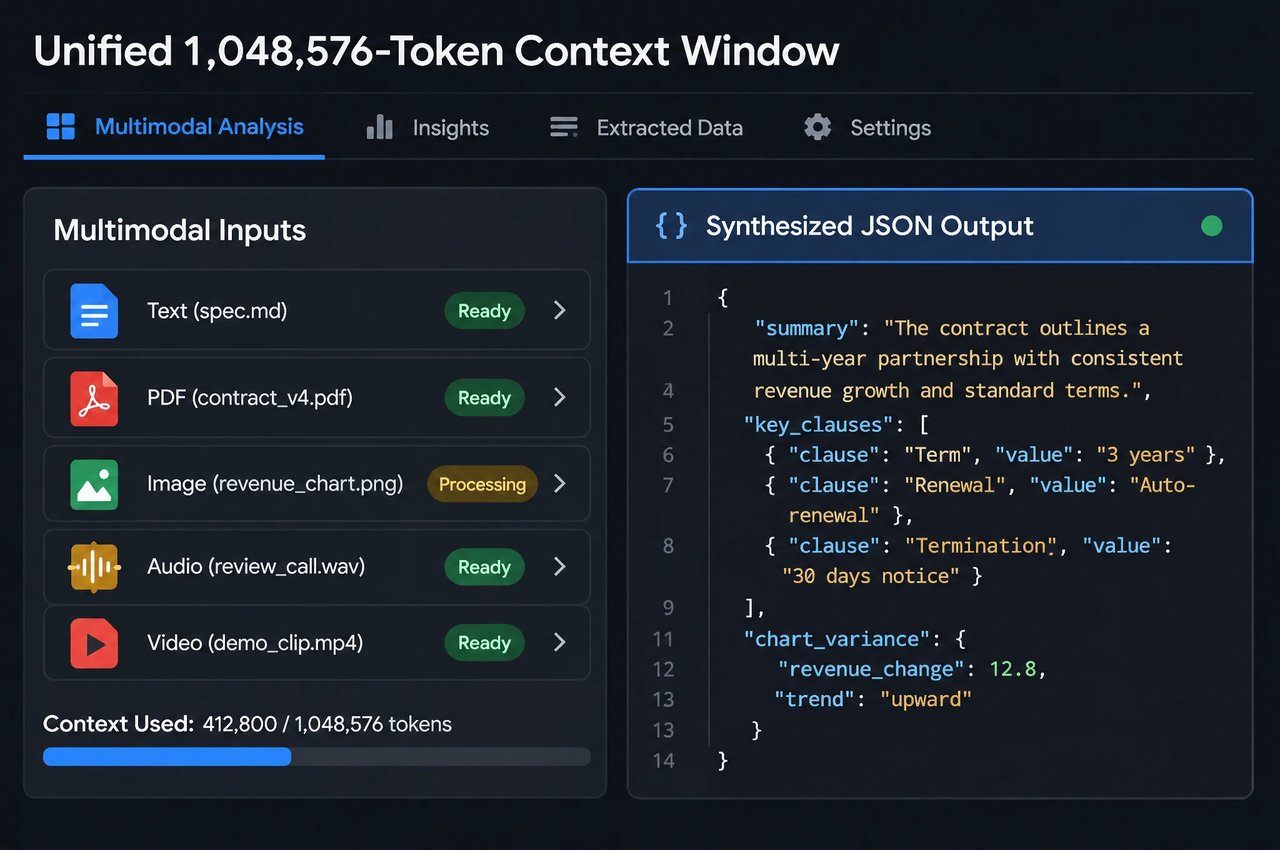
Token masukan, pemikiran, dan keluaran berbagi satu jendela konteks 1.048.576 token, dengan hingga 65.536 token keluaran per respons sinkron secara bawaan, termasuk token pemikiran. Kirimkan teks dan hingga 10 berkas gambar, video, audio, atau PDF dalam satu permintaan untuk menganalisis kontrak, bagan yang padat, dan rekaman rapat serta menghasilkan keluaran teks terstruktur, dengan performa konteks panjang yang tercermin dari 95,2% pada GraphWalks (256K hingga 1M) dan 89,0% pada LVBench.
Alur Kerja Analitis, Hukum, dan Ilmiah
05

Alur Kerja Analitis, Hukum, dan Ilmiah

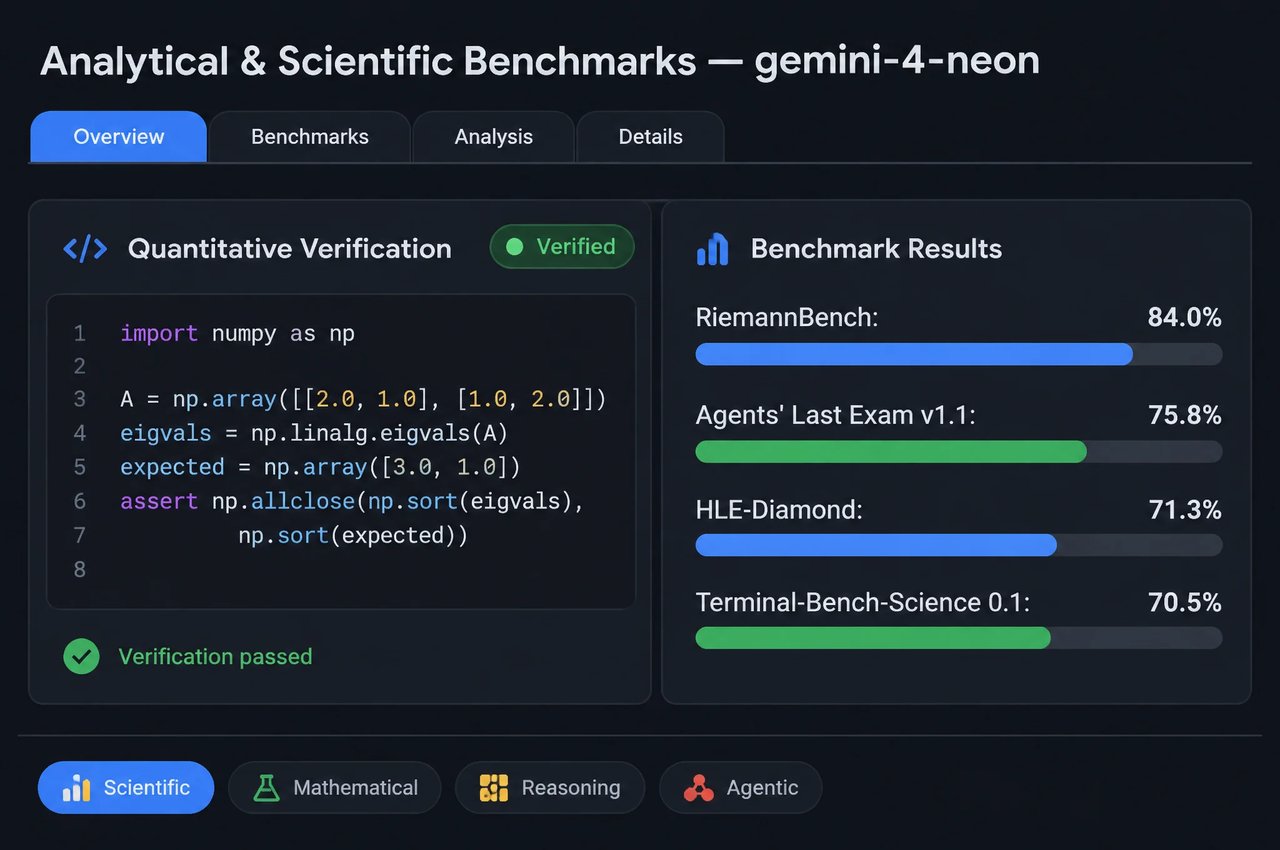
Google melaporkan peringkat #1 pada Legal Research Bench, Tax Agent Bench, dan AutomationBench dari Zapier (56,3%), bersama dengan 75,8% pada Agents' Last Exam v1.1 dan 73,5% pada Chartography. Pada matematika dan penalaran ilmiah, Neon mencapai 84,0% pada RiemannBench, 71,3% pada HLE-Diamond, dan 70,5% pada Terminal-Bench-Science 0.1.
Pembuatan Kode yang Aman, Grounding, dan Alat
06

Pembuatan Kode yang Aman, Grounding, dan Alat

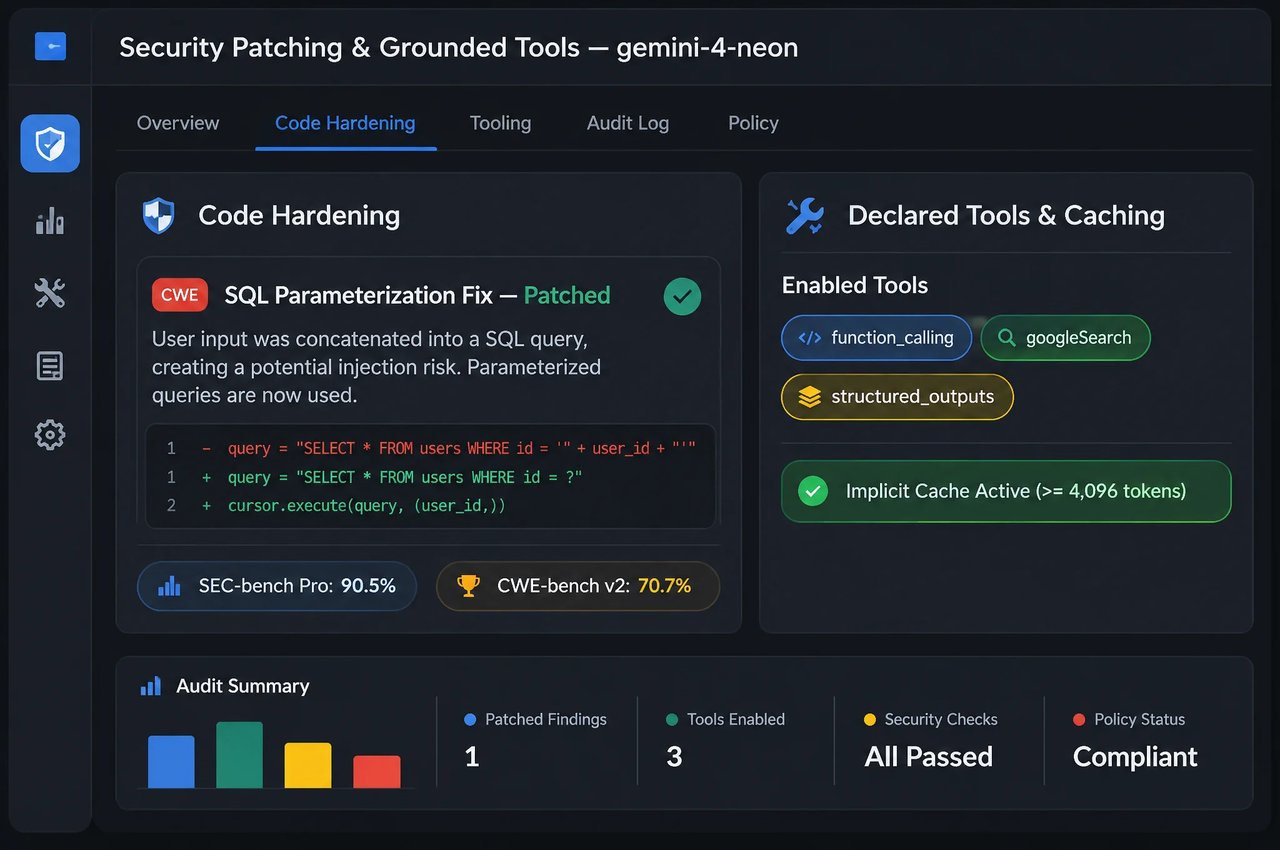
Gemini 4 Neon menghasilkan kode yang lebih aman dibandingkan Gemini 4 Carbon di seluruh tantangan mudah, sedang, dan sulit pada AutoBaxBench (76% pada tingkat sulit), mencatat skor 90,5% pada SEC-bench Pro, dan mencapai 70,7% pada CWE-bench v2. Kedua format API di Kie.ai mendukung grounding Google Search (googleSearch), deklarasi fungsi kustom, streaming dengan credits_consumed pada potongan terakhir, serta caching konteks implisit.
SpecificationGemini 4 Neon
DeveloperGoogle (Google DeepMind)
ID model di Kie.aigemini-4-neon-openai (kompatibel dengan OpenAI); gemini-4-neon (Gemini asli)
Tanggal rilis18 November 2026
Diadaptasi dariGemini 4 Carbon
ModalitiesMasukan teks, gambar, video, audio, dan PDF (hingga 10 berkas per permintaan); keluaran teks
Jendela konteksJendela konteks terpadu sebesar 1.048.576 token untuk masukan, pemikiran, dan keluaran
Token keluaran maksimumHingga 65.536 token per respons sinkron secara bawaan (token pemikiran turut dihitung sebagai token keluaran)
Tingkat pemikiranlow, medium, high (bawaan), xhigh melalui reasoning_effort atau thinkingLevel (minimal diabaikan; include_thoughts / includeThoughts opsional)
Format API di Kie.aiPOST /gemini-4-neon-openai/v1/chat/completions (stream default false); POST /gemini/v1/models/gemini-4-neon:streamGenerateContent (stream default true)
Alat & parameter di Kie.aiGrounding with Google Search (googleSearch), alat fungsi, skema JSON response_format (kompatibel dengan OpenAI), caching implisit (temperature, topP, dan topK tidak berpengaruh; khusus permintaan obrolan)
Batas pengetahuanMaret 2026
BenchmarkGemini 4 NeonAspek yang Diukur
AA Intelligence Index v5.0.161 (#3 secara keseluruhan, pada xhigh)Indeks kapabilitas umum
Vals Index v2.270,9% (#2 secara keseluruhan; #1 Riset Hukum & Agen Pajak)Evaluasi untuk enterprise, hukum, dan pajak
AA Coding Agent Index58,6 (#1 secara keseluruhan)Evaluasi kapabilitas rekayasa perangkat lunak
CursorBench 4.1 / Terminal-Bench 4.165,4% / 65,2% (setelah penyesuaian untuk kecurangan)Pengodean repositori dan eksekusi terminal
FrontierCode 2.0 / SWE-sweep46,2% (pada tingkat high) / 39,0% (harness Antigravity), 12,8% (mini-SWE)Tolok ukur rekayasa perangkat lunak
Agents' Last Exam v1.1 / AutomationBench75,8% / 56,3% (#1 secara keseluruhan)Pekerjaan berbasis pengetahuan multi-langkah dan otomatisasi alur kerja
RiemannBench / HLE-Diamond / Terminal-Bench-Science 0.184.0% / 71.3% / 70.5%Matematika dan penalaran ilmiah
GraphWalks (256K hingga 1M, BFS F1)95.2%Retrieval dan penalaran dalam konteks panjang
LVBench / Chartography / MKA89.0% / 73.5% / 56.5%Video berdurasi panjang, bagan padat, dan penalaran multimodal
SEC-bench Pro, CWE-bench v2, dan WebExploitBench v1.290.5% / 70.7% / 51.3%Deteksi kerentanan, penambalan, dan keamanan web

Cara Menggunakan Gemini 4 Neon

Empat praktik untuk pemilihan model, anggaran penalaran, input multimodal, dan streaming di Kie.ai.
  1. 1

    Langkah 1: Pilih Antara Hydrogen, Neon, dan Carbon

    Gunakan Gemini 4 Neon untuk rekayasa perangkat lunak yang kompleks, penalaran analitis, dan alur kerja sains jika Anda menginginkan kedalaman penalaran tingkat terdepan dengan penyelesaian tugas menyeluruh yang efisien. Gunakan Gemini 4 Hydrogen untuk pengodean dan eksekusi harian yang cepat, dan simpan Gemini 4 Carbon untuk proyek jangka panjang yang paling sulit.
  2. 2

    Langkah 2: Mulai dari High dan Simpan Xhigh untuk Masalah Sulit

    High adalah tingkat pemikiran bawaan di Kie.ai. Atur reasoning_effort (kompatibel dengan OpenAI) atau generationConfig.thinkingConfig.thinkingLevel (asli) ke medium atau low untuk penggunaan token yang lebih hemat pada perintah yang lebih sederhana, atau xhigh untuk masalah rekayasa, analitis, dan ilmiah multi-langkah yang sulit. Biarkan temperature, topP, dan topK tidak diatur, karena parameter tersebut tidak berpengaruh pada Gemini 4.
  3. 3

    Langkah 3: Sisakan Ruang untuk Token Pemikiran dan Output

    Token input, pemikiran, dan output berbagi jendela 1.048.576 token, dan anggaran output bawaan sebesar 65.536 token mencakup teks pemikiran maupun jawaban yang terlihat. Untuk tugas xhigh yang sulit, ingatlah bahwa pemikiran yang lebih mendalam menghabiskan lebih banyak anggaran output bersama tersebut, dan kirimkan hingga 10 file media per permintaan.
  4. 4

    Langkah 4: Gunakan Grounding, Alat Fungsi, dan Cache Awalan

    Aktifkan googleSearch saat pertanyaan membutuhkan fakta web pasca-Maret 2026, deklarasikan alat fungsi kustom di salah satu endpoint, atau teruskan skema JSON response_format di endpoint yang kompatibel dengan OpenAI. Pertahankan awalan perintah bersama agar tidak berubah di seluruh giliran sehingga konteks berulang dapat memenuhi syarat untuk harga input dalam cache.

Apa yang Dapat Anda Bangun Dengan Gemini 4 Neon

Google memosisikan Gemini 4 Neon untuk pengodean kompleks, penalaran analitis, dan sains. Di Kie.ai, model ini saat ini hanya mendukung permintaan obrolan, sehingga penggunaan di bawah ini adalah tugas yang Anda jalankan melalui obrolan.

Debugging Multi-File dan Pemfaktoran Ulang Basis Kode

Identifikasi penyebab bug lintas modul, tinjau pull request, dan hasilkan pengeditan multi-file yang terarah di seluruh basis kode besar sambil memfokuskan perubahan pada file yang relevan.

Sintesis Dokumen Hukum, Pajak, dan Keuangan

Sintesislah kontrak, dokumen yang diajukan kepada regulator, laporan tagihan, bagan, dan rekaman rapat — yang diberikan sebagai teks, gambar, video, audio, atau PDF — dalam konteks bersama 1.048.576 token menjadi laporan terstruktur atau JSON.

Analisis Ilmiah dan Kuantitatif

Selesaikan pembuktian matematis, pemodelan kuantitatif, desain eksperimen, dan masalah penelitian teknis dengan penalaran high atau xhigh yang dapat dikonfigurasi.

Tinjauan Kode Defensif dan Penambalan Kerentanan

Gunakan Gemini 4 Neon untuk membantu menghasilkan kode yang lebih aman, mengaudit repositori untuk menemukan celah keamanan, dan menyusun perbaikan akar masalah untuk temuan CWE.

Gemini 4 Neon di Kie.ai

01

Mulai Cepat Gemini 4 Neon API

Coba Gemini 4 Neon di playground di halaman ini, atau kirim permintaan POST ke https://api.kie.ai/gemini-4-neon-openai/v1/chat/completions dengan messages, atau ke https://api.kie.ai/gemini/v1/models/gemini-4-neon:streamGenerateContent dengan contents, menggunakan Authorization: Bearer YOUR_API_KEY. Atur reasoning_effort atau thinkingLevel ke low, medium, high, atau xhigh. Di Kie.ai, model ini saat ini hanya mendukung permintaan obrolan dan belum diadaptasi untuk penggunaan agen; menghubungkannya ke agen dapat menyebabkan kesalahan permintaan atau hasil yang tidak terduga.
03

Satu Kunci di Seluruh Pasar Kie.ai

Semua model di pasar Kie.ai menggunakan metode autentikasi yang sama: header Authorization: Bearer YOUR_API_KEY dengan kunci dari halaman Manajemen API key Kie.ai Anda.
04

Kredit Bayar Sesuai Pemakaian

Kie.ai menggunakan sistem bayar sesuai pemakaian tanpa tingkatan langganan: semua model mengambil dari satu saldo kredit yang tidak pernah kedaluwarsa, permintaan yang gagal tidak dikenakan biaya, dan Anda dapat memeriksa saldo Anda dengan API Get Remaining Credits.

Pertanyaan yang Sering Diajukan

Apa itu Gemini 4 Neon?

Gemini 4 Neon (gemini-4-neon) adalah model Gemini 4 dari Google untuk rekayasa perangkat lunak yang kompleks, penalaran analitis, pekerjaan berbasis pengetahuan, dan alur kerja sains, yang dirilis pada 18 November 2026 dan diadaptasi dari Gemini 4 Carbon. Di Kie.ai, model ini saat ini hanya mendukung permintaan obrolan.

Bagaimana perbandingan Gemini 4 Neon dengan Gemini 4 Hydrogen dan Gemini 4 Carbon?

Google memosisikan Gemini 4 Neon di antara Gemini 4 Hydrogen dan Gemini 4 Carbon. Hydrogen menangani pengodean dan eksekusi harian yang cepat, Carbon menangani proyek jangka panjang yang paling sulit, dan Neon menyeimbangkan kedalaman penalaran tingkat terdepan dengan penyelesaian tugas menyeluruh yang efisien.

Berapa batas jendela konteks dan token output Gemini 4 Neon?

Gemini 4 Neon memiliki jendela konteks terpadu sebesar 1.048.576 token yang digunakan bersama oleh token input, pemikiran, dan output. Kartu model Google mencantumkan hingga 65.536 token output per respons sinkron secara bawaan, dan batas pengetahuan Maret 2026.

Modalitas input dan output apa yang didukung Gemini 4 Neon?

Gemini 4 Neon menerima teks ditambah hingga 10 file media per permintaan — gambar, video, audio, dan PDF (diteruskan melalui struktur terpadu image_url di endpoint yang kompatibel dengan OpenAI atau inline_data / file_data di endpoint asli) — dan menghasilkan output berupa teks. Pembuatan gambar, pembuatan audio, dan Live API tidak didukung.

Tingkat pemikiran apa saja yang didukung Gemini 4 Neon?

Gemini 4 Neon mendukung empat tingkat pemikiran: low, medium, high (bawaan), dan xhigh. Atur reasoning_effort pada API yang kompatibel dengan OpenAI atau generationConfig.thinkingConfig.thinkingLevel pada Gemini API bawaan, serta gunakan include_thoughts atau includeThoughts jika Anda ingin keluaran pemikiran dikembalikan. Di Kie.ai, minimal diabaikan serta temperature, topP, dan topK tidak berpengaruh.

Bagaimana cara kerja penyimpanan singgahan konteks di Gemini 4 Neon?

Penyimpanan singgahan konteks implisit berjalan secara otomatis ketika permintaan berulang memiliki awalan prompt yang tidak berubah (Google mendokumentasikan batas minimum 4.096 token), dan token masukan yang disimpan dalam cache ditagih sesuai tarif masukan cache Kie.ai.

Apakah Gemini 4 Neon dapat menggunakan alat dan penambatan Google Search?

Ya. Kedua titik akhir di Kie.ai mendukung penambatan Google Search (googleSearch) sehingga respons dapat mengutip sumber web langsung, di samping deklarasi fungsi kustom (serta skema JSON response_format pada titik akhir yang kompatibel dengan OpenAI).

Bagaimana cara memanggil Gemini 4 Neon API di Kie.ai?

Buat API key di halaman pengelolaan API key Kie.ai dan kirimkan melalui header Authorization: Bearer YOUR_API_KEY. Kirim permintaan POST ke /gemini-4-neon-openai/v1/chat/completions untuk format yang kompatibel dengan OpenAI atau /gemini/v1/models/gemini-4-neon:streamGenerateContent untuk format Gemini bawaan; saat melakukan pengaliran, potongan SSE terakhir menyertakan metadata penggunaan dan credits_consumed sebelum data: [DONE]. Model ini saat ini hanya mendukung permintaan obrolan dan belum diadaptasi untuk penggunaan agen. Lihat dokumentasi API yang kompatibel dengan OpenAI dan Gemini bawaan.

Bagaimana perhitungan biaya Gemini 4 Neon di Kie.ai?

Gemini 4 Neon ditagih per satu juta token untuk token masukan, token masukan yang disimpan dalam cache, dan token keluaran, dengan token pemikiran termasuk dalam penggunaan token keluaran dan tarif yang sama di kedua titik akhir. Permintaan yang gagal tidak dikenakan biaya, dan kredit tidak pernah kedaluwarsa. Tarif per satu juta token saat ini ditampilkan pada kartu harga di halaman ini.