01
Transkripsi dalam 40 Bahasa
NVIDIA mengelompokkan 40 bahasa transkripsinya ke dalam tiga tingkatan: 13 Unggulan, 15 Siap Produksi, dan 12 Didukung. Model ini dapat mendeteksi bahasa yang diucapkan secara otomatis.
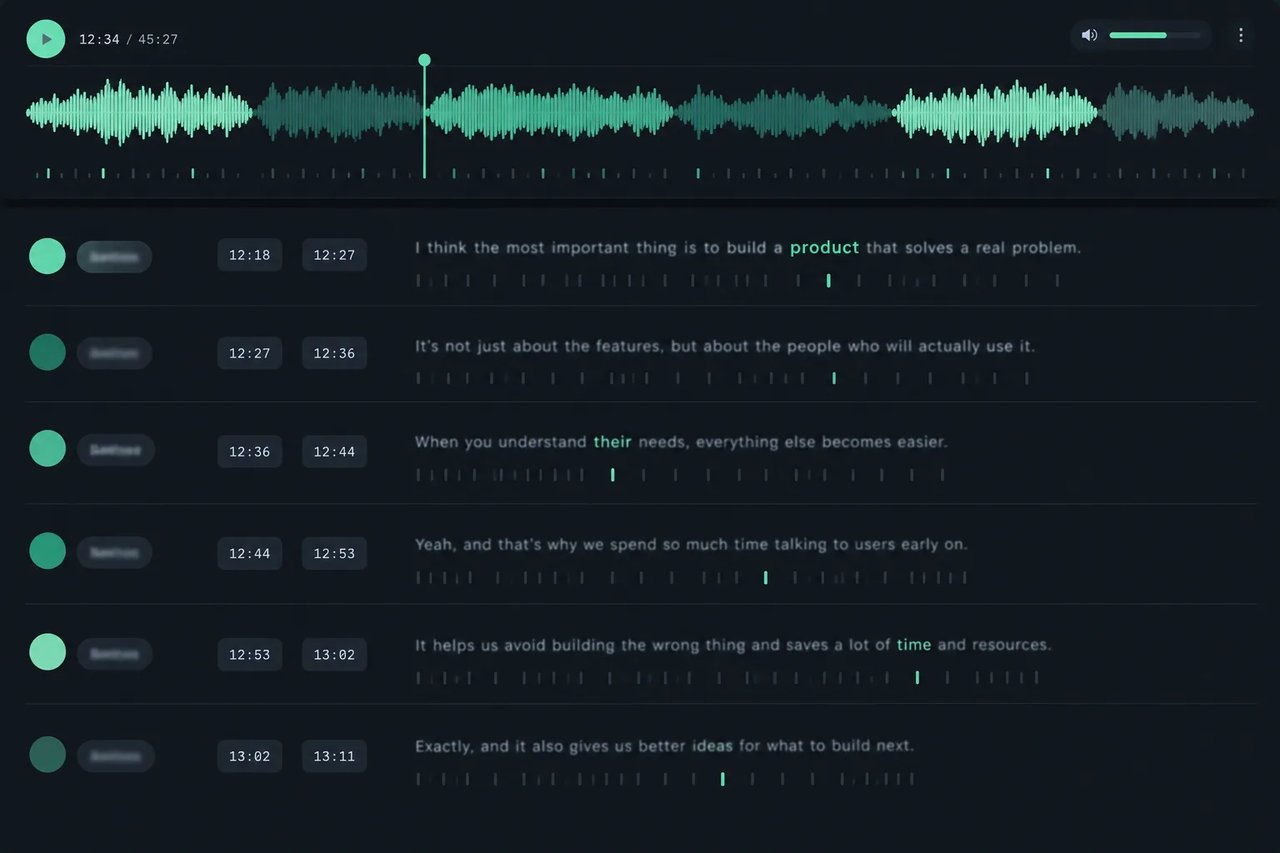
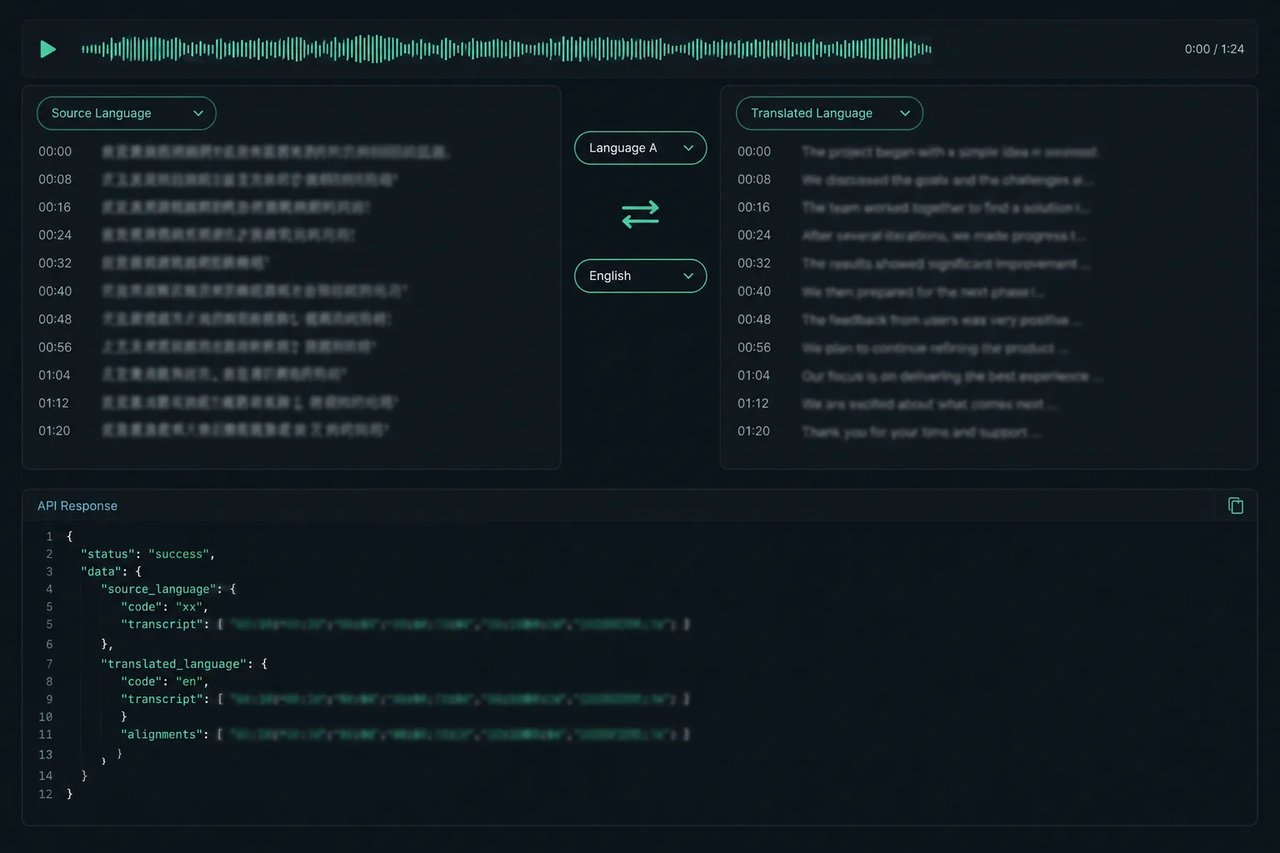
Dibuat oleh NVIDIA untuk pengenalan ucapan, Nemotron 3.5 Transcribe dapat mengembalikan transkrip, timestamps tingkat kata, label pembicara, dan terjemahan ucapan antara bahasa Inggris dan 31 bahasa dalam satu permintaan API di Kie.ai.
Click to upload or drag and drop
Supported formats: MP4, QUICKTIME, WEBM Maximum file size: 200MB; Supported formats: MPEG, WAV, X-WAV, AAC, MP4, OGG, FLAC, OPUS Maximum file size: 200MB
Audio to transcribe: a publicly downloadable URL. Common formats work (MP3, WAV, M4A/AAC, FLAC, OGG/Opus, WEBM), and so do videos with an audio track (MP4, MOV); only the sound is used. Up to 60 minutes and 200 MB per file. The language is detected automatically.
Also return word-level start and end times and speaker labels in the result file. Transcription only: not available together with target_language. The example output was produced with timestamps on and lists only the first 40 words; the API result file contains every word.
Leave empty (default) to transcribe in the spoken language. Pick a language to translate the speech into it instead. Translation is guaranteed between English and the other listed languages: non-English speech into English (en), or English speech into another language.
Complete guide to using nvidia/nemotron-3-5-transcribe
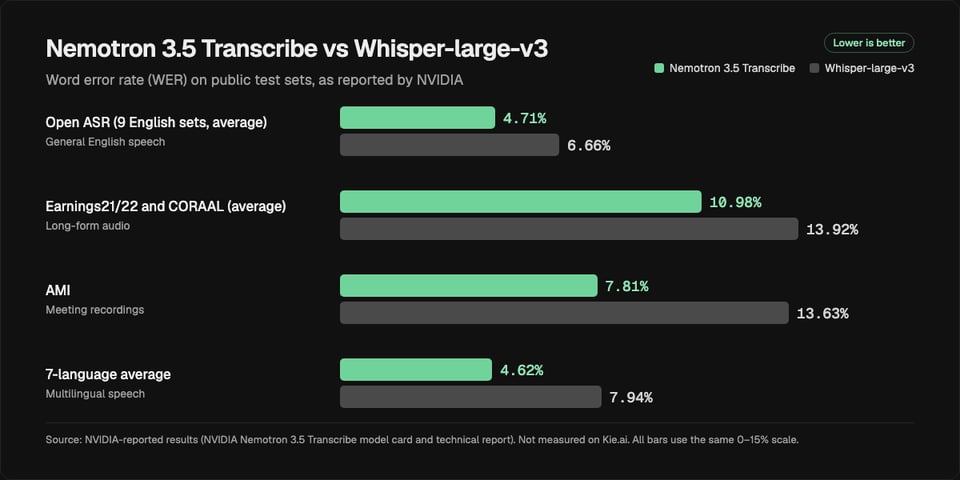
| Set pengujian | Cakupan | Nemotron 3.5 Transcribe | Whisper-large-v3 |
|---|---|---|---|
| Open ASR (9 set bahasa Inggris, rata-rata) | Ucapan bahasa Inggris umum | 4.71% | 6.66% |
| Earnings21/22 dan CORAAL (rata-rata) | Audio berdurasi panjang | 10.98% | 13.92% |
| AMI | Rekaman rapat | 7.81% | 13.63% |
| Rata-rata 7 bahasa | Ucapan multibahasa | 4.62% | 7.94% |