Automatically append previous messages to maintain multi-turn context. May increase token usage.
How can I help you today?
README
Complete guide to using deepseek-v4-1-flash
DeepSeek V4.1 Flash API untuk Obrolan Multimodal
DeepSeek merancang V4.1 Flash untuk kapabilitas yang lebih besar, inferensi yang lebih cepat, dan kapasitas pemrosesan yang lebih tinggi: model MoE 552B parameter yang hanya menggunakan 8B parameter aktif untuk masukan dan 16B untuk keluaran, membaca gambar dan teks secara bawaan serta, menurut kartu modelnya, mendukung konteks hingga satu juta token. Pembaruan 17 Oktober, DeepSeek V4.1 Flash 1017, mempertahankan nama model dan format permintaan yang sama. Di Kie.ai, Anda memanggil DeepSeek 4.1 Flash API pada titik akhir /openai/v1/responses yang kompatibel dengan OpenAI Responses.
Parameter DeepSeek V4.1 Flash API di Kie.ai
| Parameter | Value |
|---|---|
| Model | deepseek-v4-1-flash |
| Endpoint | POST /openai/v1/responses, compatible with the OpenAI Responses API |
| Jendela konteks | Hingga 1M token (kartu model Hugging Face DeepSeek) |
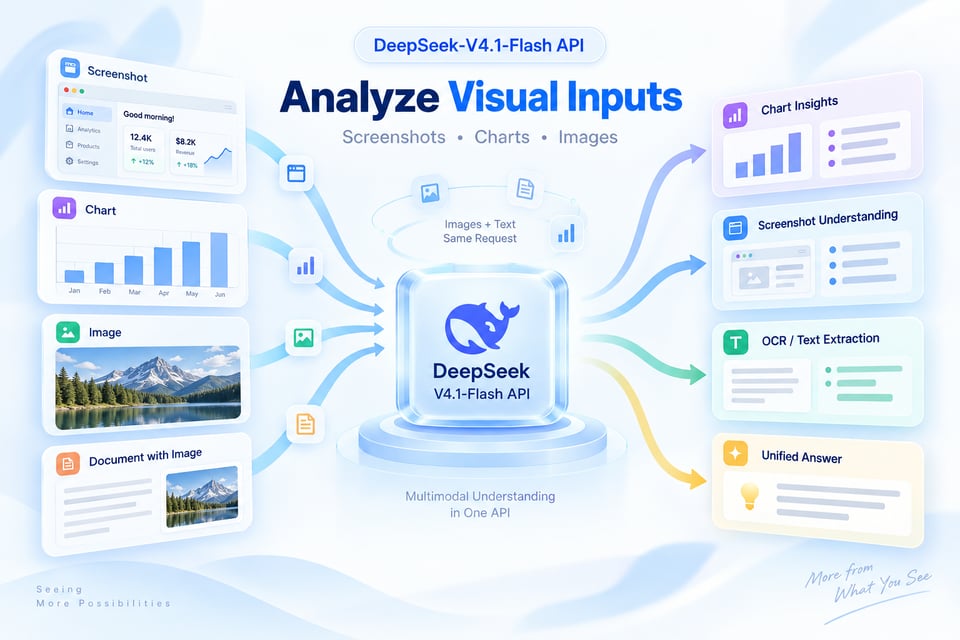
| Jenis masukan | Teks dan gambar (bagian input_text dan input_image dalam satu pesan); keluaran berupa teks |
| Thinking | Aktif secara default; reasoning.effort menerima none, minimal, low, medium, high, xhigh, dan max (none menonaktifkan proses berpikir) |
| Tools | Hanya alat fungsi; tool_choice auto (default), required, atau satu fungsi bernama |
| Keluaran terstruktur | text.format json_object atau json_schema |
| Streaming | stream true atau false |
| Tidak didukung | max_output_tokens, temperature, dan top_p tidak berpengaruh pada model ini |
| Architecture | MoE 552B parameter, Enkoder-Dekoder Kausal, 8B parameter aktif untuk masukan dan 16B untuk keluaran (DeepSeek) |
Fitur Utama DeepSeek V4.1 Flash API
Pemahaman Gambar Bawaan
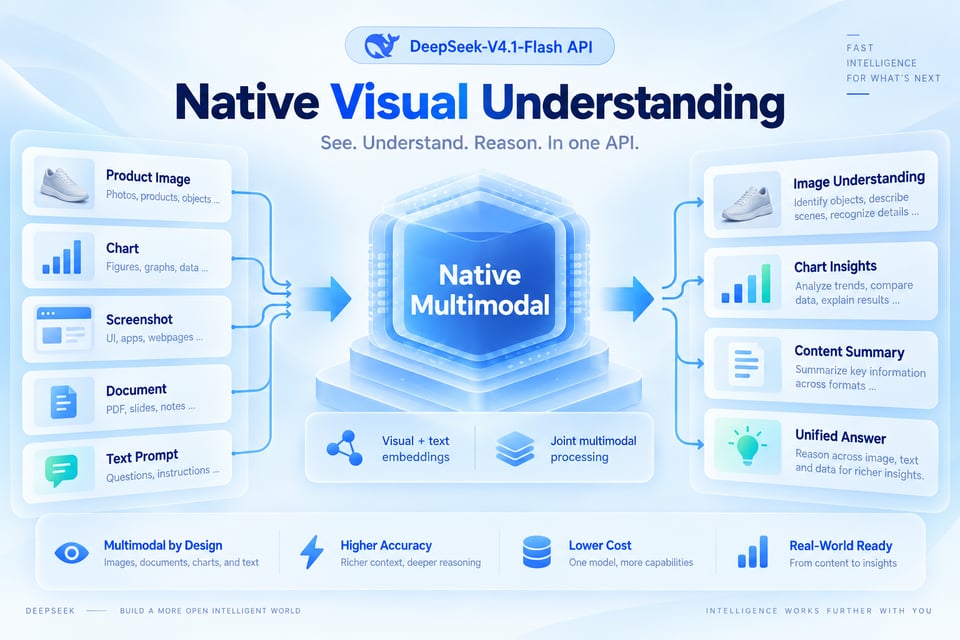
DeepSeek V4.1 Flash memproses gambar dan teks secara bawaan. Gabungkan bagian input_image dan input_text dalam satu pesan; image_url menerima URL yang dapat diakses publik atau rangkaian base64 data:image. Dalam pengujian kami di Kie.ai, model ini membaca judul utama pada gambar spanduk secara tepat dan menyebutkan matahari yang bersinar di dalam gambar tersebut.
Arsitektur MoE Efficient 552B
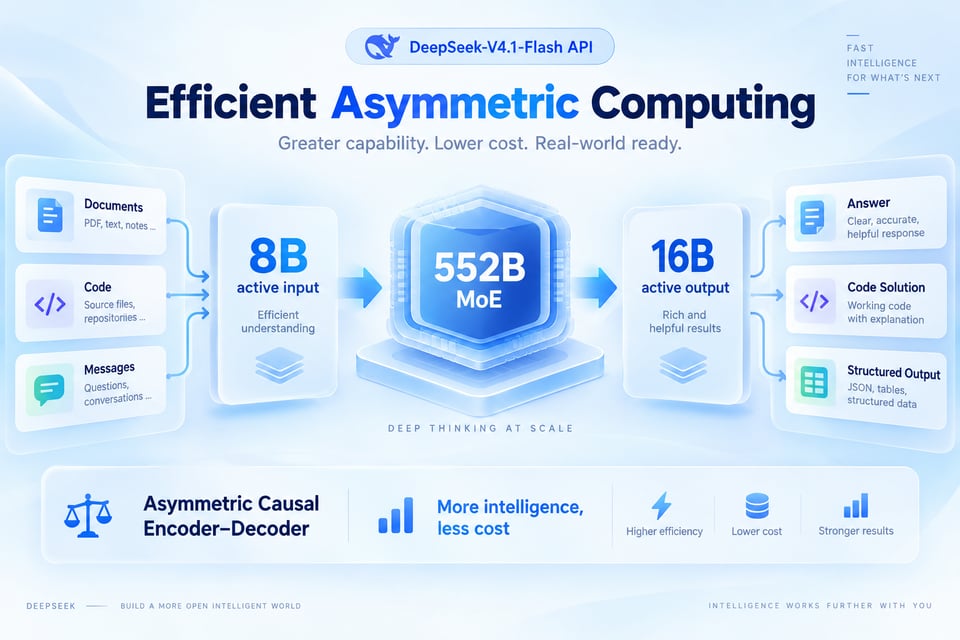
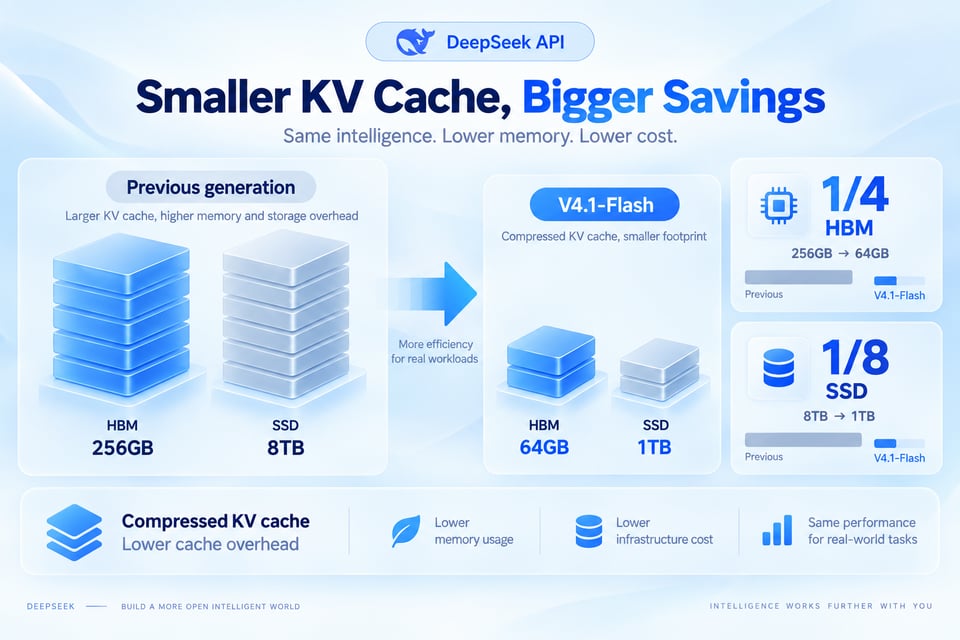
DeepSeek mendeskripsikan V4.1 Flash sebagai model terkecil dalam keluarga arsitektur barunya: model Mixture-of-Experts 552B parameter pada arsitektur Enkoder-Dekoder Kausal yang hanya menggunakan 8B parameter aktif untuk masukan dan 16B untuk keluaran. DeepSeek melaporkan KV cache yang membutuhkan 1/4 HBM dan 1/8 penyimpanan SSD dibandingkan generasi sebelumnya.
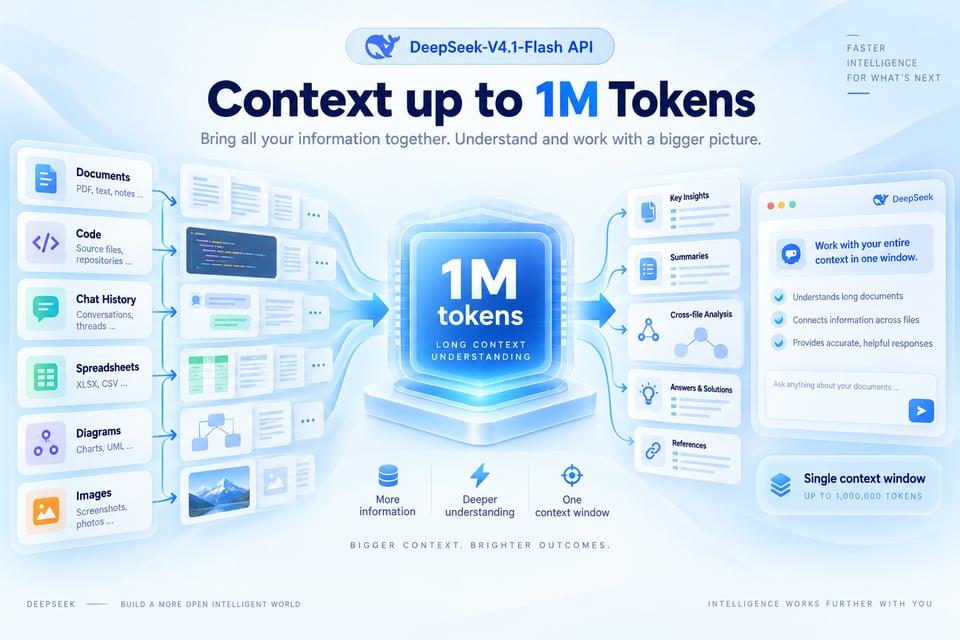
Hingga 1M Token Konteks
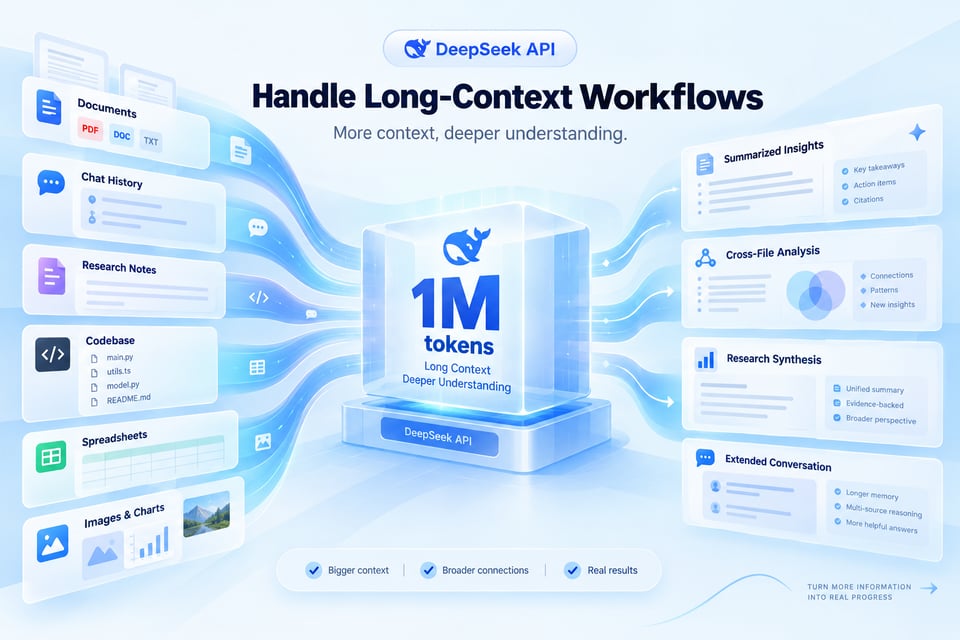
Menurut kartu model DeepSeek, V4.1 Flash menangani konteks hingga satu juta token, yang memberikan ruang untuk dokumen panjang dan basis kode besar. Dokumentasi Kie.ai tidak mencantumkan batas konteks terpisah untuk model ini.
Proses Berpikir yang Dapat Ditingkatkan atau Dinonaktifkan
Model ini melakukan proses berpikir secara default. Atur reasoning.effort ke none untuk menonaktifkan proses berpikir, minimal agar tetap ringkas, atau low, medium, high, xhigh, atau max untuk penalaran yang lebih mendalam.
Alat Fungsi dan Keluaran JSON
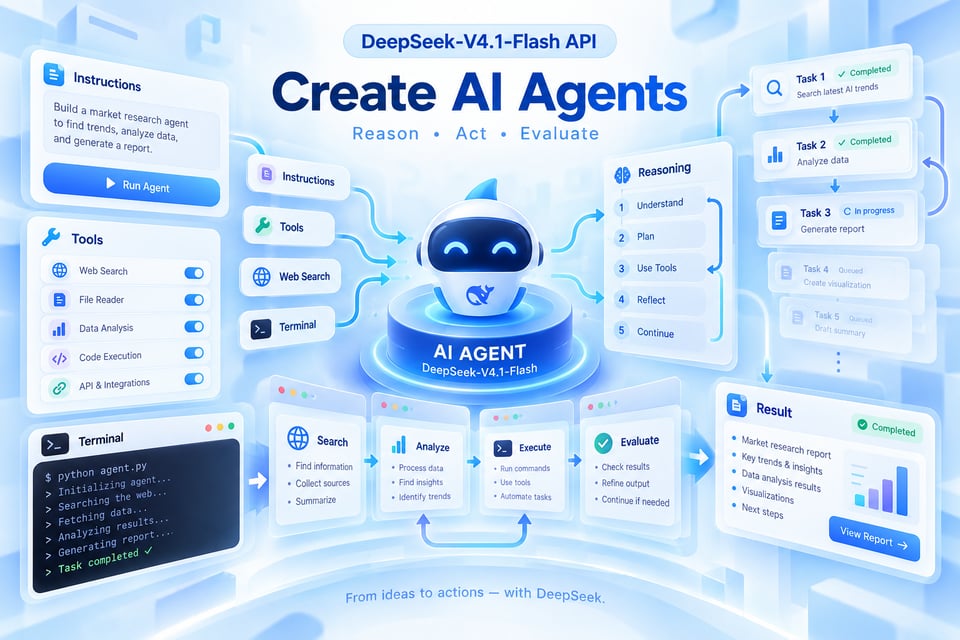
Deklarasikan alat fungsi dan biarkan model memilih dengan tool_choice auto, wajibkan pemanggilan, atau tetapkan satu fungsi bernama; kirim kembali hasilnya sebagai function_call_output yang dipasangkan berdasarkan call_id. Atur text.format ke json_object atau json_schema untuk keluaran yang dapat diurai oleh kode Anda.
Pembaruan 1017, Integrasi yang Sama
DeepSeek V4.1 Flash 1017, yang dirilis pada 17 Oktober 2026, menghadirkan apa yang disebut DeepSeek sebagai performa tolok ukur yang lebih kuat, penyelesaian tugas yang lebih cepat, dan keluaran yang lebih singkat dibandingkan versi sebelumnya. Nama model, titik akhir, dan format permintaan tidak berubah, sehingga integrasi yang ada tetap berfungsi.
Hasil Tolok Ukur DeepSeek V4.1 Flash 1017 vs Versi Sebelumnya
Hasil yang dilaporkan DeepSeek dari kartu model Hugging Face miliknya untuk pembaruan 1017. Terminal-Bench 4.0 dijalankan dengan kerangka uji Claude Code dan DeepSWE v1.1 dengan kerangka uji Mini-SWE-V2.
| Benchmark | V4.1 Flash 1017 | V4.1 Flash Sebelumnya |
|---|---|---|
| HLE (tanpa alat) | 42.6 | 36.8 |
| Terminal-Bench 4.0 | 42.3 | 31.2 |
| DeepSWE v1.1 | 77.0 | 74.2 |
| ProgramBench | 29.1 | 20.3 |
| NL2Repo-Bench | 68.2 | 65.4 |
| Apex Bench v1.1 | 72.1 | 64.6 |
| Chartography (dengan alat) | 83.0 | 78.9 |
| BabyVision (dengan alat) | 92.5 | 89.6 |
Cara Menggunakan API DeepSeek V4.1 Flash di Kie.ai
Langkah 1. Dapatkan API Key Anda
Langkah 2. Kirim Permintaan
Langkah 3. Tambahkan Gambar, Alat, dan Keluaran JSON
Mengapa Menggunakan API DeepSeek V4.1 Flash di Kie.ai
Kunci yang Sama di Seluruh Pasar Kie.ai
Semua model di pasar Kie.ai menggunakan metode autentikasi yang sama: header Authorization: Bearer YOUR_API_KEY dengan kunci dari halaman Manajemen API Key Kie.ai Anda.
Kredit Gratis dan Satu Saldo
Pengguna baru Kie.ai mendapatkan 80 kredit gratis untuk pengujian. Akun Anda memiliki satu saldo kredit yang digunakan oleh semua layanan pembuatan, dan Anda dapat memeriksanya dengan API Get Remaining Credits.
Tanpa Perlu Hosting atau Instalasi
Kie.ai menyediakan model ini sebagai API dengan area uji coba; tidak ada aplikasi yang perlu diunduh atau diinstal. Tidak ada GPU atau bobot model yang perlu dikelola.
Apa yang Dapat Anda Bangun dengan API DeepSeek V4.1 Flash
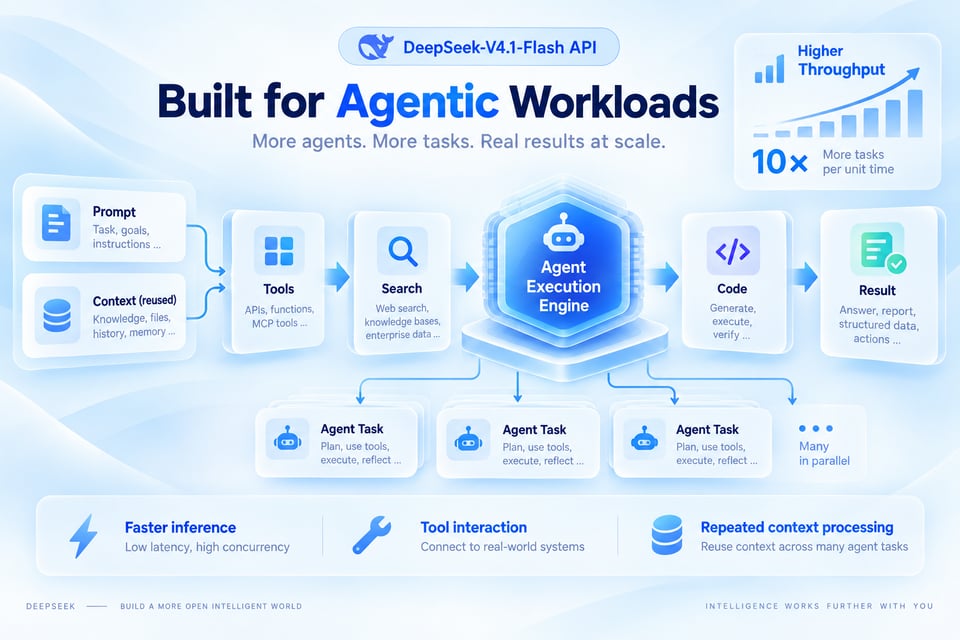
DeepSeek merancang V4.1 Flash untuk inferensi yang lebih cepat dan throughput yang lebih tinggi. Untuk model bobot terbuka yang lebih besar dengan jendela konteks 1 juta token pada endpoint yang sama, lihat API Kimi K3.1 Pro.
Obrolan dan Tanya Jawab pada Gambar
Menjawab pertanyaan tentang tangkapan layar, bagan, spanduk, dan foto beserta teks dalam pesan yang sama.
Pertanyaan Dokumen Panjang dan Basis Kode
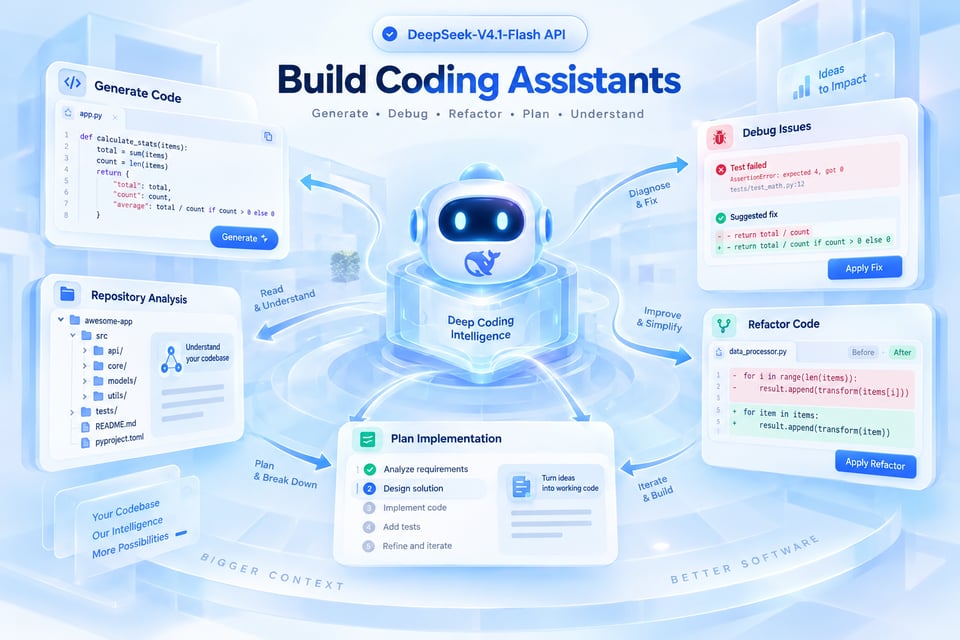
Memproses dokumen panjang atau basis kode besar dalam satu permintaan; kartu model DeepSeek mencantumkan konteks hingga satu juta token.
Ekstraksi Terstruktur
Mengekstrak bidang dari teks atau gambar ke dalam JSON yang mengikuti skema Anda dengan text.format json_schema.
Fitur Obrolan Bervolume Tinggi
Mendukung fitur obrolan yang mengutamakan throughput, dengan proses berpikir dikurangi atau dinonaktifkan untuk permintaan sederhana.