Automatically append previous messages to maintain multi-turn context. May increase token usage.
How can I help you today?
README
Complete guide to using gpt-6-2-astra
GPT-6.2 Astra API pour l'ingénierie complexe, la science et le travail professionnel

curl https://api.kie.ai/codex/v1/responses \-H "Authorization: Bearer $KIE_API_KEY" \-H "Content-Type: application/json" \-d '{"model": "gpt-6-2-astra","input": "Design an idempotent webhook handler for payment retries.","reasoning": { "effort": "medium" },"stream": false}'
Capacités clés de GPT-6.2 Astra


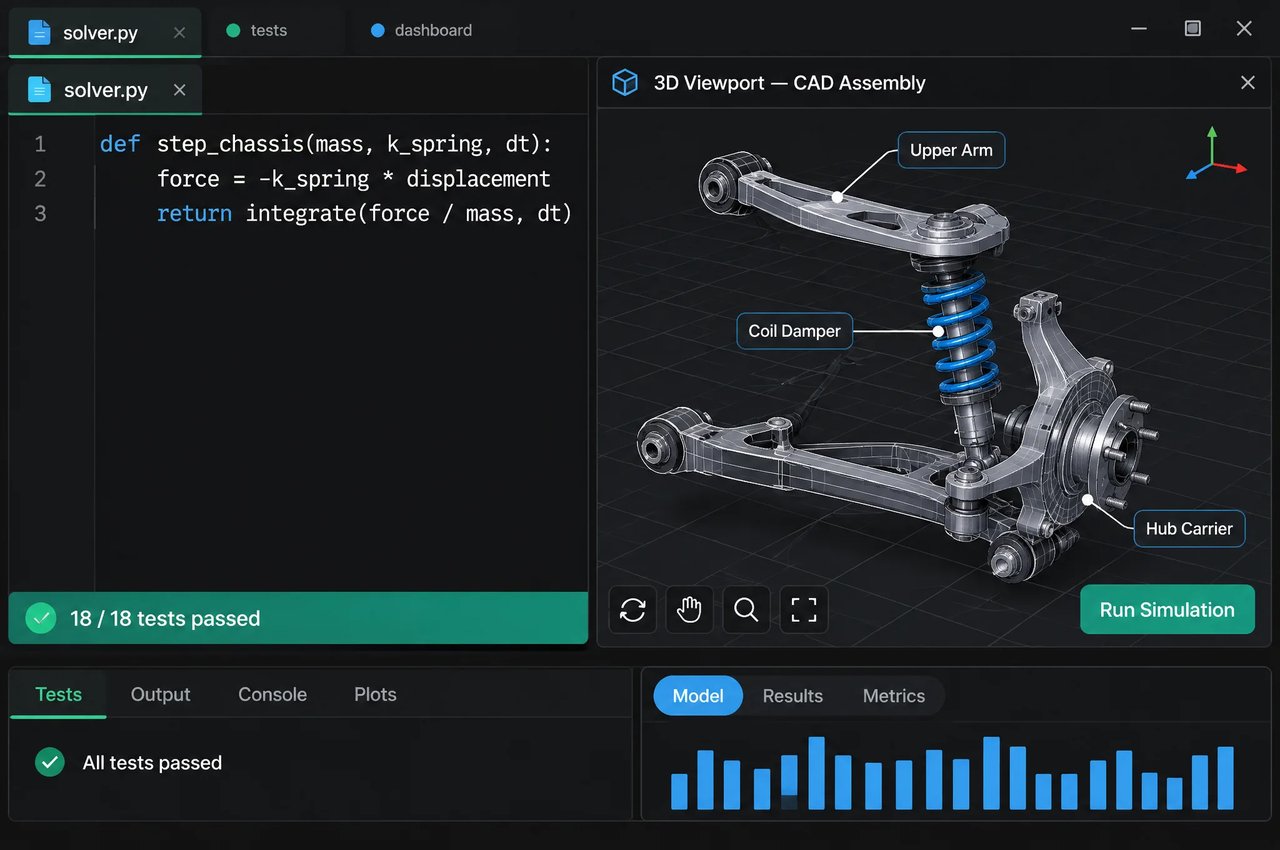
Code plus propre, interfaces web et conception 3D

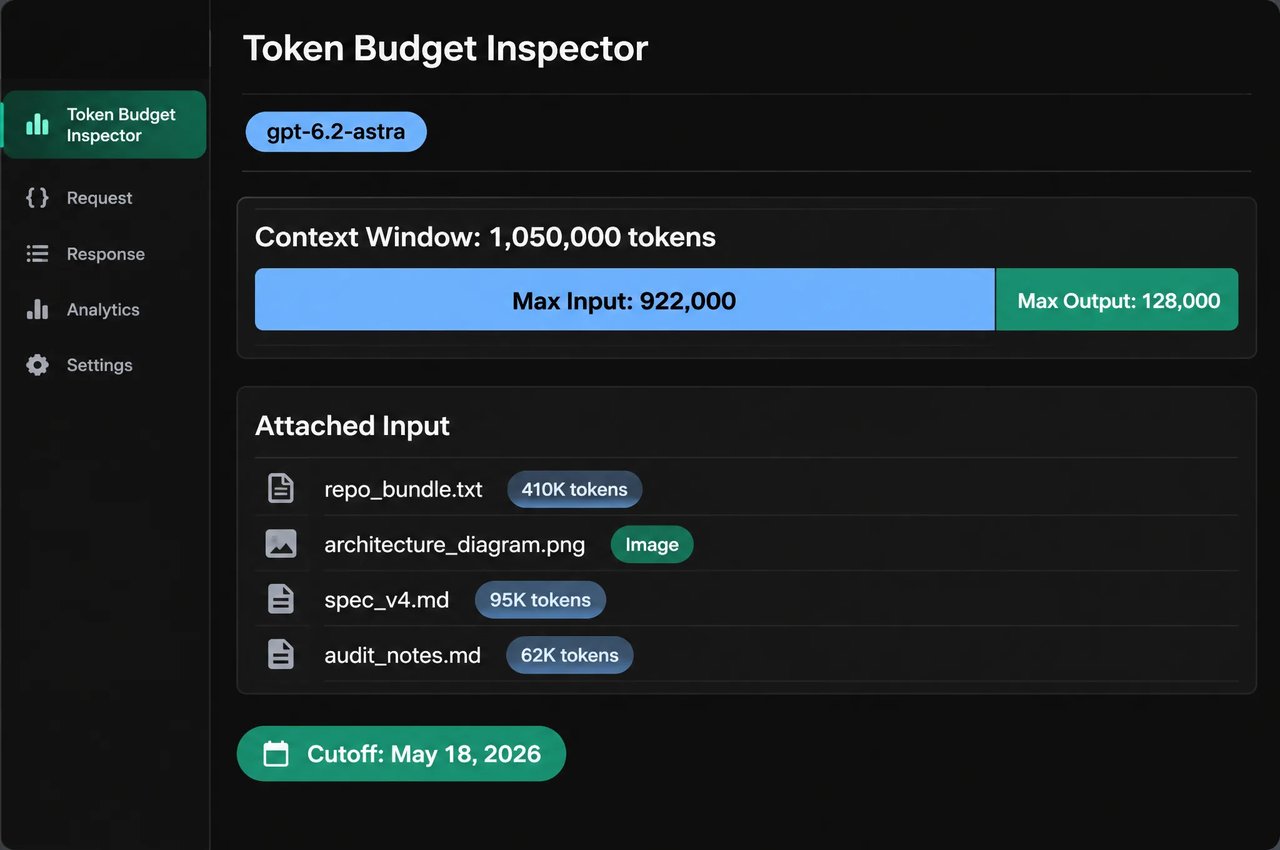
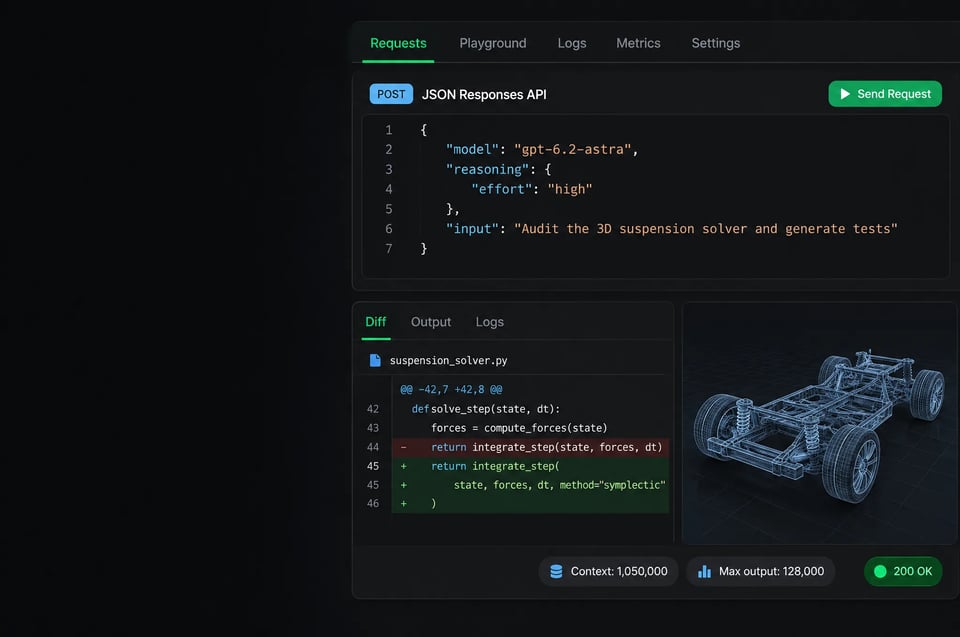
Contexte de 1 050 000 tokens et jusqu'à 128 000 tokens en sortie

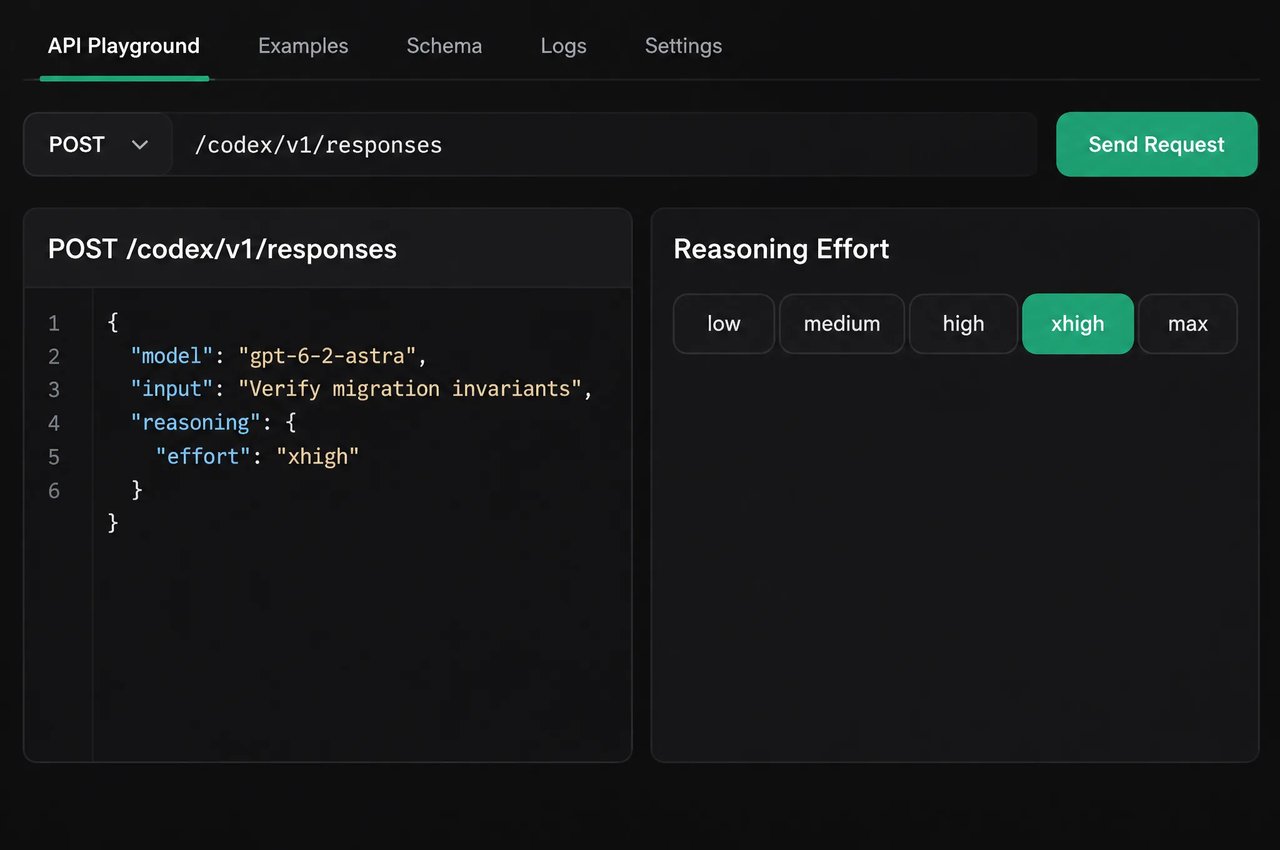
Cinq niveaux d'effort de raisonnement de low à max

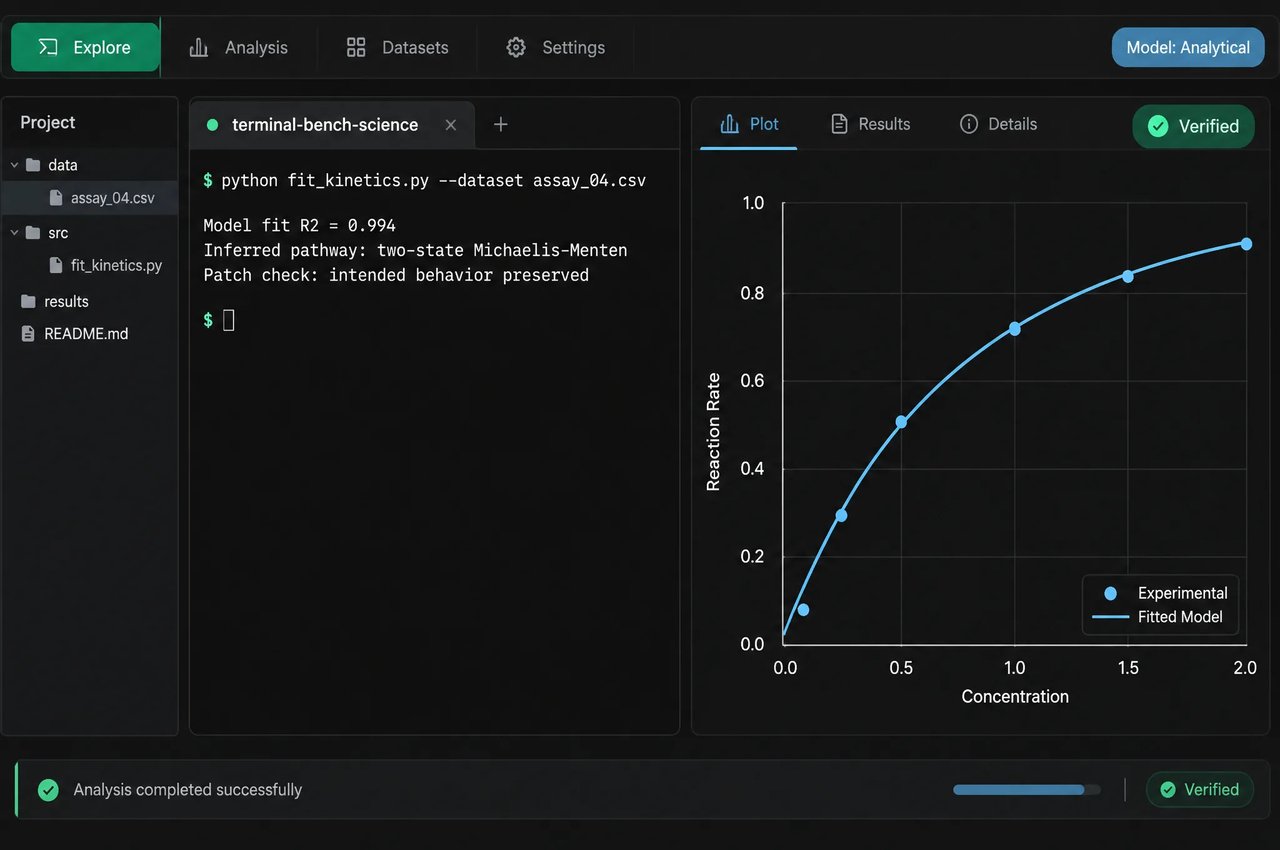
Recherche scientifique et sécurité défensive

Outils de la Responses API et raisonnement préservé
Spécifications de GPT-6.2 Astra
Spécifications de GPT-6.2 Astra issues de la documentation d'OpenAI, accompagnées des détails du point de terminaison Kie.ai.
| Specification | GPT-6.2 Astra |
|---|---|
| Developer | OpenAI |
| ID du modèle | gpt-6-2-astra sur Kie.ai (gpt-6.2-astra également accepté) |
| Date de sortie | 17 novembre 2026 |
| Modalities | Entrée texte et image ; sortie texte (audio et vidéo non pris en charge) |
| Fenêtre de contexte | 1 050 000 tokens (jusqu'à 922 000 tokens en entrée) |
| Tokens max. en sortie | 128 000 tokens |
| Effort de raisonnement | low, medium, high, xhigh, max |
| Point de terminaison et outils Kie.ai | POST /codex/v1/responses; custom function calling or web_search (one per request); text, input_image and input_file |
| Fonctionnalités Kie.ai | Streaming (par défaut), appel de fonctions ou recherche web (un par requête), entrée d'image et de fichier, mise en cache de prompt |
| Paramètres et fonctionnalités non pris en charge | Paramètres : temperature, top_p, logprobs, top_logprobs ; fonctionnalités : fine-tuning, sorties prédites |
| Date limite des connaissances | 18 mai 2026 |
Points forts de GPT-6.2 Astra dans les tests de référence
Résultats d’évaluation publiés par OpenAI dans son annonce de lancement du 17 novembre 2026, ses publications de lancement et sa fiche système.
| Benchmark | Résultat de GPT-6.2 Astra | Ce qui est mesuré |
|---|---|---|
| Agents' Last Exam | +5,2 points par rapport à GPT-6 Astra (nouveau record) | Processus professionnels de longue haleine en plusieurs étapes |
| Terminal-Bench-Science 0.1 | +9 points de pourcentage par rapport à GPT-6 Astra (nouveau record) | Travaux scientifiques réalisés dans un terminal |
| GDPval v2 | +6,2 points de pourcentage par rapport à GPT-6 Astra avec 22 % de jetons de sortie en moins | Missions de conseil, de finance et de conception en plusieurs étapes |
| AA-AnalystAgent | 62,5 % des questions ont reçu une réponse correcte lors de chacune des 5 tentatives indépendantes (nouveau record) | Analyse financière et analyse des dépenses à partir de feuilles de calcul et de rapports réels |
| AA-3D | 1 318 Elo, classé premier (GPT-6.2 Sol : 1 259 Elo) | Préférences humaines évaluées à l’aveugle sur des créations 3D interactives dans un navigateur |
| BenchCAD 2.1 Core | Amélioration de 32 % par rapport à GPT-6 Astra | Construction de pièces et d’assemblages 3D à partir de dessins techniques |
| Évaluations de cybersécurité | Cibles de la fiche système : 36,4 % résolues contre 18,2 % pour GPT-6 Astra ; ExploitBench Internal Port : +22 points par rapport à GPT-6 Astra | Évaluations de sécurité distinctes publiées par OpenAI |
Comment travailler avec GPT-6.2 Astra
- 1
Étape 1 : choisir entre GPT-6.2 Astra et GPT-6.2 Sol
Utilisez GPT-6.2 Astra pour vos projets les plus complexes en ingénierie, recherche scientifique, livrables professionnels, interfaces utilisateur et conception 3D. Pour le développement au quotidien, OpenAI recommande de commencer par GPT-6.2 Sol, son modèle efficace et polyvalent pour les tâches courantes. - 2
Étape 2 : régler l’effort de raisonnement de low à max
Sur Kie.ai, transmettez reasoning.effort avec la valeur low, medium, high, xhigh ou max dans /codex/v1/responses. OpenAI recommande de commencer avec medium pour une nouvelle intégration, ou de remplacer les anciens réglages none et minimal par low. Omettez temperature, top_p, logprobs et top_logprobs. - 3
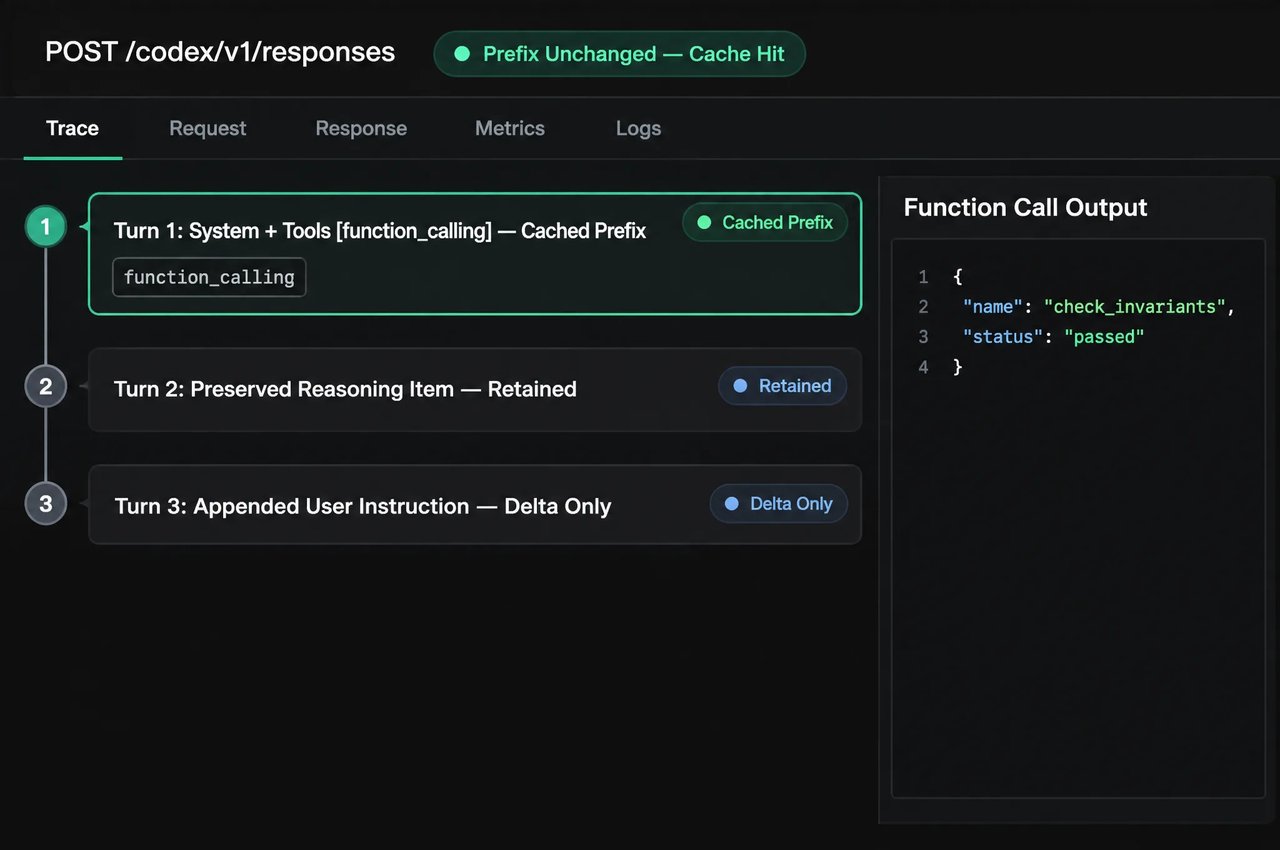
Étape 3 : conserver les préfixes des invites inchangés
À partir de GPT-6.2, l’API d’OpenAI supprime les éléments de raisonnement lorsqu’elle détecte des modifications de préfixe en cours de conversation (comme des changements d’instructions ou d’appels d’outils), le passage à un modèle moins performant, ou un changement d’utilisateur final ou d’organisation. OpenAI recommande de conserver les préfixes des invites inchangés et d’ajouter les nouvelles instructions à la suite pour préserver le raisonnement entre les échanges et maintenir l’éligibilité des entrées précédentes à la mise en cache des invites. - 4
Étape 4 : appeler /codex/v1/responses pour les outils et les entrées multimodales
Sur Kie.ai, envoyez des requêtes à POST /codex/v1/responses avec des définitions de fonctions personnalisées ou {"type":"web_search"} (choisissez un seul type d’outil par requête). Comme GPT-6.2 Astra rédige par défaut de manière plus concise et directe, revoyez les anciens prompts système qui répètent les consignes « soyez concis ».