Automatically append previous messages to maintain multi-turn context. May increase token usage.
How can I help you today?
README
Complete guide to using deepseek-v4-1-flash
DeepSeek V4.1 Flash API pour la conversation multimodale
DeepSeek a conçu V4.1 Flash pour offrir de meilleures capacités, une inférence plus rapide et un débit plus élevé : un modèle MoE à 552 milliards de paramètres qui n'utilise que 8 milliards de paramètres actifs en entrée et 16 milliards en sortie, lit nativement les images et le texte et, selon sa fiche de modèle, prend en charge des contextes allant jusqu'à un million de jetons. La mise à jour du 17 octobre, DeepSeek V4.1 Flash 1017, conserve le même nom de modèle et le même format de requête. Sur Kie.ai, vous appelez l'API DeepSeek 4.1 Flash via le point de terminaison /openai/v1/responses compatible avec OpenAI Responses.
Paramètres de l'API DeepSeek V4.1 Flash sur Kie.ai
| Parameter | Value |
|---|---|
| Model | deepseek-v4-1-flash |
| Endpoint | POST /openai/v1/responses, compatible with the OpenAI Responses API |
| Fenêtre de contexte | Jusqu'à 1 million de jetons (fiche du modèle DeepSeek sur Hugging Face) |
| Types d'entrée | Texte et images (éléments input_text et input_image dans un même message) ; sortie textuelle |
| Thinking | Activée par défaut ; reasoning.effort accepte none, minimal, low, medium, high, xhigh et max (none désactive la réflexion) |
| Tools | Outils de type fonction uniquement ; tool_choice accepte auto (par défaut), required ou une fonction nommée |
| Sortie structurée | text.format : json_object ou json_schema |
| Streaming | stream : true ou false |
| Non pris en charge | max_output_tokens, temperature et top_p n'ont aucun effet sur ce modèle |
| Architecture | MoE à 552 milliards de paramètres, encodeur-décodeur causal, 8 milliards de paramètres actifs en entrée et 16 milliards en sortie (DeepSeek) |
Principales fonctionnalités de l'API DeepSeek V4.1 Flash
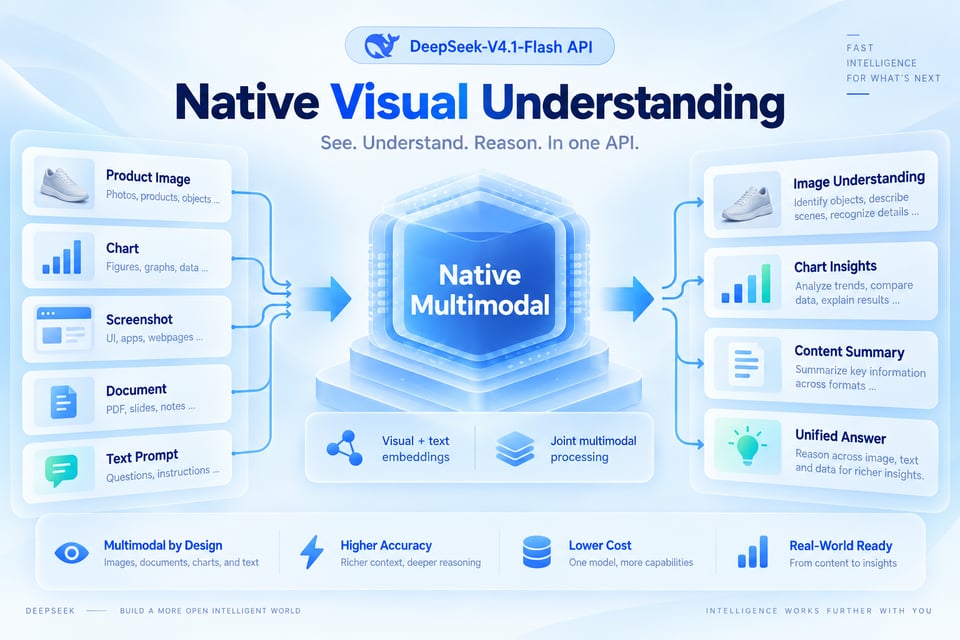
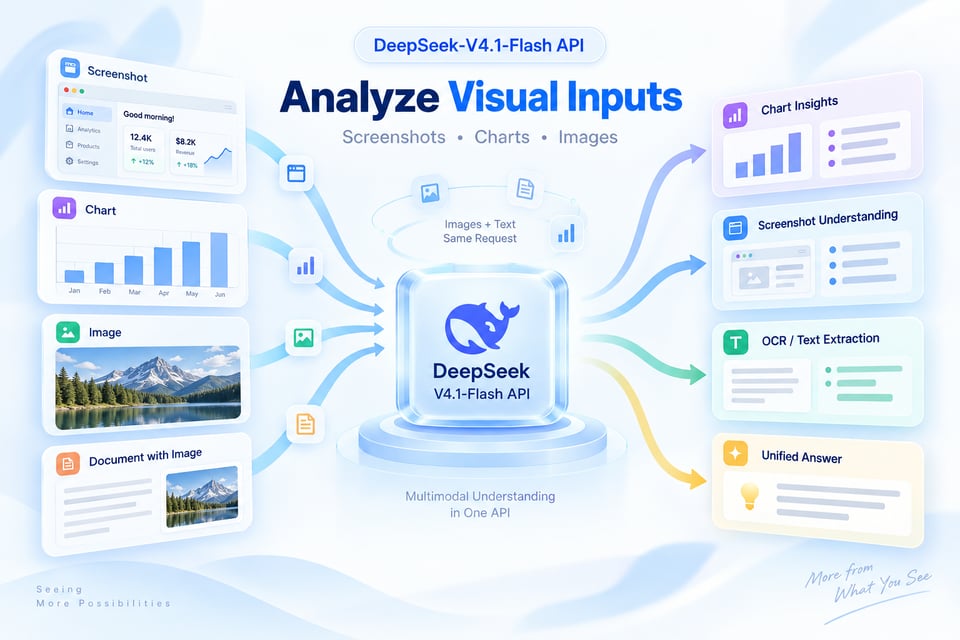
Compréhension native des images
DeepSeek V4.1 Flash traite nativement les images et le texte. Combinez des éléments input_image et input_text dans un même message ; image_url accepte une URL accessible publiquement ou une chaîne data:image en base64. Lors de notre test sur Kie.ai, le modèle a lu avec exactitude le titre d'une bannière et a identifié le soleil lumineux dans l'image.
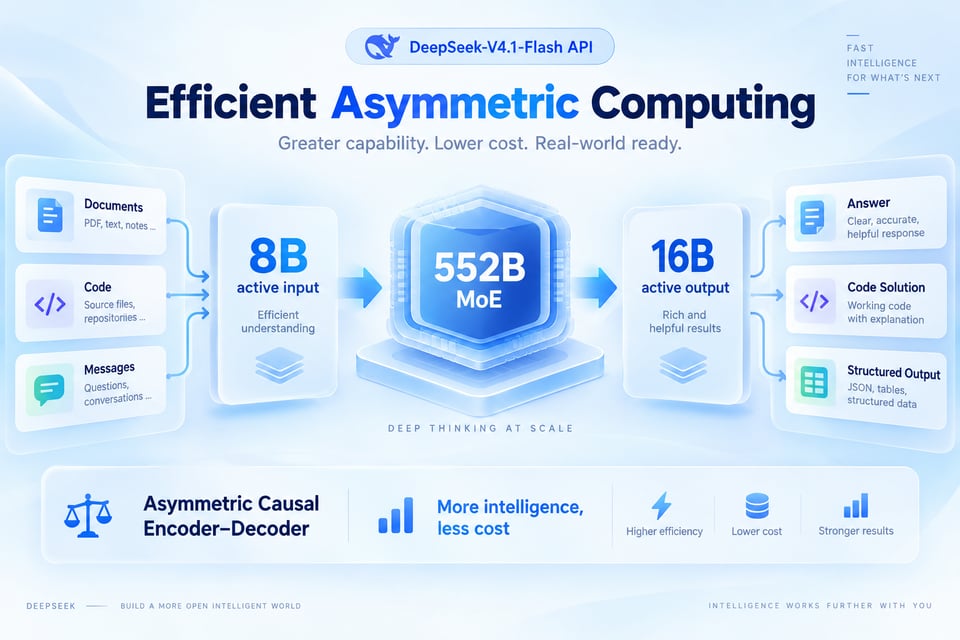
Architecture MoE Efficient 552B
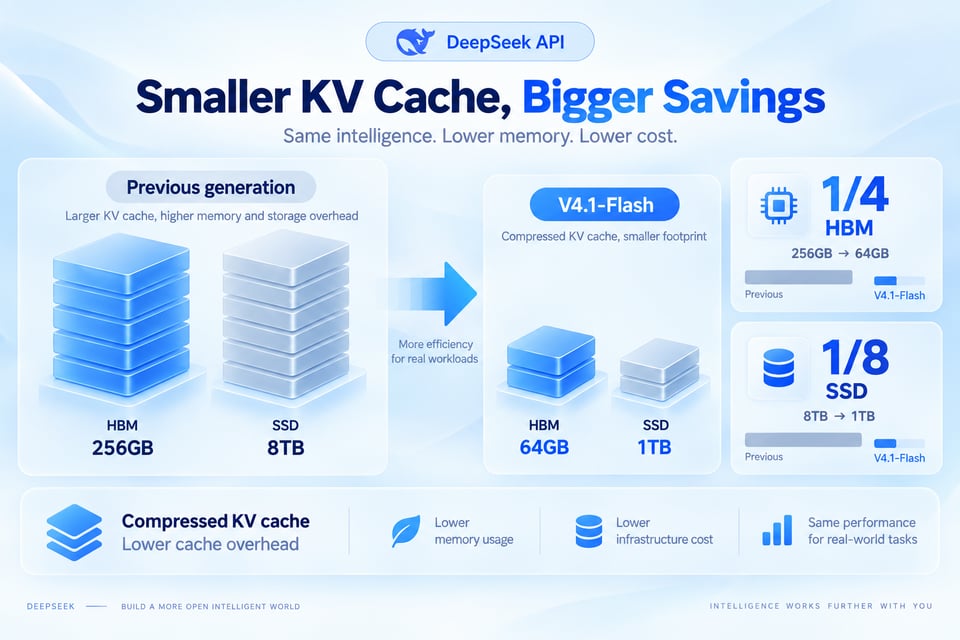
DeepSeek présente V4.1 Flash comme le plus petit modèle de sa nouvelle famille d'architectures : un modèle à mélange d'experts de 552 milliards de paramètres reposant sur une architecture encodeur-décodeur causal, qui n'utilise que 8 milliards de paramètres actifs en entrée et 16 milliards en sortie. DeepSeek indique que son cache KV ne nécessite que 1/4 de la mémoire HBM et 1/8 du stockage SSD de la génération précédente.
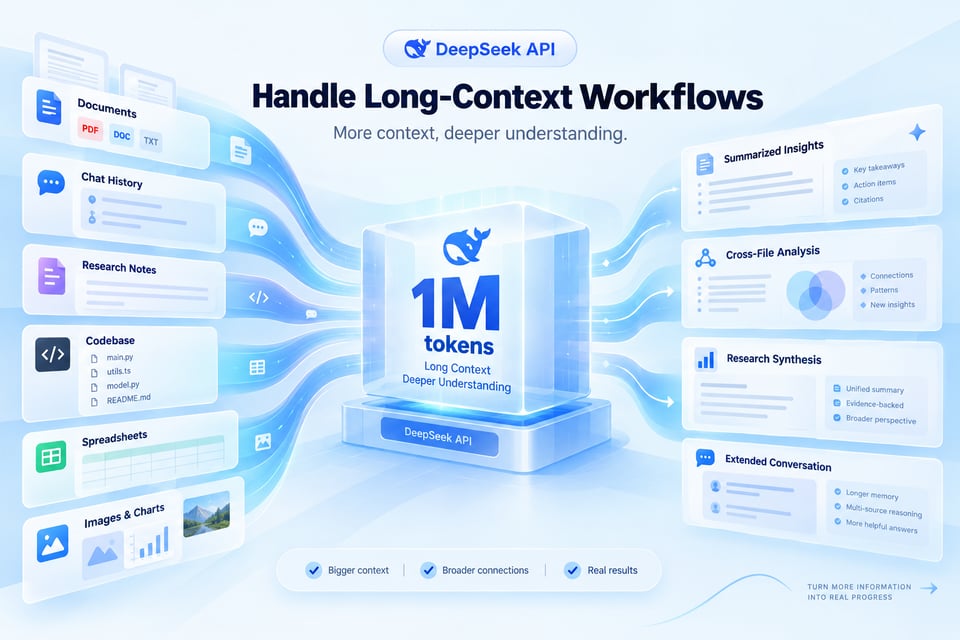
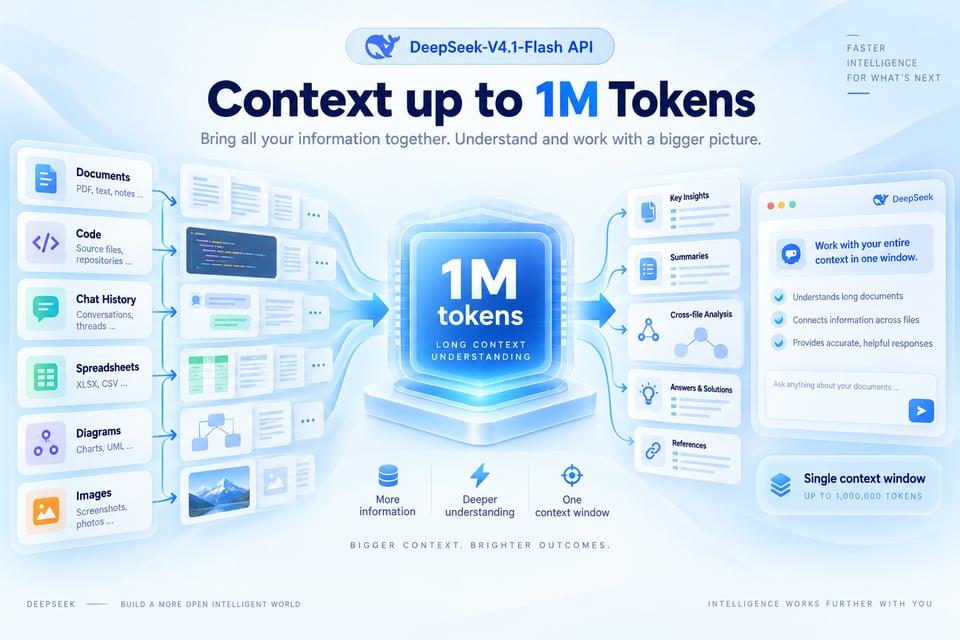
Jusqu'à 1 million de jetons de contexte
Selon la fiche du modèle DeepSeek, V4.1 Flash gère des contextes allant jusqu'à un million de jetons, ce qui laisse de la place pour de longs documents et de vastes bases de code. La documentation de Kie.ai ne mentionne aucune limite de contexte distincte pour ce modèle.
Une réflexion que vous pouvez intensifier ou désactiver
Le modèle réfléchit par défaut. Réglez reasoning.effort sur none pour désactiver la réflexion, sur minimal pour la limiter, ou sur low, medium, high, xhigh ou max pour un raisonnement plus approfondi.
Outils de type fonction et sortie JSON
Déclarez des outils de type fonction et laissez le modèle choisir avec tool_choice auto, imposez un appel ou désignez une fonction nommée ; renvoyez les résultats sous forme de function_call_output associés par call_id. Réglez text.format sur json_object ou json_schema pour obtenir une sortie que votre code peut analyser.
La mise à jour 1017, la même intégration
DeepSeek V4.1 Flash 1017, publié le 17 octobre 2026, apporte, selon DeepSeek, de meilleures performances aux tests de référence, une exécution plus rapide des tâches et des sorties plus courtes que la version précédente. Le nom du modèle, le point de terminaison et le format de requête restent inchangés, de sorte que les intégrations existantes continuent de fonctionner.
Résultats de DeepSeek V4.1 Flash 1017 aux tests de référence par rapport à la version précédente
Résultats publiés par DeepSeek dans sa fiche de modèle sur Hugging Face pour la mise à jour 1017. Terminal-Bench 4.0 a été exécuté avec l'environnement d'exécution (harness) Claude Code, et DeepSWE v1.1 avec celui de Mini-SWE-V2.
| Benchmark | V4.1 Flash 1017 | Version précédente de V4.1 Flash |
|---|---|---|
| HLE (sans outils) | 42.6 | 36.8 |
| Terminal-Bench 4.0 | 42.3 | 31.2 |
| DeepSWE v1.1 | 77.0 | 74.2 |
| ProgramBench | 29.1 | 20.3 |
| NL2Repo-Bench | 68.2 | 65.4 |
| Apex Bench v1.1 | 72.1 | 64.6 |
| Chartography (avec outils) | 83.0 | 78.9 |
| BabyVision (avec outils) | 92.5 | 89.6 |
Comment utiliser l'API DeepSeek V4.1 Flash sur Kie.ai
Étape 1. Obtenez votre API key
Étape 2. Envoyez une requête
Étape 3. Ajoutez des images, des outils et une sortie JSON
Pourquoi utiliser l'API DeepSeek V4.1 Flash sur Kie.ai
La même clé sur tout le marché Kie.ai
Tous les modèles du marché Kie.ai utilisent la même méthode d'authentification : un en-tête Authorization: Bearer YOUR_API_KEY avec la clé issue de votre page de gestion des API keys Kie.ai.
Crédits gratuits et solde unique
Les nouveaux utilisateurs de Kie.ai reçoivent 80 crédits de test gratuits. Votre compte dispose d'un solde de crédits unique sur lequel s'imputent tous les services de génération, et vous pouvez le consulter avec l'API Get Remaining Credits.
Rien à héberger ni à installer
Kie.ai fournit ce modèle sous forme d'API avec un espace de test ; il n'y a aucune application à télécharger ni à installer. Il n'y a ni GPU ni poids de modèle à gérer.
Ce que vous pouvez créer avec l'API DeepSeek V4.1 Flash
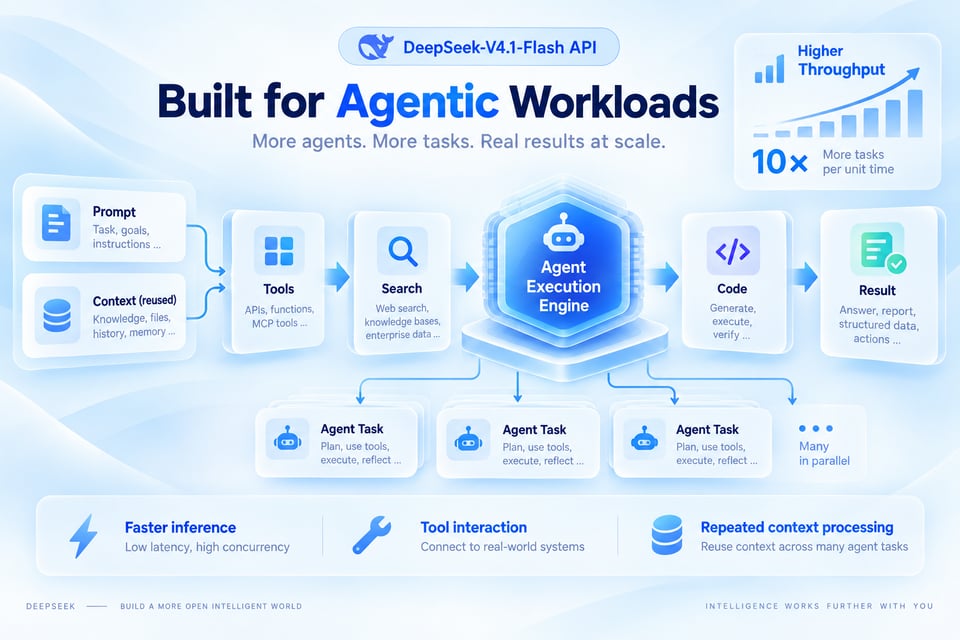
DeepSeek a conçu V4.1 Flash pour une inférence plus rapide et un débit plus élevé. Pour un modèle à poids ouverts plus grand doté d'une fenêtre de contexte de 1 million de tokens sur le même point de terminaison, consultez l'API Kimi K3.1 Pro.
Chat et questions-réponses sur les images
Répondre à des questions sur des captures d'écran, des graphiques, des bannières et des photos accompagnés de texte dans un même message.
Questions sur les longs documents et les bases de code
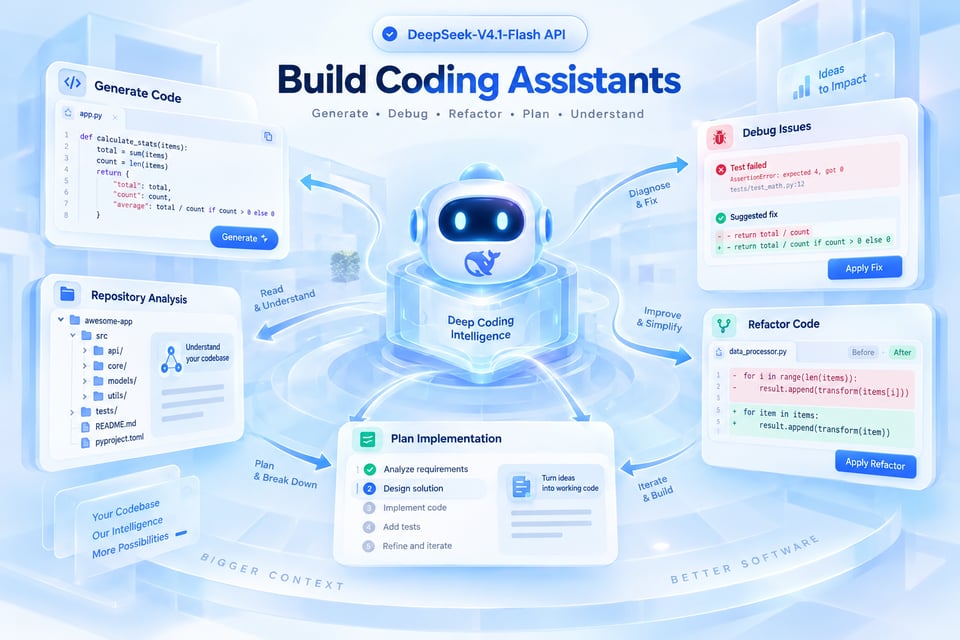
Parcourir de longs documents ou de vastes bases de code en une seule requête ; la fiche de modèle de DeepSeek indique des contextes allant jusqu'à un million de tokens.
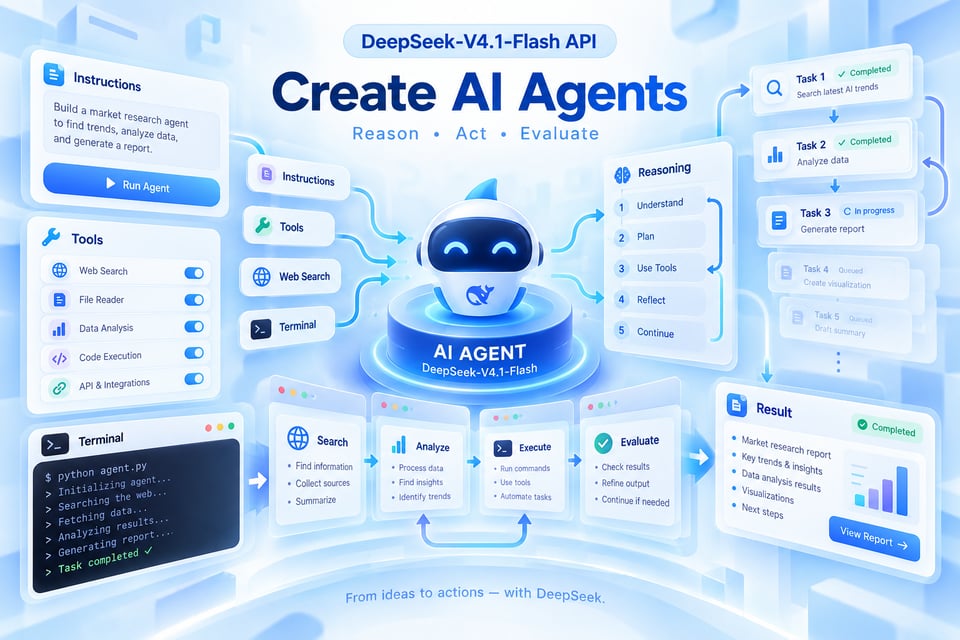
Extraction structurée
Extraire des champs à partir de texte ou d'images dans un JSON conforme à votre schéma avec text.format json_schema.
Fonctionnalités de chat à haut volume
Alimenter des fonctionnalités de chat où le débit est essentiel, avec la réflexion réduite ou désactivée pour les requêtes simples.