Click to upload or drag and drop
Supported formats: MP4, QUICKTIME, WEBM Maximum file size: 200MB; Supported formats: MPEG, WAV, X-WAV, AAC, MP4, OGG, FLAC, OPUS Maximum file size: 200MB
Audio to transcribe: a publicly downloadable URL. Common formats work (MP3, WAV, M4A/AAC, FLAC, OGG/Opus, WEBM), and so do videos with an audio track (MP4, MOV); only the sound is used. Up to 60 minutes and 200 MB per file. The language is detected automatically.
Also return word-level start and end times and speaker labels in the result file. Transcription only: not available together with target_language. The example output was produced with timestamps on and lists only the first 40 words; the API result file contains every word.
Leave empty (default) to transcribe in the spoken language. Pick a language to translate the speech into it instead. Translation is guaranteed between English and the other listed languages: non-English speech into English (en), or English speech into another language.
README
Complete guide to using nvidia/nemotron-3-5-transcribe
Nemotron 3.5 Transcribe API pour la reconnaissance vocale multilingue

Ce que l'API Nemotron 3.5 Transcribe permet de faire


Horodatage par mot et identification des locuteurs en une seule passe

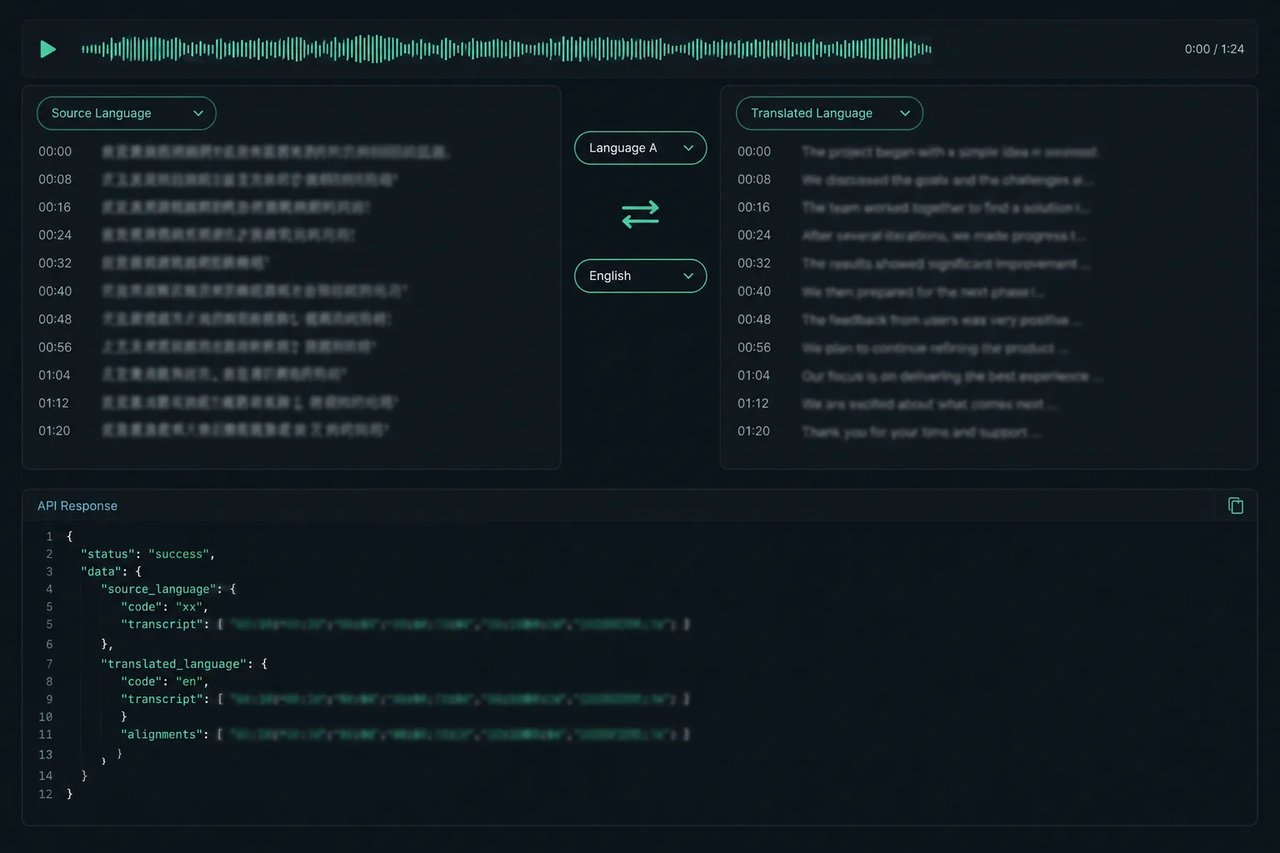
Traduction vocale vers et depuis l'anglais

Conçu pour l'audio de longue durée
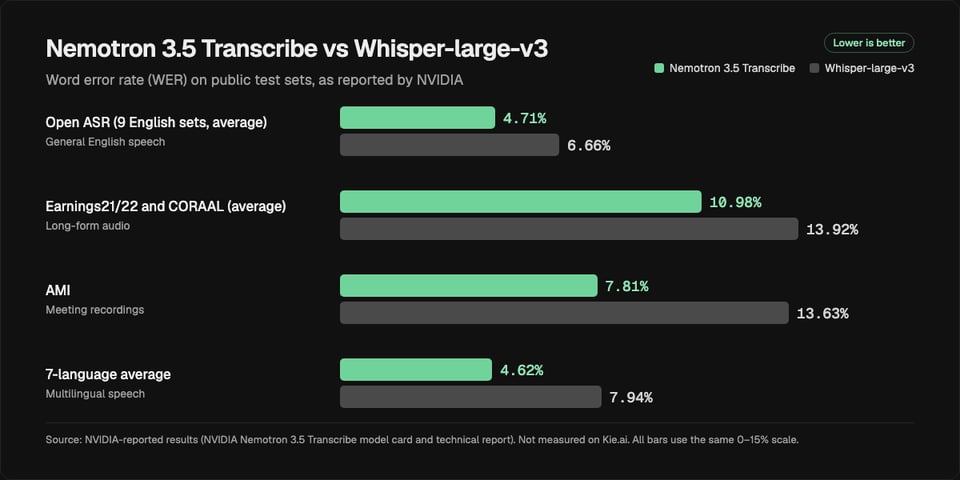
Précision de Nemotron 3.5 Transcribe (données NVIDIA)
| Jeu de test | Contenu évalué | Nemotron 3.5 Transcribe | Whisper-large-v3 |
|---|---|---|---|
| Open ASR (9 jeux en anglais, moyenne) | Parole générale en anglais | 4.71% | 6.66% |
| Earnings21/22 et CORAAL (moyenne) | Audio de longue durée | 10.98% | 13.92% |
| AMI | Enregistrements de réunions | 7.81% | 13.63% |
| Moyenne sur 7 langues | Parole multilingue | 4.62% | 7.94% |

Comment utiliser l'API Nemotron 3.5 Transcribe sur Kie.ai
- 1
Étape 1. Obtenez votre API key
Créez un compte sur Kie.ai, ouvrez la page de gestion des API keys et générez une API key. Transmettez-la à chaque requête dans l'en-tête Authorization: Bearer YOUR_API_KEY. - 2
Étape 2. Créez une tâche de transcription
Envoyez une requête POST à /api/v1/jobs/createTask avec le modèle Nemotron 3.5 Transcribe et l'URL de votre fichier audio dans audio_url. Activez timestamps pour obtenir le minutage par mot et définissez target_language lorsque vous souhaitez traduire la parole ; l'identification des locuteurs est incluse dans le résultat. - 3
Étape 3. Lisez le résultat
La transcription s'exécute comme une tâche asynchrone. Une fois la tâche terminée, lisez le résultat pour récupérer la transcription, les segments d'intervenants et, si vous les avez demandés, les timestamps par mot.
Conseils avant la mise en production
- 01
Repérez d'abord les audios silencieux
NVIDIA souligne qu'une entrée silencieuse ou sans parole peut générer du texte qui n'a jamais été prononcé. Évitez d'envoyer des enregistrements muets et coupez les longs passages de silence avant de soumettre votre audio. - 02
Connaissez les cas où le modèle est moins performant
Selon NVIDIA, les termes proches du code, l'audio en néerlandais et les discours alternant plusieurs langues, comme un mélange de chinois et d'anglais, sont transcrits avec moins de précision qu'avec Whisper-large-v3. - 03
Prévoyez le traitement de fichiers complets
Comme le modèle transcrit des fichiers complets sans diffuser en continu des résultats partiels ni renvoyer de scores de confiance, concevez votre flux de travail autour d'une transcription finale.