Google a lancé Gemini 4 Neon (gemini-4-neon) le 18 novembre 2026 pour allier une profondeur de raisonnement de pointe à une exécution efficace de bout en bout sur des flux de travail complexes en génie logiciel, raisonnement analytique, travail intellectuel et science. Adapté de Gemini 4 Carbon, il se situe entre Gemini 4 Hydrogen et Gemini 4 Carbon au sein de la famille Gemini 4 et offre une fenêtre contextuelle unifiée de 1 048 576 jetons avec quatre niveaux de réflexion, de low à xhigh. Sur Kie.ai, il prend actuellement en charge uniquement les requêtes de chat.

Model Type:
Pricing: Input 240 credits / 1M tokens (≈ $1.20), Cached Input 12 credits / 1M tokens (≈ $0.06), Output 1200 credits / 1M tokens (≈ $6.00) — all 60% below official pricing. High-tier top-ups come with bonus credits that lower the effective price by about 10%.

Automatically append previous messages to maintain multi-turn context. May increase token usage.

Function calling
Grounding with Google Search
Source:Google Search
Thinking process
Reasoning effort
Stream Response

How can I help you today?

README

Complete guide to using Gemini 4 Neon

Gemini 4 Neon API pour le codage complexe, l'analyse et les sciences

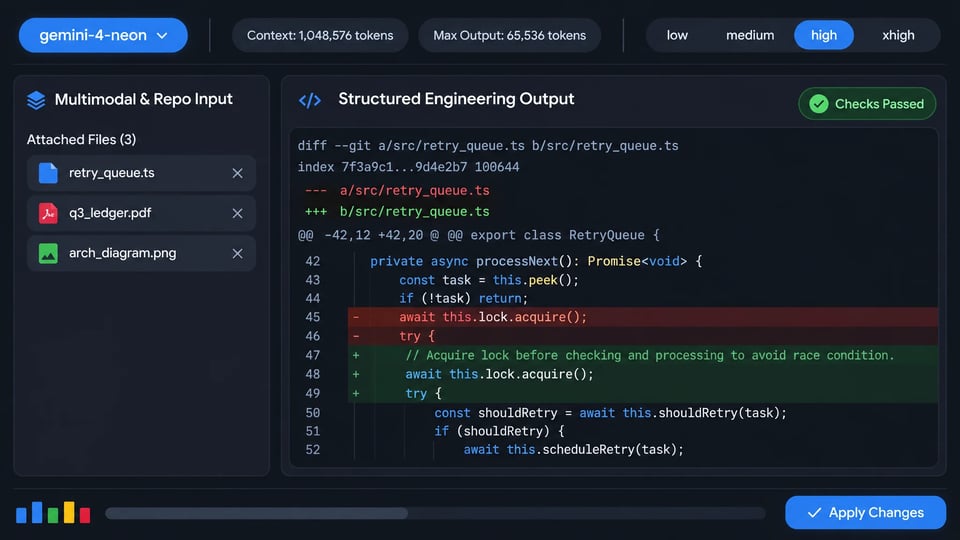
Gemini 4 Neon accepte du texte, des images, de la vidéo, de l'audio et des PDF, et génère des réponses textuelles. Les jetons d'entrée, de réflexion et de sortie partagent une fenêtre de contexte unifiée de 1 048 576 jetons, avec un maximum par défaut de 65 536 jetons de sortie par réponse synchrone. Quatre niveaux de réflexion — low, medium, high et xhigh — vous permettent d'ajuster la profondeur de raisonnement et la consommation de jetons pour chaque charge de travail.
curl https://api.kie.ai/gemini-4-neon-openai/v1/chat/completions \
-H "Authorization: Bearer $KIE_API_KEY" \
-H "Content-Type: application/json" \
-d '{
"messages": [{ "role": "user", "content": "Analyze the latency vs consistency trade-offs of multi-region consensus." }],
"reasoning_effort": "high",
"stream": false
}'
Thinking

Capacités clés de Gemini 4 Neon

Adapté de Gemini 4 Carbon, Gemini 4 Neon se situe entre Hydrogen et Carbon dans la famille Gemini 4, alliant une profondeur de raisonnement de pointe à une exécution efficace de bout en bout pour le génie logiciel complexe, le raisonnement analytique, le travail intellectuel et les flux de travail scientifiques.
Raisonnement de pointe équilibré dans la famille Gemini 4
01

Raisonnement de pointe équilibré dans la famille Gemini 4

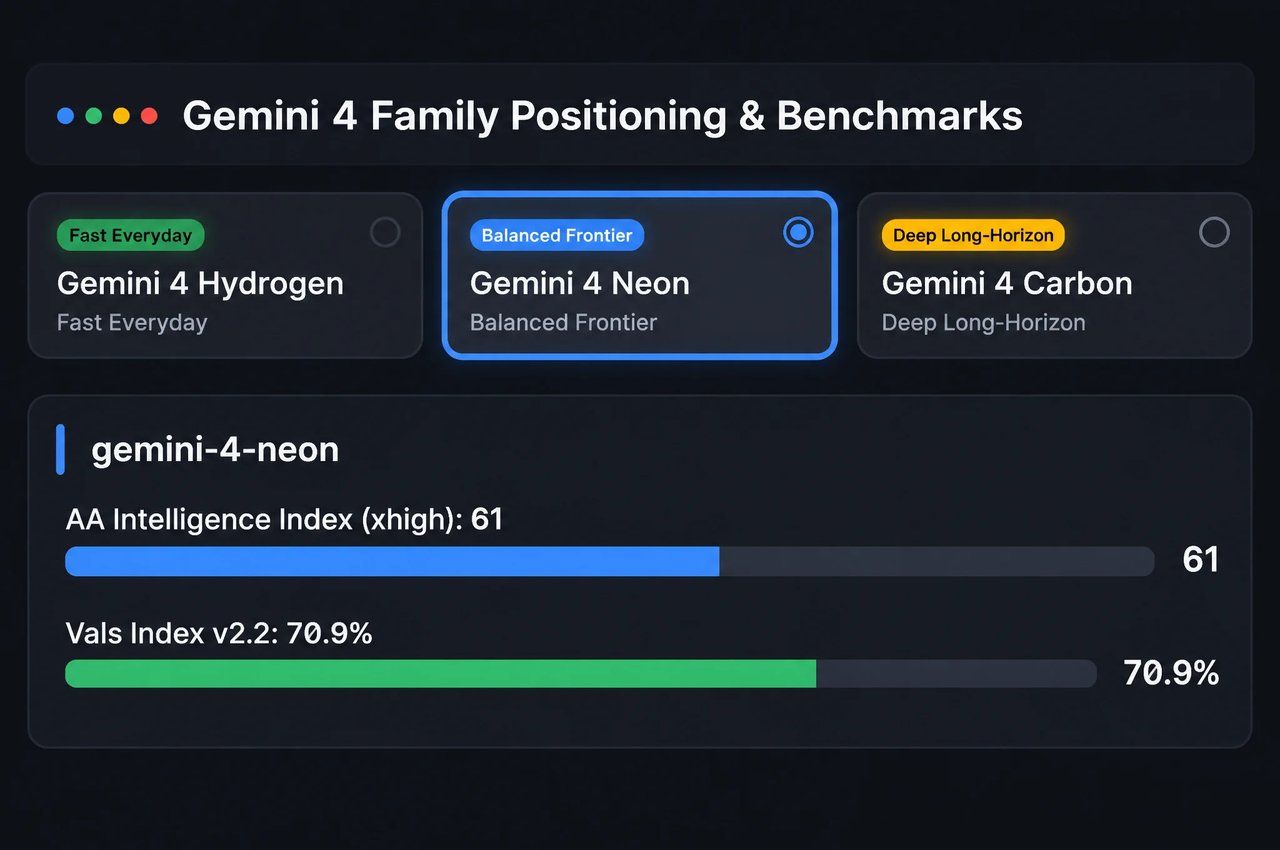
Tandis que Gemini 4 Carbon s'attaque aux projets à long terme les plus complexes et que Gemini 4 Hydrogen assure une exécution rapide au quotidien, Google a conçu Gemini 4 Neon pour équilibrer profondeur de raisonnement et efficacité. Google annonce un score de 61 (n° 3 au classement général) sur l'Artificial Analysis Intelligence Index au niveau xhigh et de 70,9 % (n° 2 au classement général) sur le Vals Index v2.2.
Codage à l'échelle du dépôt et refactorisation multifichier
02

Codage à l'échelle du dépôt et refactorisation multifichier

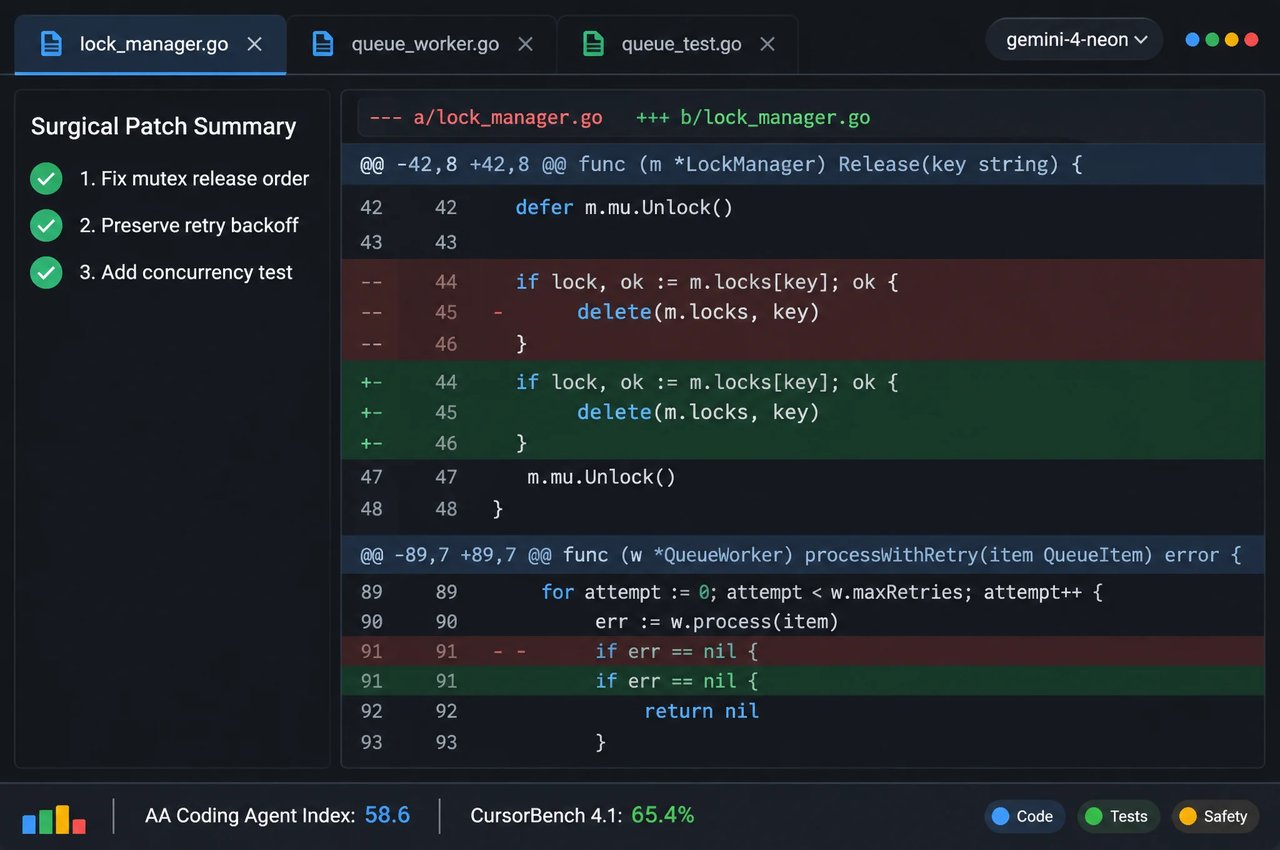
Google a conçu Gemini 4 Neon pour le débogage et la refactorisation multifichier sur l'ensemble des bases de code, avec des modifications ciblées et chirurgicales, moins de lectures redondantes de fichiers et une compaction fiable du contexte lors des longues sessions. Google annonce la 1re place sur l'Artificial Analysis Coding Agent Index (58,6), 65,4 % sur CursorBench 4.1, 65,2 % sur Terminal-Bench 4.1 et 46,2 % sur FrontierCode 2.0 avec son réglage high par défaut.
Quatre niveaux de réflexion, de low à xhigh
03

Quatre niveaux de réflexion, de low à xhigh

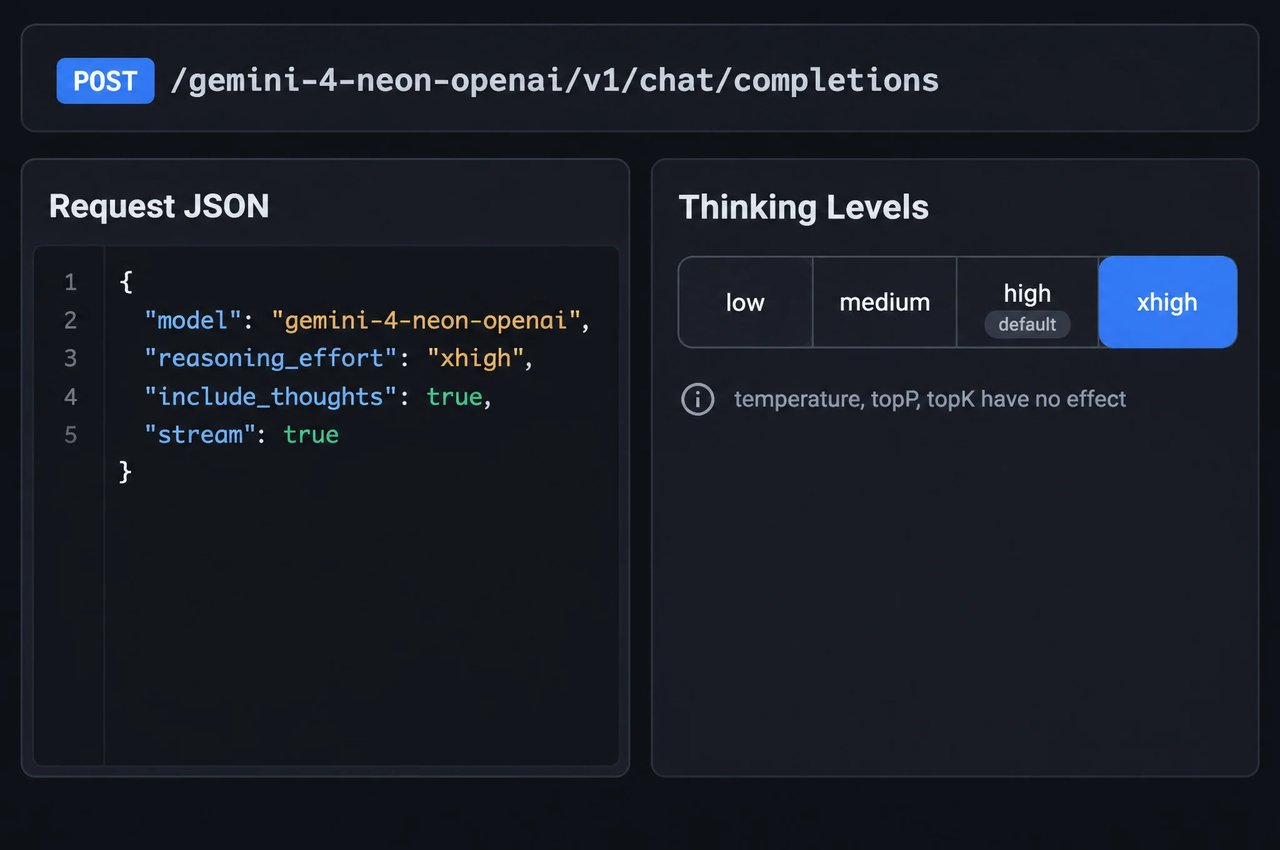
Contrôlez la profondeur de raisonnement et la consommation de jetons grâce à quatre niveaux de réflexion : low, medium, high (par défaut) et xhigh. Sur Kie.ai, définissez reasoning_effort dans l'API compatible OpenAI ou generationConfig.thinkingConfig.thinkingLevel dans la Gemini API native (minimal est ignoré, et temperature, topP et topK n'ont aucun effet). Utilisez high pour la plupart des tâches de codage complexe et d'analyse multimodale, et réservez xhigh aux problèmes d'ingénierie et scientifiques complexes en plusieurs étapes.
Fenêtre de contexte multimodale unifiée de 1 M de jetons
04

Fenêtre de contexte multimodale unifiée de 1 M de jetons

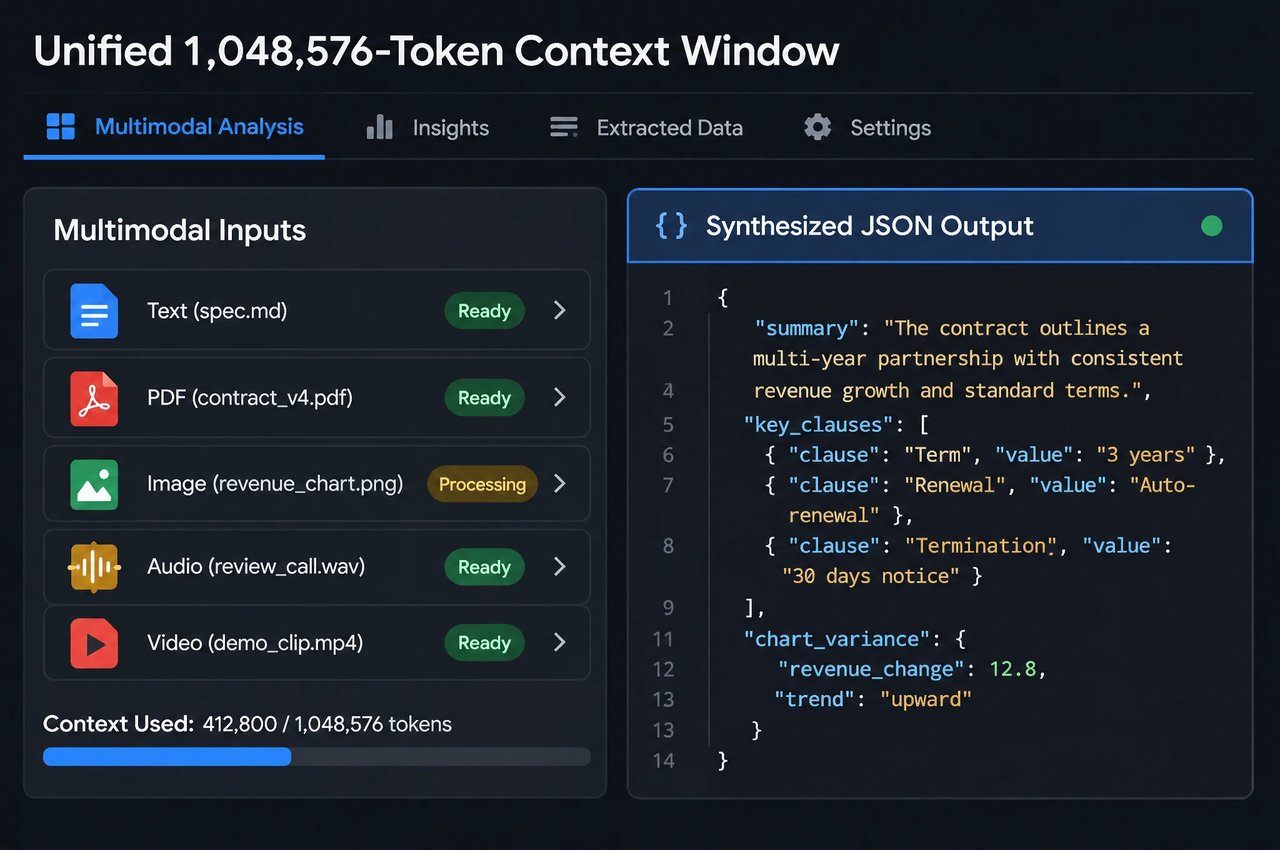
Les jetons d'entrée, de réflexion et de sortie partagent une même fenêtre de contexte de 1 048 576 jetons, avec jusqu'à 65 536 jetons de sortie par réponse synchrone par défaut, jetons de réflexion inclus. Transmettez du texte et jusqu'à 10 fichiers image, vidéo, audio ou PDF dans une seule requête pour analyser des contrats, des graphiques denses et des réunions enregistrées, et produire des sorties textuelles structurées, avec des performances en contexte long illustrées par 95,2 % sur GraphWalks (de 256K à 1M) et 89,0 % sur LVBench.
Flux de travail analytiques, juridiques et scientifiques
05

Flux de travail analytiques, juridiques et scientifiques

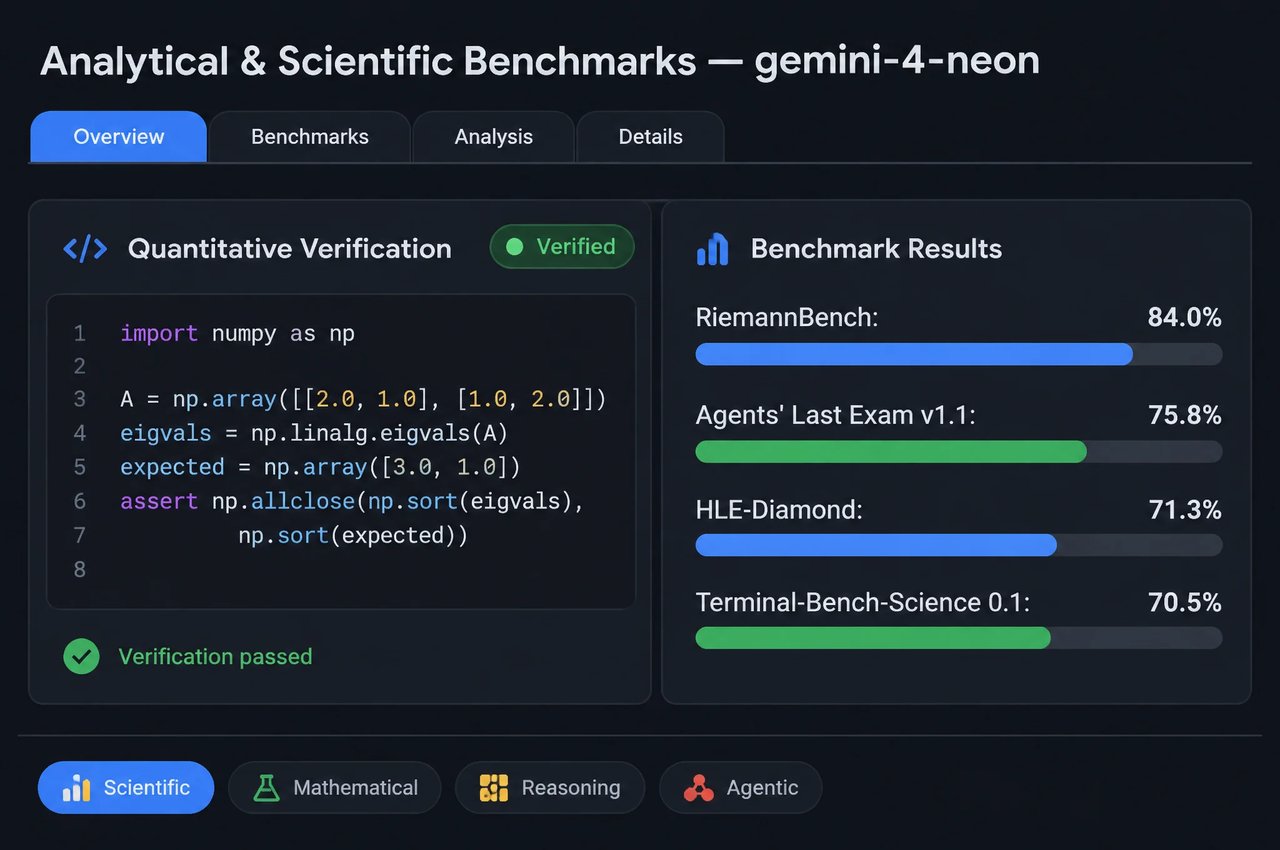
Google annonce les 1res places sur Legal Research Bench, Tax Agent Bench et AutomationBench de Zapier (56,3 %), ainsi que 75,8 % sur Agents' Last Exam v1.1 et 73,5 % sur Chartography. En mathématiques et en raisonnement scientifique, Neon atteint 84,0 % sur RiemannBench, 71,3 % sur HLE-Diamond et 70,5 % sur Terminal-Bench-Science 0.1.
Génération de code sécurisé, ancrage et outils
06

Génération de code sécurisé, ancrage et outils

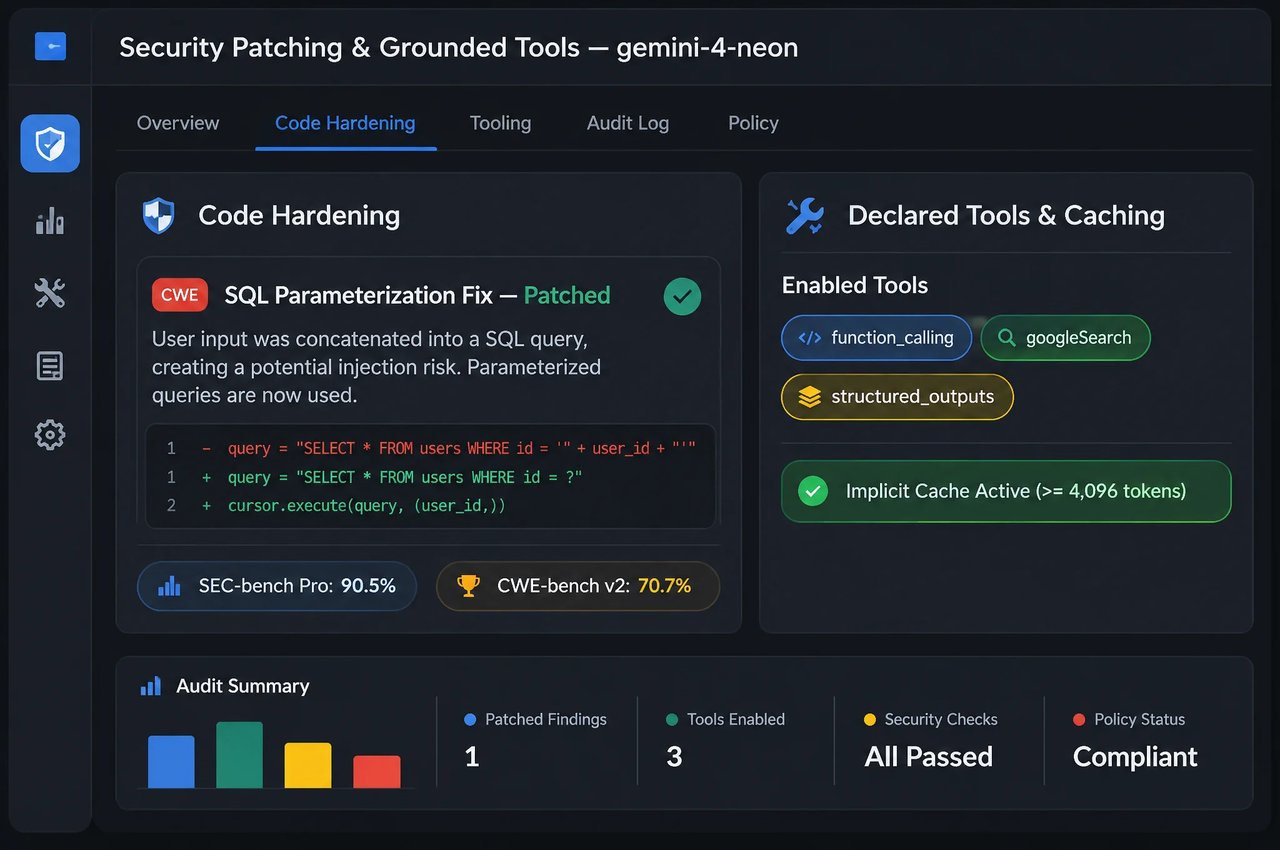
Gemini 4 Neon génère du code plus sécurisé que Gemini 4 Carbon sur les défis faciles, moyens et difficiles d'AutoBaxBench (76 % au niveau difficile), obtient 90,5 % sur SEC-bench Pro et atteint 70,7 % sur CWE-bench v2. Les deux formats d'API sur Kie.ai prennent en charge l'ancrage avec la recherche Google (googleSearch), les déclarations de fonctions personnalisées, le streaming avec credits_consumed dans le bloc final et la mise en cache implicite du contexte.
SpecificationGemini 4 Neon
DeveloperGoogle (Google DeepMind)
Identifiants de modèle sur Kie.aigemini-4-neon-openai (compatible OpenAI) ; gemini-4-neon (Gemini natif)
Date de sortie18 novembre 2026
Adapté deGemini 4 Carbon
ModalitiesEntrée texte, image, vidéo, audio et PDF (jusqu'à 10 fichiers par requête) ; sortie texte
Fenêtre de contexte1 048 576 jetons unifiés entre l'entrée, la réflexion et la sortie
Jetons de sortie max.Jusqu'à 65 536 jetons par réponse synchrone par défaut (les jetons de réflexion sont comptabilisés dans la sortie)
Niveaux de réflexionlow, medium, high (par défaut), xhigh via reasoning_effort ou thinkingLevel (minimal ignoré ; include_thoughts / includeThoughts facultatifs)
Formats d'API sur Kie.aiPOST /gemini-4-neon-openai/v1/chat/completions (stream default false); POST /gemini/v1/models/gemini-4-neon:streamGenerateContent (stream default true)
Outils et paramètres sur Kie.aiAncrage Google Search (googleSearch), outils de fonction, schéma JSON via response_format (compatible OpenAI), mise en cache implicite (temperature, topP et topK n'ont aucun effet ; requêtes de chat uniquement)
Date limite des connaissancesMars 2026
BenchmarkGemini 4 NeonCe qu'il mesure
AA Intelligence Index v5.0.161 (#3 au classement général, en xhigh)Indice de capacités générales
Vals Index v2.270,9 % (#2 au classement général ; #1 en Legal Research et Tax Agent)Évaluations en entreprise, juridiques et fiscales
AA Coding Agent Index58,6 (#1 au classement général)Évaluation des capacités en génie logiciel
CursorBench 4.1 / Terminal-Bench 4.165,4 % / 65,2 % (scores ajustés pour tenir compte de la triche)Programmation dans des dépôts de code et exécution dans le terminal
FrontierCode 2.0 / SWE-sweep46,2 % (en high) / 39,0 % (harnais Antigravity), 12,8 % (mini-SWE)Benchmarks de génie logiciel
Agents' Last Exam v1.1 / AutomationBench75,8 % / 56,3 % (#1 au classement général)Travail intellectuel en plusieurs étapes et automatisation des flux de travail
RiemannBench / HLE-Diamond / Terminal-Bench-Science 0.184.0% / 71.3% / 70.5%Raisonnement mathématique et scientifique
GraphWalks (256K à 1M, BFS F1)95.2%Recherche et raisonnement sur contexte long
LVBench / Chartography / MKA89.0% / 73.5% / 56.5%Vidéo longue, graphiques denses et raisonnement multimodal
SEC-bench Pro, CWE-bench v2 et WebExploitBench v1.290.5% / 70.7% / 51.3%Détection de vulnérabilités, correction et sécurité web

Comment travailler avec Gemini 4 Neon

Quatre bonnes pratiques pour la sélection de modèle, les budgets de réflexion, les entrées multimodales et le streaming sur Kie.ai.
  1. 1

    Étape 1 : Choisir entre Hydrogen, Neon et Carbon

    Utilisez Gemini 4 Neon pour le génie logiciel complexe, le raisonnement analytique et les flux de travail scientifiques nécessitant une profondeur de raisonnement de pointe et une exécution complète efficace. Gardez Gemini 4 Hydrogen pour le codage et l'exécution rapides au quotidien, et réservez Gemini 4 Carbon aux projets les plus complexes à long terme.
  2. 2

    Étape 2 : Commencer à High et réserver Xhigh aux problèmes difficiles

    High est le niveau de réflexion par défaut sur Kie.ai. Définissez reasoning_effort (compatible OpenAI) ou generationConfig.thinkingConfig.thinkingLevel (natif) sur medium ou low pour réduire la consommation de tokens sur les requêtes simples, ou sur xhigh pour les problèmes complexes à plusieurs étapes en ingénierie, analyse et sciences. Laissez temperature, topP et topK non définis, car ils n'ont aucun effet sur Gemini 4.
  3. 3

    Étape 3 : Prévoir de l'espace pour les tokens de réflexion et de sortie

    Les tokens d'entrée, de réflexion et de sortie partagent la fenêtre de 1 048 576 tokens, et le budget de sortie par défaut de 65 536 tokens couvre à la fois la réflexion et le texte de réponse visible. Pour les tâches xhigh complexes, gardez à l'esprit qu'une réflexion plus approfondie consomme une plus grande part de ce budget de sortie partagé, et transmettez jusqu'à 10 fichiers multimédias par requête.
  4. 4

    Étape 4 : Utiliser l'ancrage, les outils de fonction et la mise en cache des préfixes

    Activez googleSearch lorsqu'une question nécessite des faits web postérieurs à mars 2026, déclarez des outils de fonction personnalisés sur l'un ou l'autre point de terminaison, ou passez un schéma JSON response_format dans le point de terminaison compatible OpenAI. Conservez des préfixes de prompt partagés inchangés d'un tour à l'autre afin que le contexte répété puisse bénéficier de la tarification des entrées mises en cache.

Ce que vous pouvez concevoir avec Gemini 4 Neon

Google positionne Gemini 4 Neon pour le codage complexe, le raisonnement analytique et les sciences. Sur Kie.ai, le modèle ne prend actuellement en charge que les requêtes de chat ; les cas d'usage ci-dessous s'exécutent donc via le chat.

Débogage multifichier et refactorisation de base de code

Diagnostiquez des bogues intermodules, examinez des pull requests et générez des modifications ciblées sur plusieurs fichiers au sein de vastes bases de code tout en concentrant les changements sur les fichiers pertinents.

Synthèse de documents juridiques, fiscaux et financiers

Synthétisez des contrats, des déclarations réglementaires, des relevés de facturation, des graphiques et des enregistrements de réunions — fournis sous forme de texte, d'images, de vidéo, d'audio ou de PDF — dans le contexte partagé de 1 048 576 tokens pour produire des rapports structurés ou du JSON.

Analyse scientifique et quantitative

Élaborez des démonstrations mathématiques et résolvez des problèmes de modélisation quantitative, de conception expérimentale et de recherche technique grâce à un niveau de raisonnement configurable sur high ou xhigh.

Revue de code défensive et correction de vulnérabilités

Utilisez Gemini 4 Neon pour générer du code plus sûr, auditer des dépôts afin de détecter des failles de sécurité et rédiger des correctifs à la source pour les vulnérabilités CWE.

Gemini 4 Neon sur Kie.ai

01

Démarrage rapide de Gemini 4 Neon API

Essayez Gemini 4 Neon dans le playground de cette page, ou envoyez une requête POST à https://api.kie.ai/gemini-4-neon-openai/v1/chat/completions avec messages, ou à https://api.kie.ai/gemini/v1/models/gemini-4-neon:streamGenerateContent avec contents, en utilisant Authorization: Bearer YOUR_API_KEY. Définissez reasoning_effort ou thinkingLevel sur low, medium, high ou xhigh. Sur Kie.ai, ce modèle ne prend actuellement en charge que les requêtes de chat et n'a pas encore été adapté à un usage agentique ; le connecter à un agent peut entraîner des erreurs de requête ou des résultats inattendus.
03

Une seule clé pour toute la place de marché Kie.ai

Tous les modèles de la place de marché Kie.ai utilisent la même méthode d'authentification : un en-tête Authorization: Bearer YOUR_API_KEY avec la clé issue de votre page Kie.ai de gestion de votre API key.
04

Crédits à l'usage

Kie.ai fonctionne à l'usage sans palier d'abonnement : tous les modèles puisent dans un solde de crédits unique qui n'expire jamais, les requêtes en échec ne sont pas facturées et vous pouvez consulter votre solde via l'API Get Remaining Credits.

Foire aux questions

Qu'est-ce que Gemini 4 Neon ?

Gemini 4 Neon (gemini-4-neon) est le modèle Gemini 4 de Google dédié au génie logiciel complexe, au raisonnement analytique, au travail intellectuel et aux flux de travail scientifiques, publié le 18 novembre 2026 et adapté de Gemini 4 Carbon. Sur Kie.ai, il ne prend actuellement en charge que les requêtes de chat.

Comment Gemini 4 Neon se compare-t-il à Gemini 4 Hydrogen et Gemini 4 Carbon ?

Google positionne Gemini 4 Neon entre Gemini 4 Hydrogen et Gemini 4 Carbon. Hydrogen gère le codage et l'exécution rapides au quotidien, Carbon s'attaque aux projets les plus complexes à long terme, et Neon allie une profondeur de raisonnement de pointe à une exécution complète efficace.

Quelle est la taille de la fenêtre contextuelle de Gemini 4 Neon et quelle est sa limite de tokens de sortie ?

Gemini 4 Neon dispose d'une fenêtre contextuelle unifiée de 1 048 576 tokens partagée entre les tokens d'entrée, de réflexion et de sortie. La fiche modèle de Google indique jusqu'à 65 536 tokens de sortie par réponse synchrone par défaut, ainsi qu'une date limite de connaissances fixée à mars 2026.

Quelles modalités d'entrée et de sortie Gemini 4 Neon prend-il en charge ?

Il accepte du texte ainsi que jusqu'à 10 fichiers multimédias par requête — images, vidéo, audio et PDF (transmis via la structure unifiée image_url dans le point de terminaison compatible OpenAI ou via inline_data / file_data dans le point de terminaison natif) — et génère du texte. La génération d'images, la génération audio et la Live API ne sont pas prises en charge.

Quels niveaux de réflexion Gemini 4 Neon prend-il en charge ?

Gemini 4 Neon prend en charge quatre niveaux de réflexion : low, medium, high (par défaut) et xhigh. Définissez reasoning_effort dans l'API compatible OpenAI ou generationConfig.thinkingConfig.thinkingLevel dans Gemini API en mode natif, et utilisez include_thoughts ou includeThoughts lorsque vous souhaitez récupérer le flux de réflexion. Sur Kie.ai, minimal est ignoré et temperature, topP et topK n'ont aucun effet.

Comment fonctionne la mise en cache du contexte dans Gemini 4 Neon ?

La mise en cache implicite du contexte s'exécute automatiquement lorsque des requêtes répétées partagent un préfixe de prompt inchangé (Google indique un minimum de 4 096 jetons), et les jetons d'entrée mis en cache sont facturés au tarif d'entrée mise en cache de Kie.ai.

Gemini 4 Neon peut-il utiliser des outils et l'ancrage avec Google Search ?

Oui. Les deux points de terminaison sur Kie.ai prennent en charge l'ancrage avec Google Search (googleSearch) afin que les réponses puissent citer des sources web en direct, ainsi que les déclarations de fonctions personnalisées (et les schémas JSON response_format dans le point de terminaison compatible OpenAI).

Comment appeler Gemini 4 Neon API sur Kie.ai ?

Créez une API key sur la page Kie.ai de gestion de votre API key et transmettez-la dans un en-tête Authorization: Bearer YOUR_API_KEY. Envoyez une requête POST vers /gemini-4-neon-openai/v1/chat/completions pour le format compatible OpenAI ou vers /gemini/v1/models/gemini-4-neon:streamGenerateContent pour le format Gemini natif ; lors du streaming, le dernier bloc SSE inclut les métadonnées d'utilisation et credits_consumed avant data: [DONE]. Ce modèle prend actuellement en charge uniquement les requêtes de chat et n'a pas encore été adapté pour une utilisation avec des agents. Consultez la documentation de l'API compatible OpenAI et Gemini native.

Comment Gemini 4 Neon est-il facturé sur Kie.ai ?

Gemini 4 Neon est facturé par million de jetons pour les jetons d'entrée, d'entrée mise en cache et de sortie, les jetons de réflexion étant inclus dans l'utilisation des jetons de sortie, avec des tarifs identiques sur les deux points de terminaison. Les requêtes échouées ne sont pas facturées et les crédits n'expirent jamais. Les tarifs actuels par million de jetons sont affichés sur la carte tarifaire de cette page.