Legen Sie das Ausgabeformat selbst fest
Die Dokumentation verlangt, output_format explizit anzugeben. Wählen Sie daher in jeder Anfrage gezielt PNG oder JPEG, anstatt sich auf einen Standardwert zu verlassen.
Qwen Image 3.0 ist Alibabas fortschrittliches Bildgenerierungsmodell für realistische Bilder, strukturierte Layouts, reichhaltige visuelle Details und hochwertige Typografie.
Click to upload or drag and drop
Supported formats: JPEG, PNG, WEBP, BMP, GIF, TIFF Maximum file size: 10MB; Maximum files: 3
Upload an image file to use as input for the API
The positive prompt that describes the image content, style, and composition you want to generate or edit. Both Chinese and English are supported.
0/5000The output image resolution.
The output image size.
Generate image format
Whether to enable intelligent prompt rewriting. Default: true (recommended). When enabled, the model optimizes the positive prompt, which significantly improves results for simple descriptions.
The negative prompt that describes content you do not want to appear in the image.
0/5000The random seed. Value range: [0, 2147483647]. A fixed seed helps maintain relatively stable results.
A configurable parameter. Defaults to true in the Playground.
Explore different use cases and parameter configurations
The positive prompt that describes the image content, style, and composition you want to generate or edit. Both Chinese and English are supported.
0/5000The output image resolution.
The output image size
Generate image format
Whether to enable intelligent prompt rewriting. Default: true (recommended). When enabled, the model optimizes the positive prompt, which significantly improves results for simple descriptions.
The negative prompt that describes content you do not want to appear in the image.
0/5000The random seed. Value range: [0, 2147483647]. A fixed seed helps maintain relatively stable results.
A configurable parameter. Defaults to true in the Playground.
Explore different use cases and parameter configurations
The positive prompt that describes the image content, style, and composition you want to generate or edit. Both Chinese and English are supported.
0/5000The output image resolution.
The output image size
Generate image format
Whether to enable intelligent prompt rewriting. Default: true (recommended). When enabled, the model optimizes the positive prompt, which significantly improves results for simple descriptions.
The negative prompt that describes content you do not want to appear in the image.
0/5000The random seed. Value range: [0, 2147483647]. A fixed seed helps maintain relatively stable results.
A configurable parameter. Defaults to true in the Playground.
Explore different use cases and parameter configurations
Click to upload or drag and drop
Supported formats: JPEG, PNG, WEBP, BMP, GIF, TIFF Maximum file size: 10MB; Maximum files: 3
Upload an image file to use as input for the API
The positive prompt that describes the image content, style, and composition you want to generate or edit. Both Chinese and English are supported.
0/5000The output image resolution.
The output image size.
Generate image format
Whether to enable intelligent prompt rewriting. Default: true (recommended). When enabled, the model optimizes the positive prompt, which significantly improves results for simple descriptions.
The negative prompt that describes content you do not want to appear in the image.
0/5000The random seed. Value range: [0, 2147483647]. A fixed seed helps maintain relatively stable results.
A configurable parameter. Defaults to true in the Playground.
Explore different use cases and parameter configurations
Complete guide to using Qwen Image 3.0
Qwen-Image-3.0 ist das Modell der dritten Generation der Qwen-Image-Reihe und wurde für informationsdichte Bilder entwickelt: Prompts bis zu 4,5K Token, lesbarer Text bis hinunter zu 10px und natives Rendering in 12 Sprachen. Auf Kie.ai steht es in vier API-Modellen bereit: Standard und Pro, jeweils für Text-zu-Bild und Bild-zu-Bild.
Qwen Image 3 und Qwen Image 3 Pro akzeptieren auf Kie.ai dieselben Parameter; sie unterscheiden sich im Modell selbst, nicht in der Anfrage.
| Parameter | Value |
|---|---|
| Models | Standardversion: qwen3/text-to-image, qwen3/image-to-image. Pro-Version: qwen3/pro-text-to-image, qwen3/pro-image-to-image |
| Endpoint | POST /api/v1/jobs/createTask, then Get Task Details or a callBackUrl for the result |
| Prompt | Erforderlich; Chinesisch oder Englisch; bis zu 5.000 Zeichen pro Anfrage. Laut dem Qwen-Team verarbeitet das Modell lange Prompts von etwa 4,5K Token |
| Negativ-Prompt | Optional; bis zu 5.000 Zeichen |
| Eingabebilder (Bild-zu-Bild) | 1 bis 3 Bild-URLs; JPEG, PNG, WebP, BMP, GIF oder TIFF; je bis zu 10 MB |
| Resolution | 1K oder 2K (Standardwert bei Bild-zu-Bild ist 1K) |
| Seitenverhältnis | 1:1, 3:2, 2:3, 4:3, 3:4, 16:9, 9:16, 21:9 (Standard: 16:9) |
| Ausgabeformat | PNG oder JPEG |
| Prompt-Umformulierung | prompt_extend, standardmäßig aktiviert |
| Seed | Optional, 0 bis 2.147.483.647; zufällig, falls nicht angegeben |
| Pricing | Je nach Modell und Auflösung, siehe Preiskarte oben |
Jedes der folgenden Beispiele wurde im Oktober 2026 mit Qwen Image 3 Pro auf Kie.ai anhand des in der Bildunterschrift beschriebenen Prompts generiert; die Bilder werden wie generiert gezeigt, lediglich für das Web skaliert.
Qwen-Image-3.0 ist darauf ausgelegt, langen Prompts von rund 4,5K Token zu folgen, sodass eine einzige Anfrage ein komplettes Layout beschreiben kann. Diese Infografik entstand aus einem einzelnen Prompt mit etwa 110 Wörtern, der vier Panels, deren Beschriftungen, ein Balkendiagramm mit vier Werten und eine Fußzeile vorgab; alle Elemente sind im Bild enthalten.

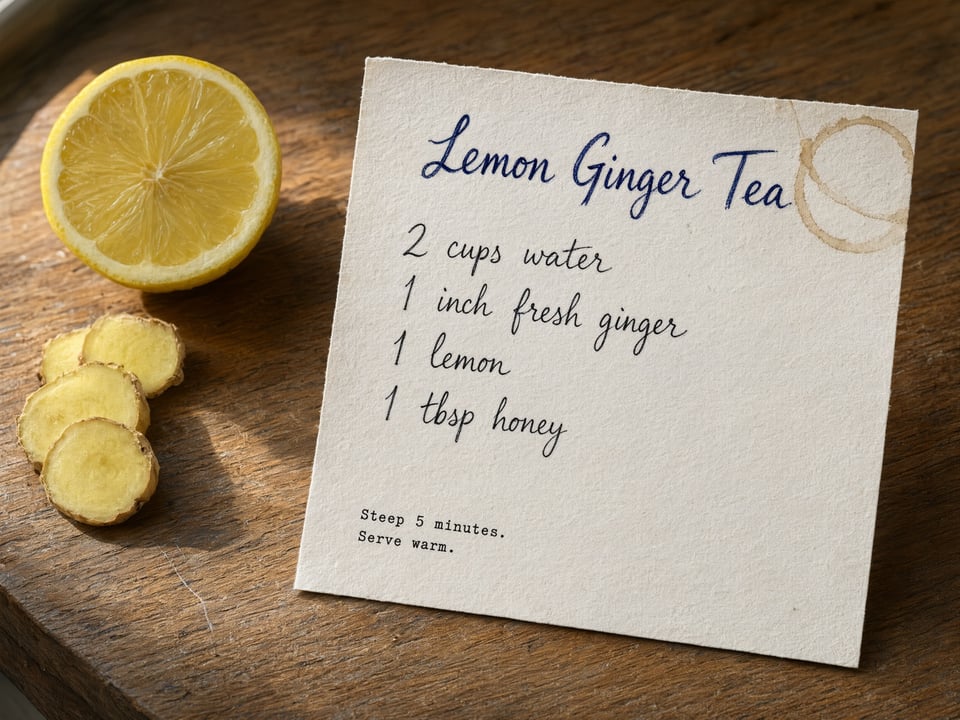
Laut dem Qwen-Team rendert das Modell Text bis hinunter zu 10px sowie feine Oberflächendetails. Hier bleiben die handgeschriebene Zutatenliste und die kleine getippte Notiz gut lesbar – neben Papierfasern, einem schwachen Kaffeerand und der Holzmaserung.
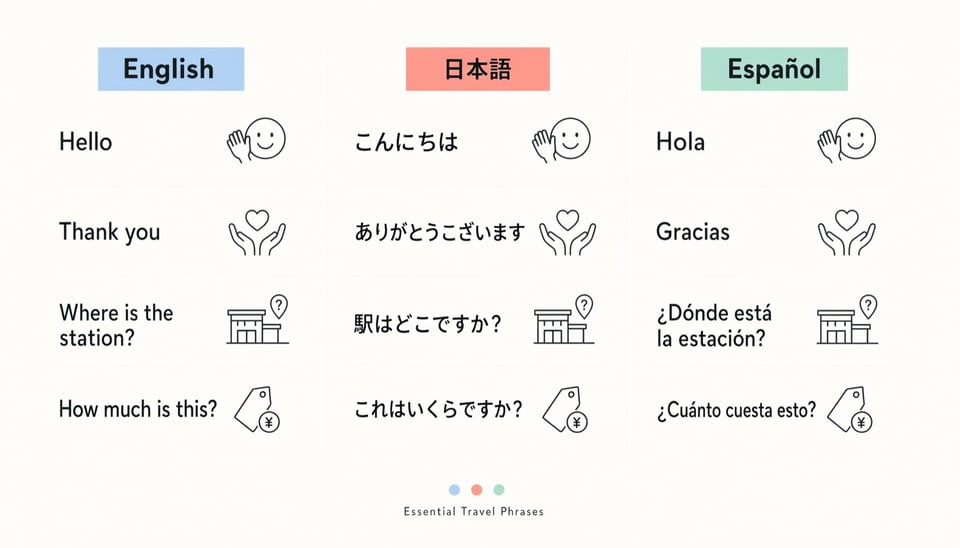
Qwen-Image-3.0 rendert Text nativ in 12 Sprachen. Dieses Phrasen-Poster stellt dieselben vier Ausdrücke auf Englisch, Japanisch und Spanisch dar – einschließlich japanischer Kana und Kanji sowie spanischer Akzente und umgekehrter Fragezeichen.
Ausgehend von der Rezeptkarte oben wurden mit einer einzigen Anweisung drei handgeschriebene Notizen hinzugefügt, zwei davon mit Pfeilen. Bei dieser Bearbeitung blieben Karte, Tisch und Beleuchtung unverändert, während die Notizen ergänzt wurden.

Auf Kie.ai verwenden beide Versionen exakt dieselbe Anfrage, sodass für den Wechsel nur ein Wort im Modellnamen geändert werden muss. In der Text-zu-Bild-Arena von Artificial Analysis erreicht Qwen-Image-3.0-Pro 1.087 Punkte und Qwen-Image-3.0 1.075 Punkte, wobei sich die Wertebereiche überschneiden. Da der gemessene Unterschied gering ist, empfiehlt sich im Alltag das Standardmodell; nutzen Sie Pro für textlastige finale Assets nur dann, wenn ein direkter Vergleich mit Ihren eigenen Prompts einen Unterschied zeigt. Die Preise für jedes Modell finden Sie in der Preiskarte oben.Das Qwen-Team positioniert Qwen-Image-3.0 für informationsdichte Bilder wie Zeitungen, Storyboards, Prüfungsbögen und Interface-Mockups. Speziell für Text führt das Text-Rendering-Leaderboard von LMArena Qwen-Image-3.0-Pro mit 1.283 Punkten, GPT Image 2 (medium) mit 1.425 Punkten und Seedream 5.0 Pro mit 1.255 Punkten (Stand: 7. Oktober 2026).
| Qwen Image 3 | Qwen Image 3 Pro | |
|---|---|---|
| Modelle auf Kie.ai | qwen3/text-to-image, qwen3/image-to-image | qwen3/pro-text-to-image, qwen3/pro-image-to-image |
| Anfrageparameter | Wie bei Pro | Wie bei Standard |
| Artificial-Analysis-Text-zu-Bild-Score (Okt. 2026) | 1075 | 1087 |
| LMArena-Text-zu-Bild-Score (7. Okt. 2026) | Nicht gelistet | 1255 |
| LMArena-Text-Rendering-Score (7. Okt. 2026) | Nicht gelistet | 1283 |
| Pricing | In der Preiskarte oben angegeben | In der Preiskarte oben angegeben |
Das Qwen-Team hat Qwen-Image-3.0 für Bilder entwickelt, bei denen nicht nur die Optik, sondern auch Text und Layout exakt stimmen müssen. Für diese Aufgaben eignet es sich.
Unterrichtsfolien, Prüfungsbögen, formellastige Seiten und Layouts im Zeitungsstil, bei denen jede Überschrift, jede Beschriftung und jede Gleichung in einem einzigen Bild lesbar sein muss.
Realistische Ansichten für Webseiten, Mobile-Apps, Spiele und Livestreams, die Sie in Pitch-Decks, Design-Reviews oder frühe Nutzertests einfügen können, noch bevor etwas umgesetzt wird.
Poster, Speisekarten, Beschilderungen und Social-Media-Grafiken, die dasselbe Design in mehreren Sprachen benötigen und direkt mit dem fertigen Text generiert werden, statt dass dieser nachträglich eingefügt wird.
Verwandeln Sie ein vorhandenes Foto per Bild-zu-Bild in eine beschriftete Abbildung für Berichte, Forschungsnotizen oder Produktdokumentationen – das ursprüngliche Motiv bleibt erhalten und die Anmerkungen werden ergänzt.
Die Dokumentation verlangt, output_format explizit anzugeben. Wählen Sie daher in jeder Anfrage gezielt PNG oder JPEG, anstatt sich auf einen Standardwert zu verlassen.
Bild-zu-Bild erwartet gehostete Bild-URLs. Dateien, die noch nicht gehostet sind, können vorab über die Datei-Upload-API von Kie.ai (Base64, Datei-Stream oder Remote-URL) hochgeladen werden.
In einem unserer vier Testbilder hat das Modell Beschriftungen hinzugefügt, die wir nicht angefordert hatten (siehe Infografik oben). Überprüfen Sie generierten Text daher vor der Veröffentlichung – insbesondere Zahlen und Namen. Die Prompt-Umformulierung (prompt_extend) ist standardmäßig aktiviert; wenn Sie Ihren genauen Wortlaut benötigen, vergleichen Sie die Ergebnisse mit aktivierter und deaktivierter Option.
Alle Modelle auf dem Kie.ai-Marktplatz nutzen dieselbe Authentifizierungsmethode: den Header Authorization: Bearer YOUR_API_KEY mit dem Schlüssel aus Ihrer API-Key-Verwaltung auf Kie.ai.
Neue Kie.ai-Nutzer erhalten 80 kostenlose Credits zum Testen. Ihr Konto verfügt über ein gemeinsames Credits-Guthaben, auf das alle Generierungsdienste zugreifen; prüfen Sie es über die API „Get Remaining Credits“.
Kie.ai stellt dieses Modell als API mit einem Playground bereit; es muss keine App heruntergeladen oder installiert werden. Sie müssen weder GPUs noch Modellgewichte verwalten.