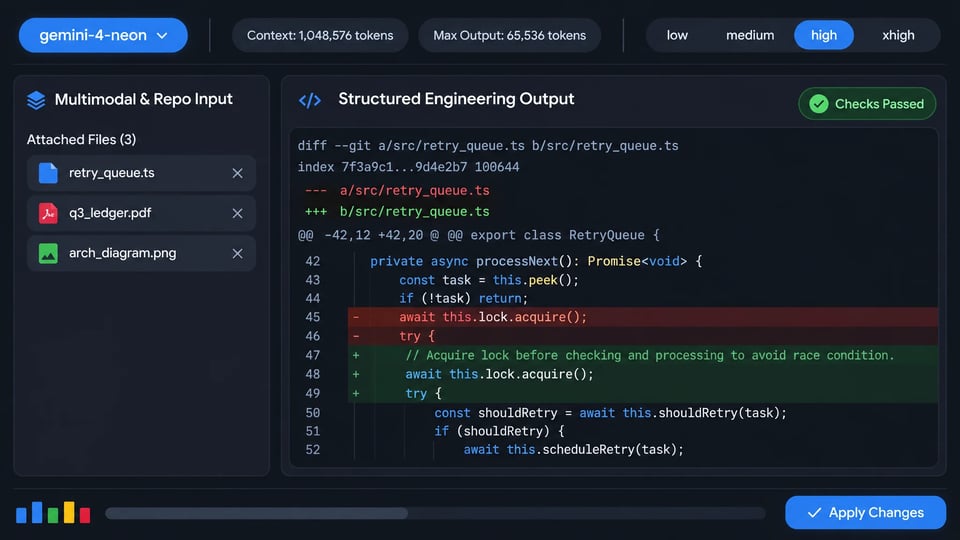
Google hat Gemini 4 Neon (gemini-4-neon) am 18. November 2026 eingeführt, um Reasoning-Tiefe auf Spitzenmodell-Niveau mit effizienter End-to-End-Aufgabenerledigung über komplexe Softwareentwicklung, analytisches Reasoning, Wissensarbeit und Wissenschafts-Workflows hinweg in Einklang zu bringen. Abgeleitet von Gemini 4 Carbon, ordnet es sich zwischen Gemini 4 Hydrogen und Gemini 4 Carbon innerhalb der Modellfamilie Gemini 4 ein und bietet ein einheitliches Kontextfenster von 1.048.576 Tokens mit vier Denkstufen von low bis xhigh. Auf Kie.ai unterstützt es derzeit nur Chat-Anfragen.

Model Type:
Pricing: Input 240 credits / 1M tokens (≈ $1.20), Cached Input 12 credits / 1M tokens (≈ $0.06), Output 1200 credits / 1M tokens (≈ $6.00) — all 60% below official pricing. High-tier top-ups come with bonus credits that lower the effective price by about 10%.

Automatically append previous messages to maintain multi-turn context. May increase token usage.

Function calling
Grounding with Google Search
Source:Google Search
Thinking process
Reasoning effort
Stream Response

How can I help you today?

README

Complete guide to using Gemini 4 Neon

Gemini 4 Neon API für komplexes Coding, Analyse und Wissenschaft

Gemini 4 Neon verarbeitet Text, Bilder, Video, Audio und PDFs und erzeugt Textantworten. Input-, Thinking- und Output-Tokens teilen sich ein einheitliches Kontextfenster mit 1.048.576 Tokens. Standardmäßig sind maximal 65.536 Output-Tokens pro synchrone Antwort möglich. Vier Thinking-Stufen – low, medium, high und xhigh – lassen Sie Reasoning-Tiefe und Token-Nutzung für jeden Workload abstimmen.
curl https://api.kie.ai/gemini-4-neon-openai/v1/chat/completions \
-H "Authorization: Bearer $KIE_API_KEY" \
-H "Content-Type: application/json" \
-d '{
"messages": [{ "role": "user", "content": "Analyze the latency vs consistency trade-offs of multi-region consensus." }],
"reasoning_effort": "high",
"stream": false
}'
Thinking

Wichtige Funktionen von Gemini 4 Neon

Adaptiert von Gemini 4 Carbon liegt Gemini 4 Neon in der Familie Gemini 4 zwischen Hydrogen und Carbon und verbindet Reasoning-Tiefe auf Frontier-Niveau mit effizienter End-to-End-Aufgabenerledigung über komplexes Software-Engineering, analytisches Reasoning, Wissensarbeit und wissenschaftliche Workflows hinweg.
Ausgewogenes Frontier-Reasoning in der Familie Gemini 4
01

Ausgewogenes Frontier-Reasoning in der Familie Gemini 4

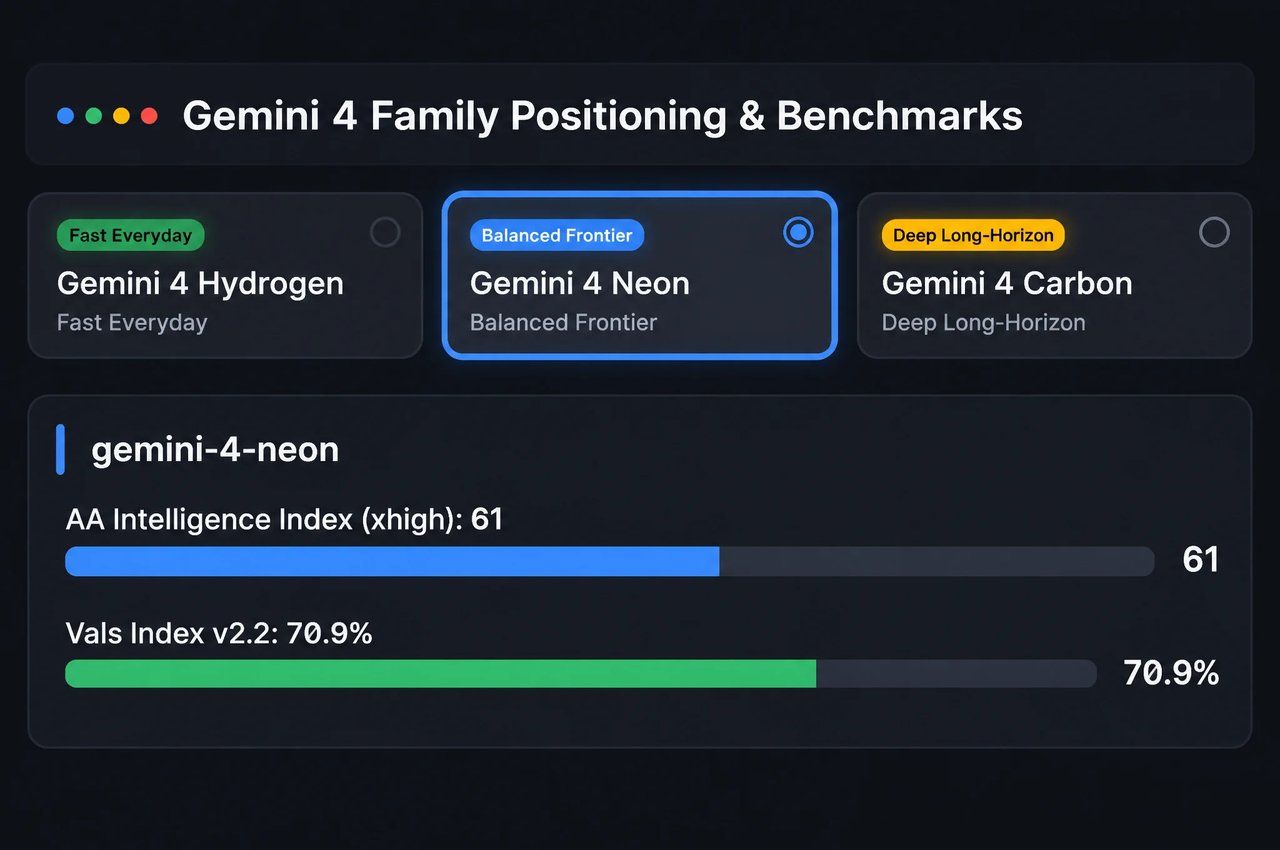
Während Gemini 4 Carbon die anspruchsvollsten Langzeitprojekte meistert und Gemini 4 Hydrogen die schnelle tägliche Ausführung übernimmt, hat Google Gemini 4 Neon entwickelt, um Reasoning-Tiefe und Effizienz auszubalancieren. Google meldet bei xhigh einen Wert von 61 (#3 insgesamt) im Artificial Analysis Intelligence Index und 70,9 % (#2 insgesamt) im Vals Index v2.2.
Coding auf Repository-Ebene und Multi-File-Refactoring
02

Coding auf Repository-Ebene und Multi-File-Refactoring

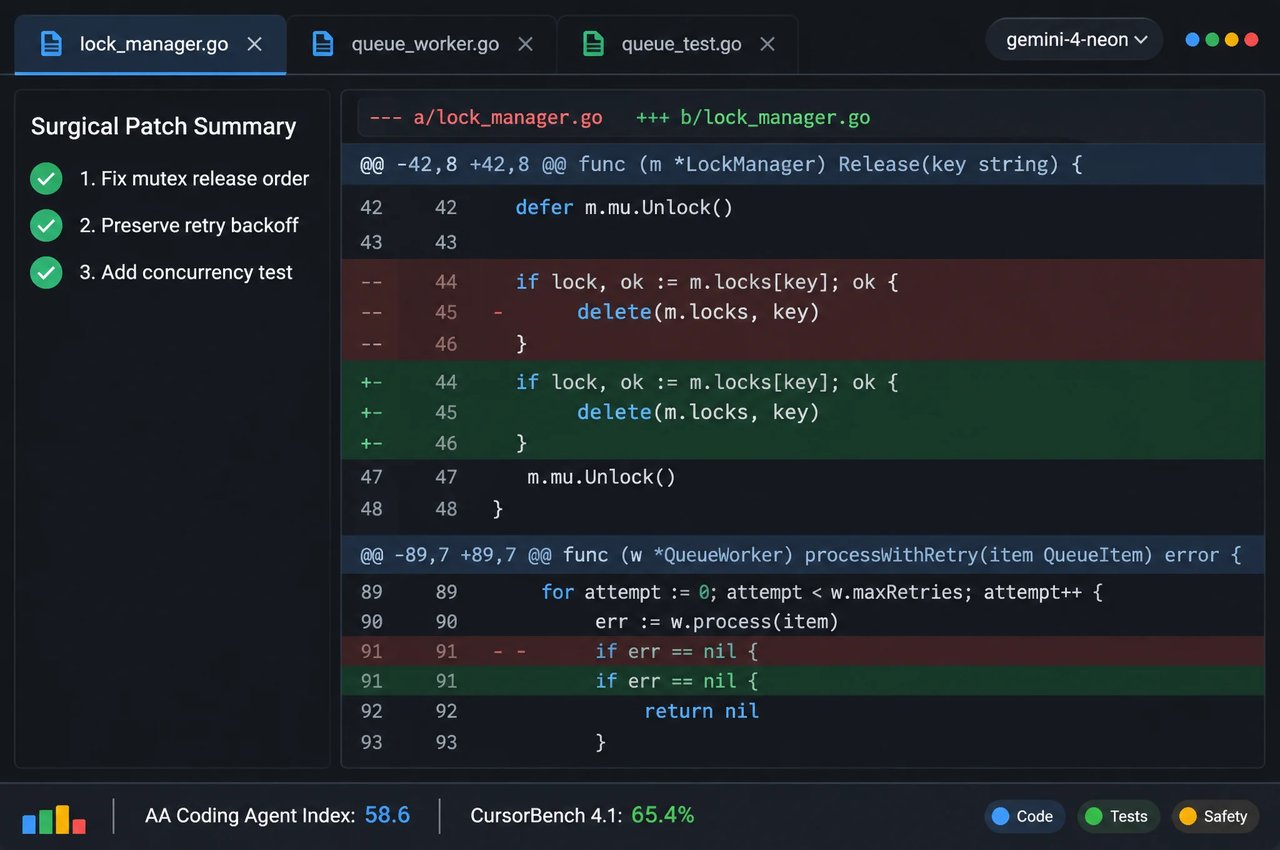
Google hat Gemini 4 Neon für dateiübergreifendes Debugging und Refactoring über Codebasen hinweg mit gezielten, präzisen Änderungen, weniger redundanten Dateilesevorgängen und zuverlässiger Kontextkomprimierung über lange Sessions entwickelt. Google meldet #1 im Artificial Analysis Coding Agent Index (58,6), 65,4 % auf CursorBench 4.1, 65,2 % auf Terminal-Bench 4.1 und 46,2 % auf FrontierCode 2.0 bei der Standardeinstellung high.
Vier Thinking-Stufen von Low bis Xhigh
03

Vier Thinking-Stufen von Low bis Xhigh

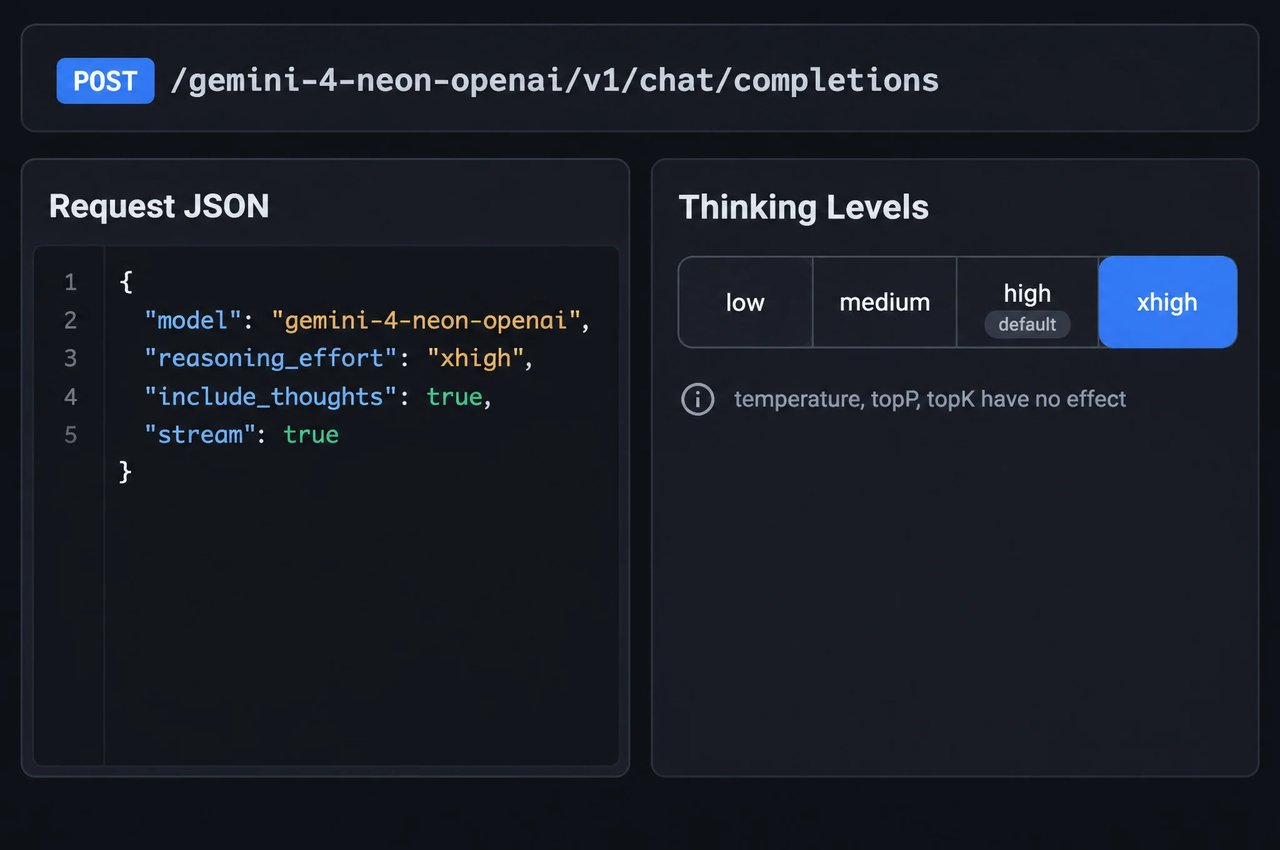
Steuern Sie Reasoning-Tiefe und Token-Nutzung über vier Thinking-Stufen: low, medium, high (Standard) und xhigh. Setzen Sie auf Kie.ai reasoning_effort in der OpenAI-kompatiblen API oder generationConfig.thinkingConfig.thinkingLevel in der nativen Gemini API (minimal wird ignoriert, und temperature, topP sowie topK haben keine Wirkung). Nutzen Sie high für die meisten komplexen Coding- und multimodalen Analyseaufgaben und reservieren Sie xhigh für schwierige mehrstufige Engineering- und wissenschaftliche Probleme.
Einheitliches multimodales Kontextfenster mit 1 Mio. Tokens
04

Einheitliches multimodales Kontextfenster mit 1 Mio. Tokens

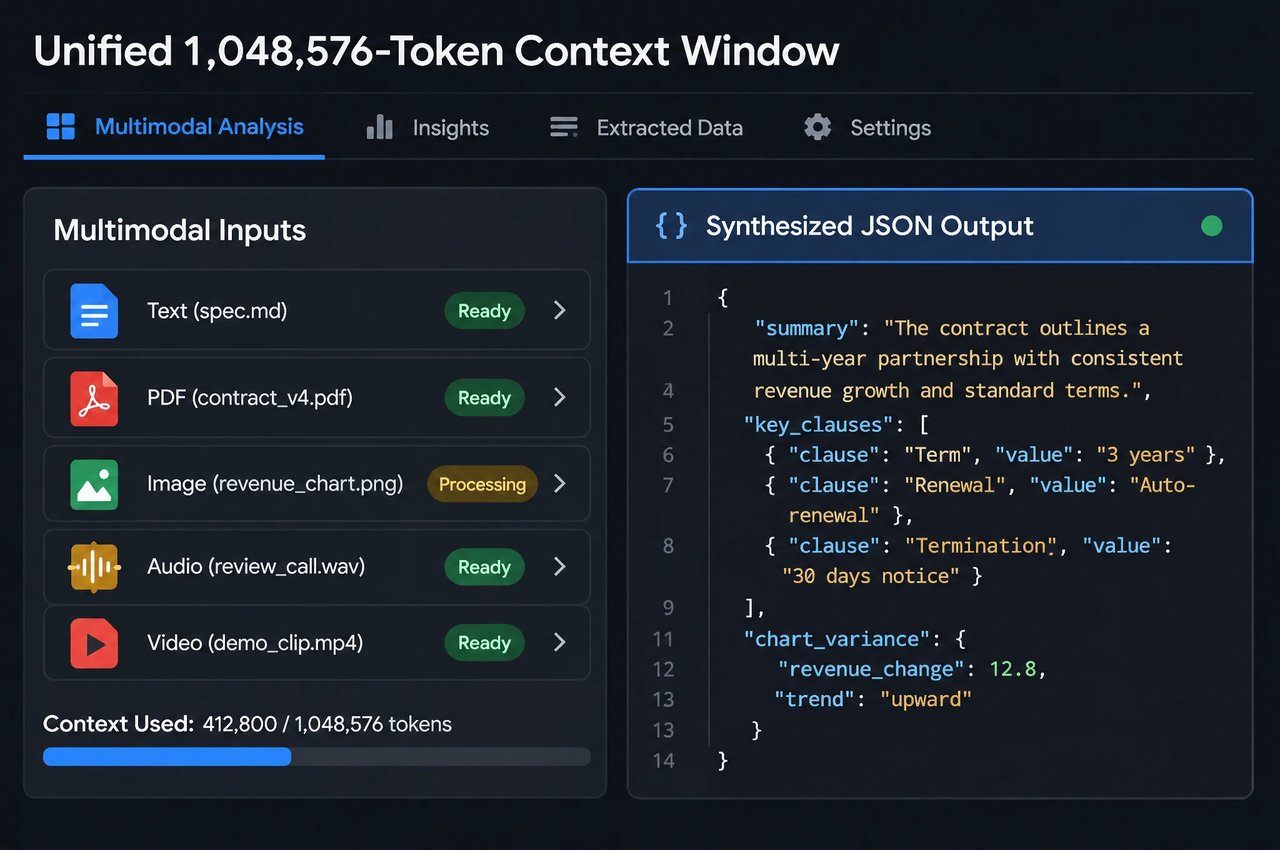
Input-, Thinking- und Output-Tokens teilen sich ein Kontextfenster mit 1.048.576 Tokens. Pro synchroner Antwort sind standardmäßig bis zu 65.536 Output-Tokens möglich; Thinking-Tokens werden dabei mitgezählt. Übergeben Sie Text und bis zu 10 Bild-, Video-, Audio- oder PDF-Dateien in einem einzigen Request, um Verträge, dichte Diagramme und aufgezeichnete Meetings zu analysieren und strukturierte Textausgaben zu erzeugen, wobei die Leistung bei langen Kontexten durch 95,2 % auf GraphWalks (256K bis 1M) und 89,0 % auf LVBench belegt wird.
Analytische, juristische und wissenschaftliche Workflows
05

Analytische, juristische und wissenschaftliche Workflows

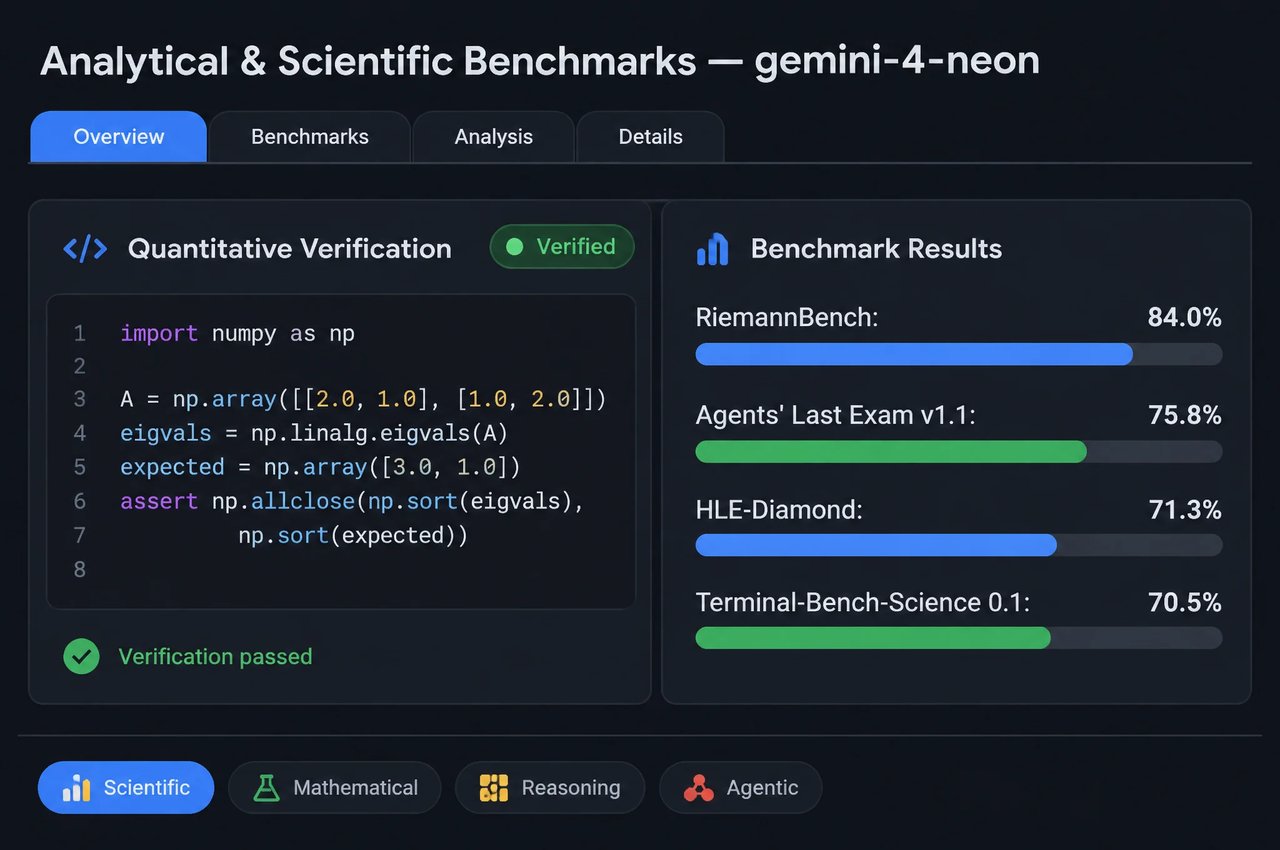
Google meldet #1-Platzierungen auf Legal Research Bench, Tax Agent Bench und Zapiers AutomationBench (56,3 %) sowie 75,8 % auf Agents' Last Exam v1.1 und 73,5 % auf Chartography. Bei Mathematik und wissenschaftlichem Reasoning erreicht Neon 84,0 % auf RiemannBench, 71,3 % auf HLE-Diamond und 70,5 % auf Terminal-Bench-Science 0.1.
Sichere Codegenerierung, Grounding und Tools
06

Sichere Codegenerierung, Grounding und Tools

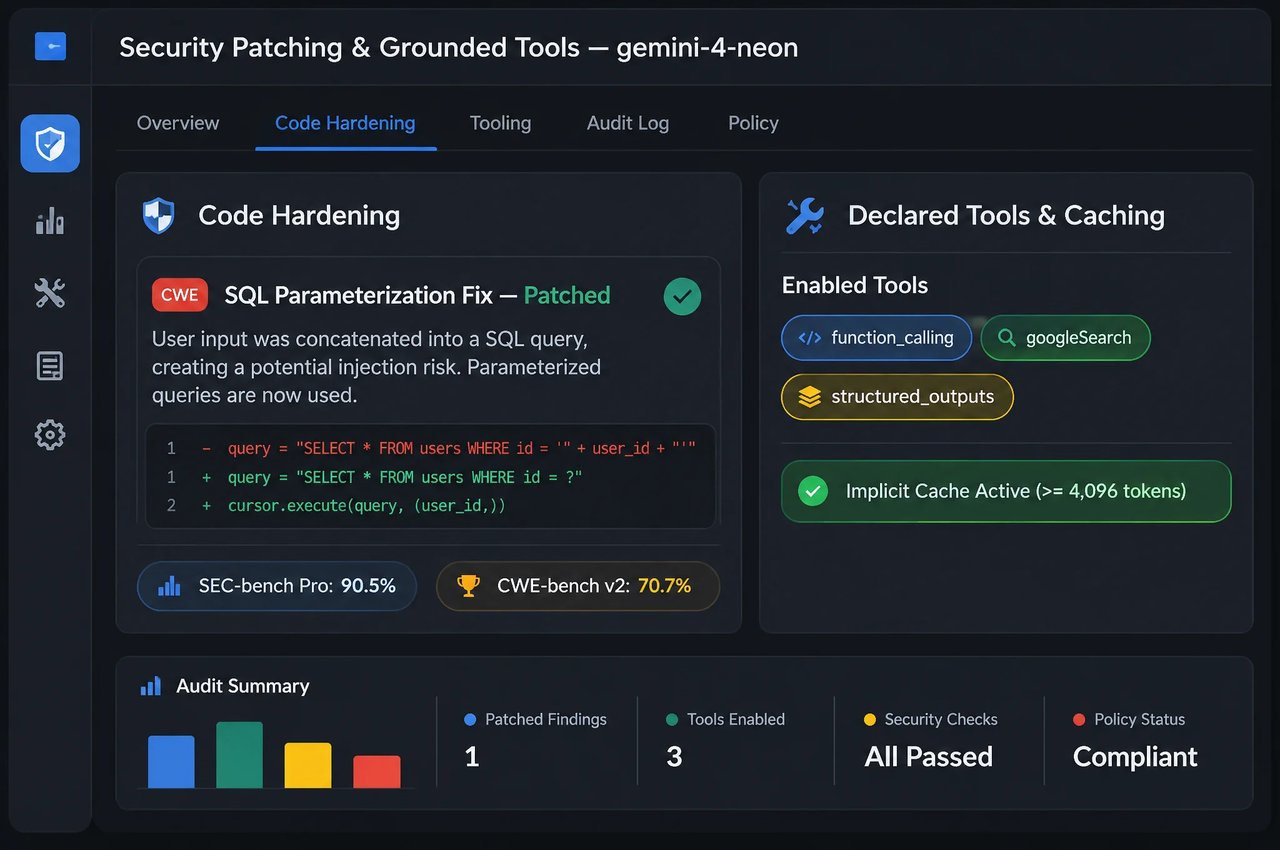
Gemini 4 Neon erzeugt sichereren Code als Gemini 4 Carbon über leichte, mittlere und schwere Aufgaben auf AutoBaxBench hinweg (76 % im schweren Bereich), erzielt 90,5 % auf SEC-bench Pro und erreicht 70,7 % auf CWE-bench v2. Beide API-Formate auf Kie.ai unterstützen Google Search-Grounding (googleSearch), benutzerdefinierte Funktionsdeklarationen, Streaming mit credits_consumed im letzten Chunk sowie implizites Context Caching.
SpecificationGemini 4 Neon
DeveloperGoogle (Google DeepMind)
Modell-IDs auf Kie.aigemini-4-neon-openai (OpenAI-kompatibel); gemini-4-neon (natives Gemini)
Veröffentlichungsdatum18. November 2026
Adaptiert vonGemini 4 Carbon
ModalitiesText-, Bild-, Video-, Audio- und PDF-Eingabe (bis zu 10 Dateien pro Request); Textausgabe
Kontextfenster1.048.576 Tokens einheitlich über Input, Thinking und Output
Max. Output-TokensStandardmäßig bis zu 65.536 Tokens pro synchrone Antwort (Thinking-Tokens zählen zum Output)
Thinking-Stufenlow, medium, high (Standard), xhigh über reasoning_effort oder thinkingLevel (minimal ignoriert; include_thoughts / includeThoughts optional)
API-Formate auf Kie.aiPOST /gemini-4-neon-openai/v1/chat/completions (stream default false); POST /gemini/v1/models/gemini-4-neon:streamGenerateContent (stream default true)
Tools & Parameter auf Kie.aiGrounding with Google Search (googleSearch), Funktionstools, response_format-JSON-Schema (OpenAI-kompatibel), implizites Caching (temperature, topP und topK haben keine Auswirkung; nur Chat-Anfragen)
WissensstichtagMärz 2026
BenchmarkGemini 4 NeonWas gemessen wird
AA Intelligence Index v5.0.161 (#3 insgesamt, bei xhigh)Index für allgemeine Leistungsfähigkeit
Vals Index v2.270,9 % (#2 insgesamt; #1 Legal Research & Tax Agent)Unternehmens-, Rechts- und Steuerevaluierungen
AA Coding Agent Index58,6 (#1 insgesamt)Evaluierung der Leistungsfähigkeit in der Softwareentwicklung
CursorBench 4.1 / Terminal-Bench 4.165,4 % / 65,2 % (um Schummeln bereinigt)Repository-Programmierung und Ausführung im Terminal
FrontierCode 2.0 / SWE-sweep46,2 % (bei high) / 39,0 % (Antigravity-Harness), 12,8 % (mini-SWE)Benchmarks für die Softwareentwicklung
Agents' Last Exam v1.1 / AutomationBench75,8 % / 56,3 % (#1 insgesamt)Mehrstufige Wissensarbeit und Workflow-Automatisierung
RiemannBench / HLE-Diamond / Terminal-Bench-Science 0.184.0% / 71.3% / 70.5%Mathematik und wissenschaftliches Schlussfolgern
GraphWalks (256K bis 1M, BFS F1)95.2%Abruf und Schlussfolgern in langen Kontexten
LVBench / Chartography / MKA89.0% / 73.5% / 56.5%Lange Videos, informationsdichte Diagramme und multimodales Schlussfolgern
SEC-bench Pro, CWE-bench v2 & WebExploitBench v1.290.5% / 70.7% / 51.3%Schwachstellenerkennung, Patchen und Websicherheit

So arbeiten Sie mit Gemini 4 Neon

Vier Vorgehensweisen für Modellauswahl, Thinking-Budgets, multimodale Eingaben und Streaming auf Kie.ai.
  1. 1

    Schritt 1: Zwischen Hydrogen, Neon und Carbon wählen

    Nutzen Sie Gemini 4 Neon für komplexe Softwareentwicklung, analytisches Reasoning und wissenschaftliche Workflows, wenn Sie die Analysetiefe führender Modelle benötigen und Aufgaben von Anfang bis Ende effizient bearbeiten möchten. Nutzen Sie Gemini 4 Hydrogen weiterhin, um Code im Alltag schnell zu schreiben und auszuführen, und reservieren Sie Gemini 4 Carbon für die anspruchsvollsten Langzeitprojekte.
  2. 2

    Schritt 2: Mit high starten und xhigh für anspruchsvolle Probleme reservieren

    Auf Kie.ai ist high das Standard-Thinking-Level. Setzen Sie reasoning_effort (OpenAI-kompatibel) oder generationConfig.thinkingConfig.thinkingLevel (nativ) auf medium oder low, um bei einfacheren Prompts weniger Tokens zu verbrauchen, oder auf xhigh für anspruchsvolle mehrstufige Aufgaben in Entwicklung, Analyse und Wissenschaft. Geben Sie für temperature, topP und topK keine Werte an, da diese Parameter bei Gemini 4 keine Wirkung haben.
  3. 3

    Schritt 3: Genügend Spielraum für Thinking- und Output-Tokens einplanen

    Input-, Thinking- und Output-Tokens teilen sich das 1.048.576-Token-Fenster, und das standardmäßige 65.536-Token-Output-Budget deckt sowohl das Thinking als auch den sichtbaren Antworttext ab. Denken Sie bei anspruchsvollen xhigh-Aufgaben daran, dass tieferes Thinking mehr von diesem gemeinsamen Output-Budget beansprucht. Pro Anfrage können Sie bis zu 10 Mediendateien übergeben.
  4. 4

    Schritt 4: Grounding, Function-Tools und Prefix-Caching nutzen

    Aktivieren Sie googleSearch, wenn Sie zur Beantwortung einer Frage Informationen aus dem Web für die Zeit nach März 2026 benötigen, deklarieren Sie benutzerdefinierte Function-Tools an einem der beiden Endpunkte oder übergeben Sie ein response_format-JSON-Schema im OpenAI-kompatiblen Endpunkt. Lassen Sie gemeinsame Prompt-Präfixe über mehrere Gesprächsrunden hinweg unverändert, damit wiederkehrender Kontext für Cached-Input-Preise infrage kommt.

Was Sie mit Gemini 4 Neon entwickeln können

Google positioniert Gemini 4 Neon für komplexes Coding, analytisches Reasoning und Wissenschaft. Auf Kie.ai unterstützt das Modell derzeit nur Chat-Anfragen, daher handelt es sich bei den folgenden Anwendungsfällen um Aufgaben, die Sie per Chat ausführen.

Dateiübergreifendes Debugging und Codebase-Refactoring

Diagnostizieren Sie modulübergreifende Bugs, prüfen Sie Pull-Requests und erstellen Sie in großen Codebasen dateiübergreifende Änderungen. Beschränken Sie diese Änderungen auf die relevanten Dateien.

Synthese von Rechts-, Steuer- und Finanzdokumenten

Fassen Sie Verträge, behördliche Einreichungen, Abrechnungen, Diagramme und aufgezeichnete Meetings – bereitgestellt als Text, Bilder, Video, Audio oder PDFs – innerhalb des gemeinsamen 1.048.576-Token-Kontexts zusammen und geben Sie die Zusammenfassung als strukturierten Bericht oder im JSON-Format aus.

Wissenschaftliche und quantitative Analyse

Nutzen Sie die Reasoning-Stufe high oder xhigh, um mathematische Beweise durchzuarbeiten, quantitative Modelle zu erstellen, Versuche zu planen und technische Forschungsprobleme zu bearbeiten.

Defensives Code-Review und Behebung von Sicherheitslücken

Nutzen Sie Gemini 4 Neon, um sichereren Code zu generieren, Repositories auf Sicherheitslücken zu prüfen und Korrekturen zu entwerfen, die die Ursachen der in den CWE-Befunden beschriebenen Schwachstellen beheben.

Gemini 4 Neon auf Kie.ai

01

Gemini 4 Neon API – Schnellstart

Testen Sie Gemini 4 Neon im Playground auf dieser Seite oder senden Sie eine POST-Anfrage mit messages an https://api.kie.ai/gemini-4-neon-openai/v1/chat/completions bzw. mit contents an https://api.kie.ai/gemini/v1/models/gemini-4-neon:streamGenerateContent. Verwenden Sie für beide Endpunkte den Header Authorization: Bearer YOUR_API_KEY. Setzen Sie reasoning_effort oder thinkingLevel auf low, medium, high oder xhigh. Auf Kie.ai unterstützt dieses Modell derzeit nur Chat-Anfragen und wurde noch nicht für die Agenten-Nutzung angepasst; die Verbindung mit einem Agenten kann zu Anfragefehlern oder unerwarteten Ergebnissen führen.
03

Ein API-Key für den gesamten Kie.ai-Marktplatz

Alle Modelle auf dem Kie.ai-Marktplatz verwenden dieselbe Authentifizierungsmethode. Senden Sie den Header Authorization: Bearer YOUR_API_KEY und ersetzen Sie YOUR_API_KEY durch Ihren API-Key aus der API-Key-Verwaltung von Kie.ai.
04

Pay-as-you-go-Credits

Kie.ai arbeitet nach dem Pay-as-you-go-Prinzip ohne Abonnementstufen: Alle Modelle greifen auf ein einziges Credit-Guthaben zu, das nie verfällt, fehlgeschlagene Anfragen werden nicht berechnet und Sie können Ihr Guthaben über die Get-Remaining-Credits-API abfragen.

Häufig gestellte Fragen

Was ist Gemini 4 Neon?

Gemini 4 Neon (gemini-4-neon) ist ein Modell von Google aus der Reihe Gemini 4 für komplexe Softwareentwicklung, analytisches Reasoning, Wissensarbeit und wissenschaftliche Workflows. Es wurde am 18. November 2026 veröffentlicht und von Gemini 4 Carbon abgeleitet. Auf Kie.ai unterstützt es derzeit nur Chat-Anfragen.

Wie schneidet Gemini 4 Neon im Vergleich zu Gemini 4 Hydrogen und Gemini 4 Carbon ab?

Google positioniert Gemini 4 Neon zwischen Gemini 4 Hydrogen und Gemini 4 Carbon. Mit Hydrogen lässt sich Code im Alltag schnell schreiben und ausführen. Carbon eignet sich für die anspruchsvollsten langfristigen Projekte. Neon bietet die Analysetiefe führender Modelle und bearbeitet Aufgaben effizient von Anfang bis Ende.

Welche Limits gelten bei Gemini 4 Neon für Kontextfenster und Output-Tokens?

Gemini 4 Neon verfügt über ein einheitliches 1.048.576-Token-Kontextfenster, das gemeinsam für Input-, Thinking- und Output-Tokens genutzt wird. In Googles Model Card sind standardmäßig bis zu 65.536 Output-Tokens pro synchroner Antwort sowie ein Wissensstand von März 2026 angegeben.

Welche Input- und Output-Modalitäten unterstützt Gemini 4 Neon?

Das Modell akzeptiert Text und bis zu 10 Mediendateien pro Anfrage: Bilder, Videos, Audiodateien und PDFs. Am OpenAI-kompatiblen Endpunkt übergeben Sie die Dateien über die einheitliche image_url-Struktur, am nativen Endpunkt über inline_data oder file_data. Die Ausgabe erfolgt als Text. Bildgenerierung, Audiogenerierung und die Live API werden nicht unterstützt.

Welche Denkstufen unterstützt Gemini 4 Neon?

Gemini 4 Neon unterstützt vier Denkstufen: low, medium, high (Standard) und xhigh. Legen Sie reasoning_effort in der OpenAI-kompatiblen API oder generationConfig.thinkingConfig.thinkingLevel in der nativen Gemini API fest und verwenden Sie include_thoughts oder includeThoughts, wenn die Gedankenausgabe zurückgegeben werden soll. Auf Kie.ai wird minimal ignoriert und temperature, topP sowie topK haben keine Wirkung.

Wie funktioniert Kontext-Caching in Gemini 4 Neon?

Implizites Kontext-Caching wird automatisch ausgeführt, wenn wiederholte Anfragen ein unverändertes Prompt-Präfix teilen (Google dokumentiert ein Minimum von 4.096 Tokens), und zwischengespeicherte Eingabe-Tokens werden zum Kie.ai-Tarif für zwischengespeicherte Eingaben abgerechnet.

Kann Gemini 4 Neon Tools und Grounding mit Google Search nutzen?

Ja. Beide Endpunkte auf Kie.ai unterstützen Grounding with Google Search (googleSearch), sodass Antworten Live-Webquellen zitieren können. Außerdem unterstützen beide Endpunkte benutzerdefinierte Funktionsdeklarationen; der OpenAI-kompatible Endpunkt unterstützt zudem JSON-Schemas über response_format.

Wie rufe ich die Gemini 4 Neon API auf Kie.ai auf?

Erstellen Sie einen API-Key auf der Kie.ai-Seite zur API-Key-Verwaltung und übergeben Sie ihn in einem Authorization: Bearer YOUR_API_KEY-Header. Senden Sie eine POST-Anfrage an /gemini-4-neon-openai/v1/chat/completions für das OpenAI-kompatible Format oder an /gemini/v1/models/gemini-4-neon:streamGenerateContent für das native Gemini-Format; beim Streaming enthält der letzte SSE-Chunk Nutzungsmetadaten und credits_consumed vor data: [DONE]. Dieses Modell unterstützt derzeit nur Chat-Anfragen und wurde noch nicht für die Agenten-Nutzung angepasst. Weitere Informationen finden Sie in der OpenAI-kompatiblen und nativen Gemini-API-Dokumentation.

Wie wird Gemini 4 Neon auf Kie.ai abgerechnet?

Gemini 4 Neon wird pro Million Tokens über Eingabe-, zwischengespeicherte Eingabe- und Ausgabe-Tokens abgerechnet, wobei Denk-Tokens in der Nutzung der Ausgabe-Tokens enthalten sind und für beide Endpunkte identische Tarife gelten. Fehlgeschlagene Anfragen werden nicht berechnet, und Credits verfallen nie. Die aktuellen Tarife pro Million Tokens werden auf der Preiskarte auf dieser Seite angezeigt.