Automatically append previous messages to maintain multi-turn context. May increase token usage.
How can I help you today?
README
Complete guide to using deepseek-v4-1-flash
DeepSeek V4.1 Flash API für multimodalen Chat
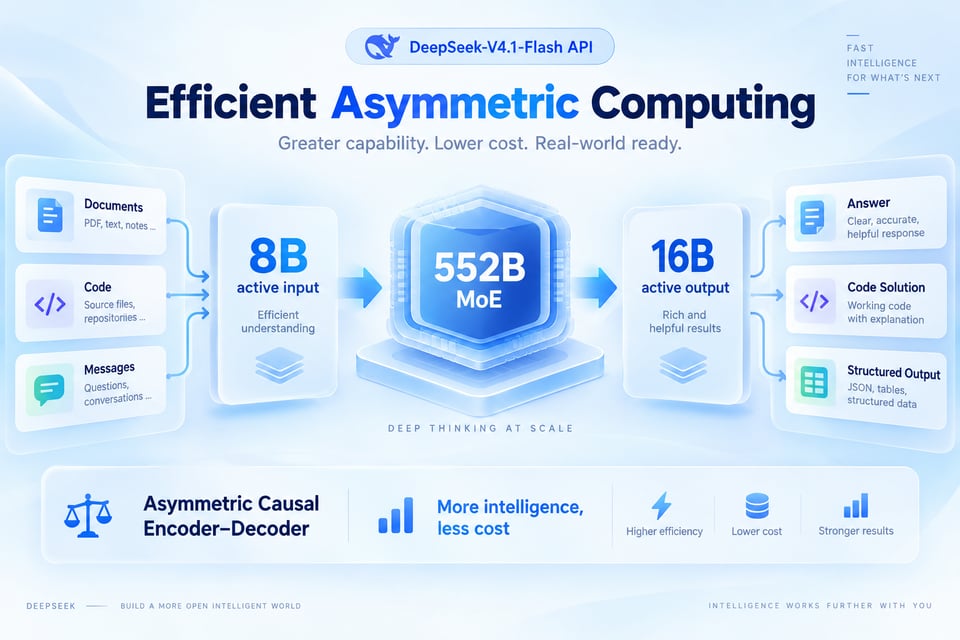
DeepSeek hat V4.1 Flash für höhere Leistungsfähigkeit, schnellere Inferenz und höheren Durchsatz entwickelt: ein 552B-Parameter-MoE-Modell, das nur 8B aktive Parameter für die Eingabe und 16B für die Ausgabe nutzt, Bilder und Text nativ liest und laut seiner Modellkarte Kontexte von bis zu einer Million Token unterstützt. Das Update vom 17. Oktober, DeepSeek V4.1 Flash 1017, behält denselben Modellnamen und dasselbe Anfrageformat bei. Auf Kie.ai rufen Sie die DeepSeek 4.1 Flash API über den mit OpenAI Responses kompatiblen Endpunkt /openai/v1/responses auf.
Parameter der DeepSeek V4.1 Flash API auf Kie.ai
| Parameter | Value |
|---|---|
| Model | deepseek-v4-1-flash |
| Endpoint | POST /openai/v1/responses, compatible with the OpenAI Responses API |
| Kontextfenster | Bis zu 1 Mio. Token (Modellkarte von DeepSeek auf Hugging Face) |
| Eingabetypen | Text und Bilder (input_text- und input_image-Teile in einer Nachricht); die Ausgabe ist Text |
| Thinking | Standardmäßig aktiviert; reasoning.effort akzeptiert none, minimal, low, medium, high, xhigh und max (none schaltet den Denkprozess aus) |
| Tools | Nur Funktions-Tools; tool_choice auto (Standard), required oder eine benannte Funktion |
| Strukturierte Ausgabe | text.format json_object oder json_schema |
| Streaming | stream true oder false |
| Nicht unterstützt | max_output_tokens, temperature und top_p haben bei diesem Modell keine Wirkung |
| Architecture | 552B-Parameter-MoE, kausaler Encoder-Decoder, 8B aktive Parameter für die Eingabe und 16B für die Ausgabe (DeepSeek) |
Hauptfunktionen der DeepSeek V4.1 Flash API
Natives Bildverständnis
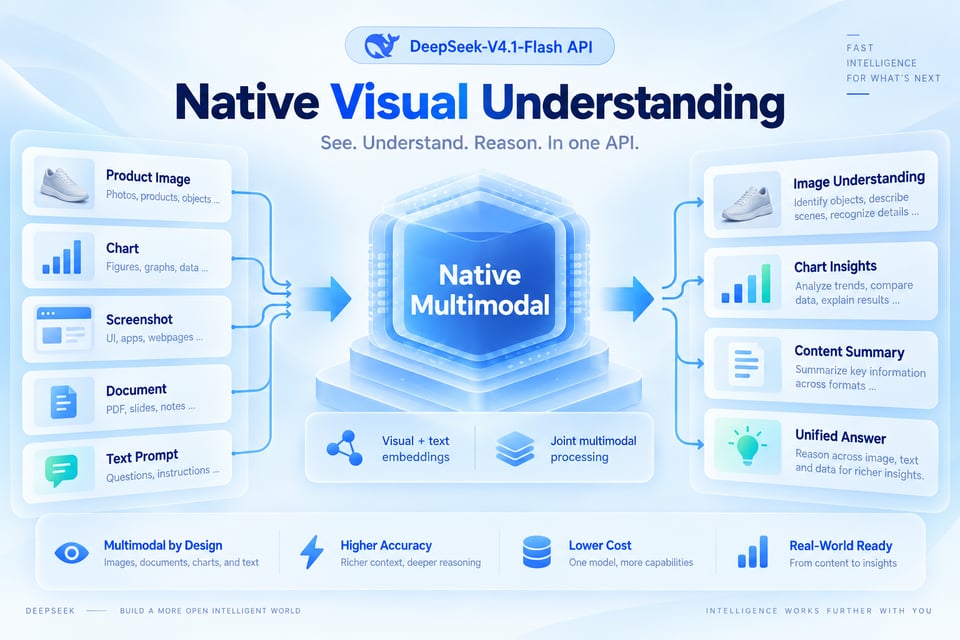
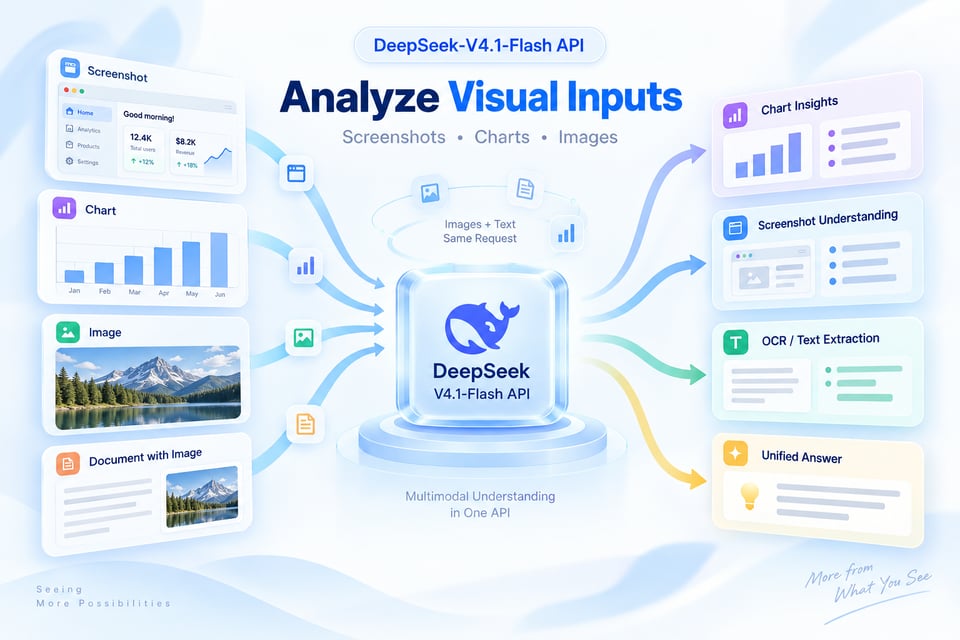
DeepSeek V4.1 Flash verarbeitet Bilder und Text nativ. Kombinieren Sie input_image- und input_text-Teile in einer Nachricht; image_url akzeptiert eine öffentlich erreichbare URL oder einen data:image-base64-String. In unserem Test auf Kie.ai las das Modell die Überschrift auf einem Bannerbild exakt aus und benannte die leuchtende Sonne im Bild.
Efficient 552B MoE-Architektur
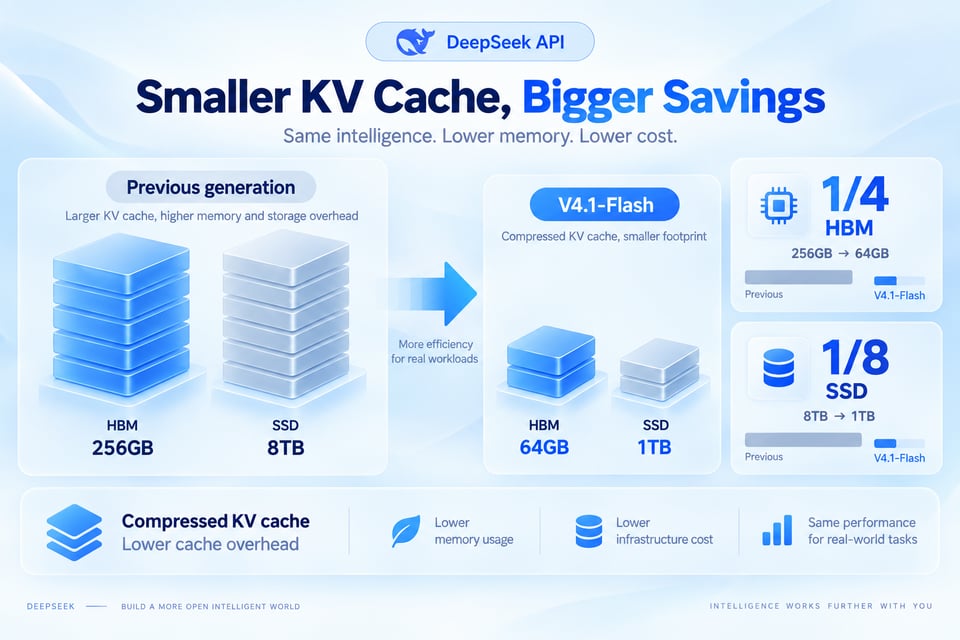
DeepSeek beschreibt V4.1 Flash als das kleinste Modell seiner neuen Architekturfamilie: ein 552B-Parameter-Mixture-of-Experts-Modell auf einer kausalen Encoder-Decoder-Architektur, das nur 8B aktive Parameter für die Eingabe und 16B für die Ausgabe nutzt. DeepSeek gibt einen KV-Cache an, der 1/4 des HBM- und 1/8 des SSD-Speichers der vorherigen Generation benötigt.
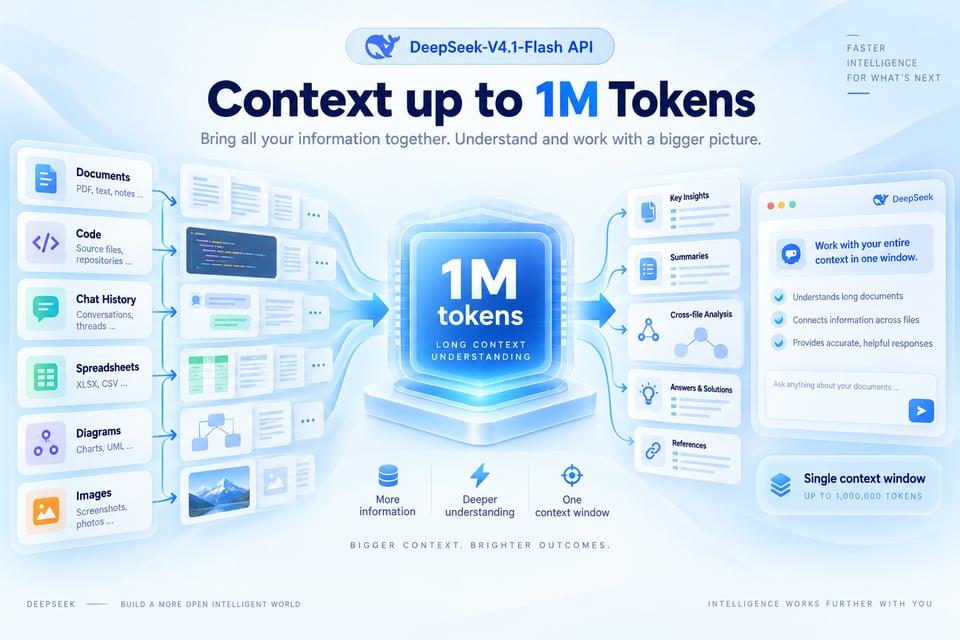
Bis zu 1 Mio. Token Kontext
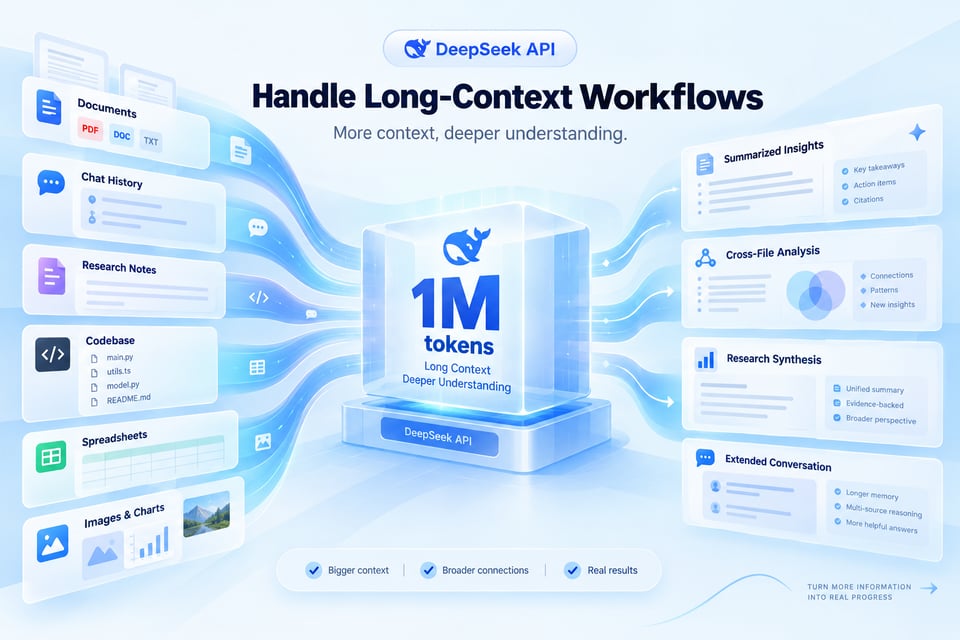
Laut der Modellkarte von DeepSeek verarbeitet V4.1 Flash Kontexte von bis zu einer Million Token, was Platz für lange Dokumente und große Codebasen bietet. Die Dokumentation von Kie.ai führt kein separates Kontextlimit für dieses Modell auf.
Denkprozess: hochregeln oder abschalten
Das Modell nutzt standardmäßig einen Denkprozess. Setzen Sie reasoning.effort auf none, um den Denkprozess auszuschalten, auf minimal, um ihn kurz zu halten, oder auf low, medium, high, xhigh bzw. max für tiefere Schlussfolgerungen.
Funktions-Tools und JSON-Ausgabe
Deklarieren Sie Funktions-Tools und lassen Sie das Modell mit tool_choice auto selbst wählen, erzwingen Sie einen Aufruf oder legen Sie eine benannte Funktion fest; senden Sie Ergebnisse als function_call_output verknüpft über call_id zurück. Setzen Sie text.format auf json_object oder json_schema für eine Ausgabe, die Ihr Code parsen kann.
Update 1017: gleiche Integration
DeepSeek V4.1 Flash 1017, veröffentlicht am 17. Oktober 2026, bietet laut DeepSeek eine stärkere Benchmark-Leistung, eine schnellere Aufgabenbearbeitung und kürzere Ausgaben als die vorherige Version. Modellname, Endpunkt und Anfrageformat bleiben unverändert, sodass bestehende Integrationen weiterhin funktionieren.
Benchmark-Ergebnisse von DeepSeek V4.1 Flash 1017 im Vergleich zur vorherigen Version
Von DeepSeek gemeldete Ergebnisse aus der Modellkarte auf Hugging Face für das Update 1017. Terminal-Bench 4.0 lief mit der Testumgebung Claude Code und DeepSWE v1.1 mit der Testumgebung Mini-SWE-V2.
| Benchmark | V4.1 Flash 1017 | Vorheriges V4.1 Flash |
|---|---|---|
| HLE (ohne Tools) | 42.6 | 36.8 |
| Terminal-Bench 4.0 | 42.3 | 31.2 |
| DeepSWE v1.1 | 77.0 | 74.2 |
| ProgramBench | 29.1 | 20.3 |
| NL2Repo-Bench | 68.2 | 65.4 |
| Apex Bench v1.1 | 72.1 | 64.6 |
| Chartography (mit Tools) | 83.0 | 78.9 |
| BabyVision (mit Tools) | 92.5 | 89.6 |
So nutzen Sie die DeepSeek-V4.1-Flash-API auf Kie.ai
Schritt 1. Ihren API-Key abrufen
Schritt 2. Eine Anfrage senden
Schritt 3. Bilder, Tools und JSON-Ausgabe hinzufügen
Warum Sie die DeepSeek-V4.1-Flash-API auf Kie.ai nutzen sollten
Derselbe Schlüssel für den gesamten Kie.ai-Marktplatz
Alle Modelle auf dem Kie.ai-Marktplatz verwenden dieselbe Authentifizierungsmethode: einen Header Authorization: Bearer YOUR_API_KEY mit dem Schlüssel von Ihrer Seite zur API-Key-Verwaltung auf Kie.ai.
Kostenlose Credits und ein gemeinsames Guthaben
Neue Kie.ai-Nutzer erhalten 80 kostenlose Credits zum Testen. Ihr Konto verfügt über ein gemeinsames Credit-Guthaben, auf das alle Generierungsdienste zugreifen, und Sie können es über die API „Get Remaining Credits“ prüfen.
Nichts zu hosten oder zu installieren
Kie.ai stellt dieses Modell als API mit einem Playground bereit; es muss keine App heruntergeladen oder installiert werden. Es müssen weder GPUs noch Modellgewichte verwaltet werden.
Was Sie mit der DeepSeek-V4.1-Flash-API entwickeln können
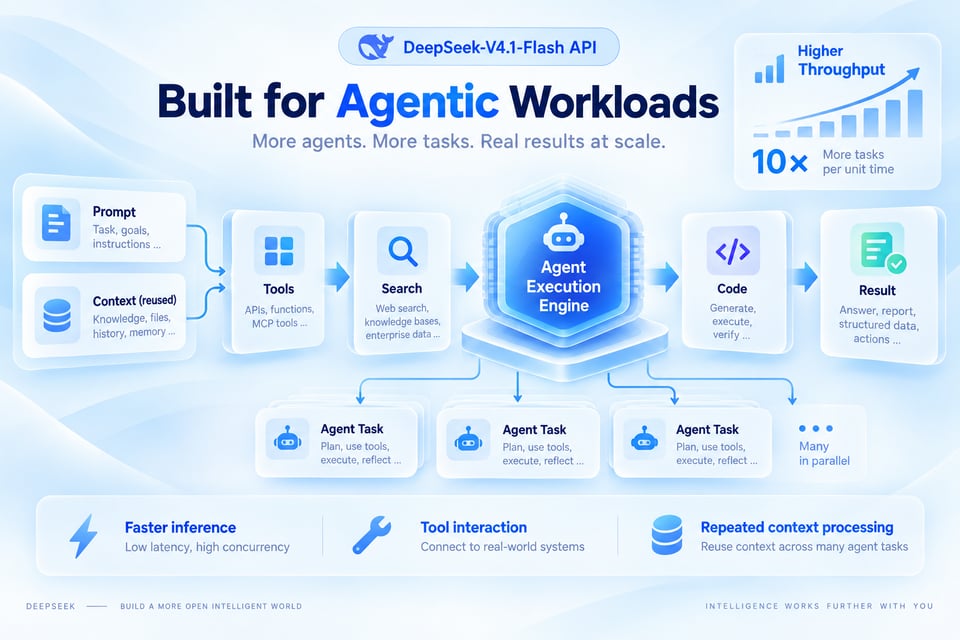
DeepSeek hat V4.1 Flash für eine schnellere Inferenz und einen höheren Durchsatz entwickelt. Für ein größeres Modell mit offenen Gewichten und einem Kontextfenster von 1 Million Token auf demselben Endpunkt sehen Sie sich die Kimi-K3.1-Pro-API an.
Chat sowie Fragen und Antworten zu Bildern
Beantworten von Fragen zu Screenshots, Diagrammen, Bannern und Fotos zusammen mit Text in derselben Nachricht.
Fragen zu langen Dokumenten und Codebasen
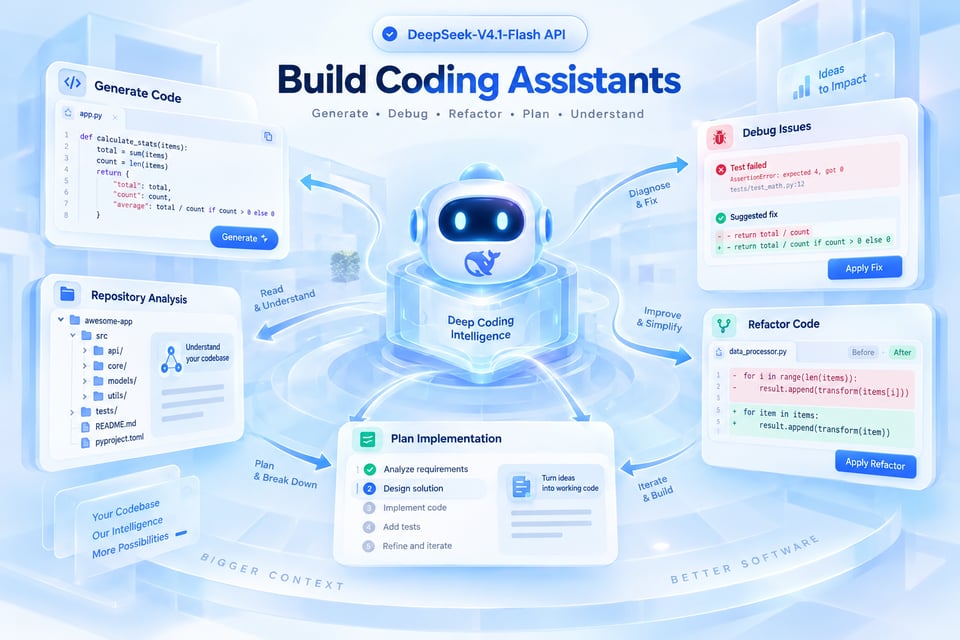
Durcharbeiten langer Dokumente oder großer Codebasen in einer einzigen Anfrage; die Modellkarte von DeepSeek gibt Kontexte von bis zu einer Million Token an.
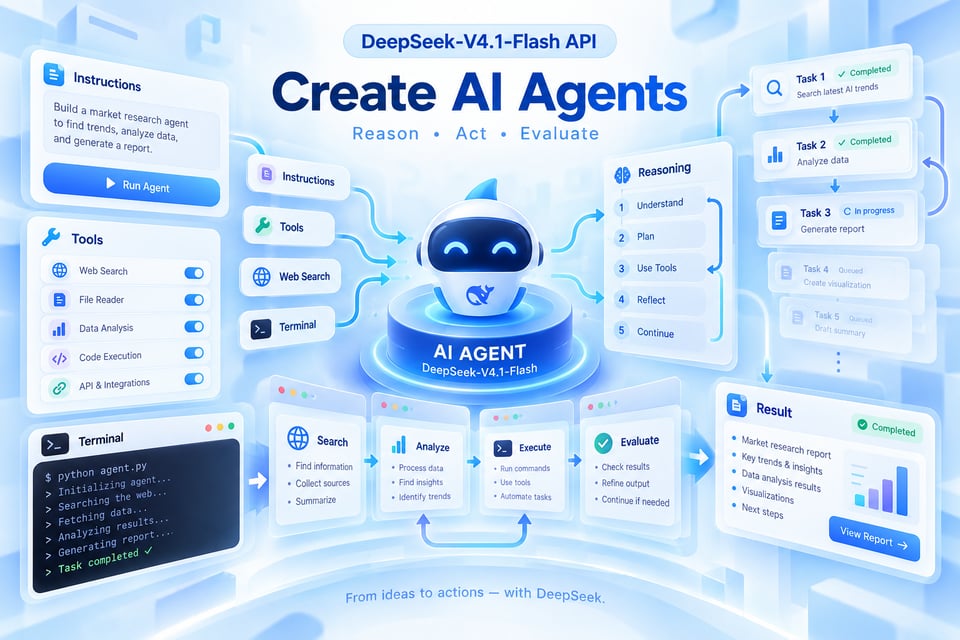
Strukturierte Extraktion
Extrahieren von Feldern aus Text oder Bildern in JSON, das über text.format json_schema Ihrem Schema folgt.
Chat-Funktionen mit hohem Volumen
Bereitstellen von Chat-Funktionen, bei denen es auf den Durchsatz ankommt, wobei das Denken für einfache Anfragen reduziert oder deaktiviert wird.