Automatically append previous messages to maintain multi-turn context. May increase token usage.
How can I help you today?
README
Complete guide to using grok-4-7
Grok 4.7 API – Entwickle mit xAI Grok 4.7 auf Kie AI
Greif auf die Grok 4.7 API bei Kie AI zu – ideal für anspruchsvolles Coding, logisches Denken, Agenten-basierte Workflows und professionelle Wissensarbeit. Teste Grok 4.7 kostenlos mit Neukunden-Guthaben und integriere es dank flexibler API-Tarife nahtlos in deine Anwendungen.
Entdecken Sie die Möglichkeiten der Grok 4.7 API auf Kie AI
Mehrstufige Aufgaben meistern mit der Grok 4.7 API
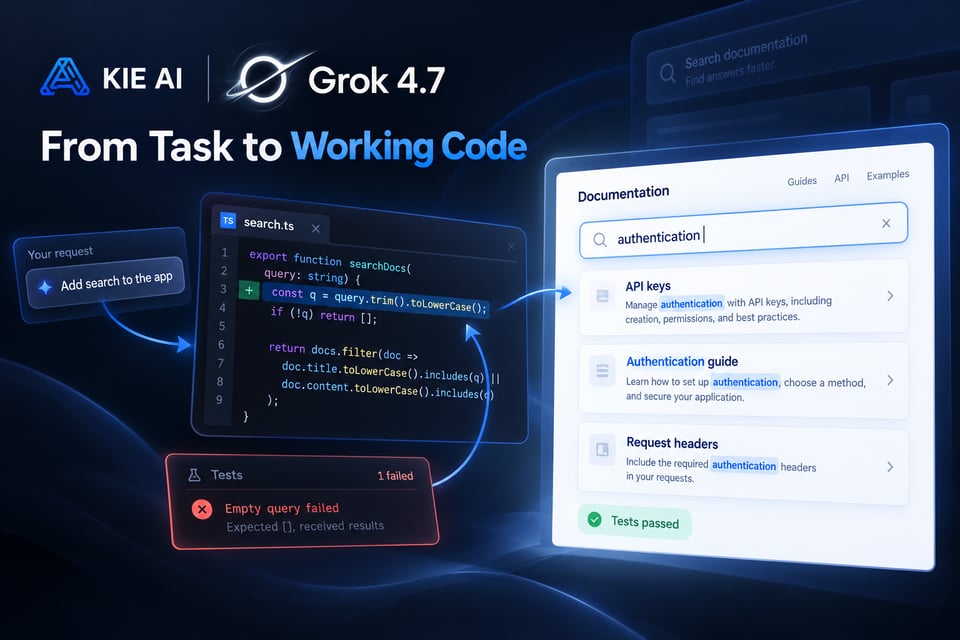
Nutze die Grok 4.7 API für Aufgaben, die mehrere Schritte und erweiterte Denkprozesse erfordern. Grok 4.7 wurde mit einem anspruchsvolleren Mix aus Problemstellungen trainiert, mit Schwerpunkt auf Aufgaben, die mehr Zeit beanspruchen. Dieses Design unterstützt Workflows wie mehrstufiges Coding, Recherchen, Analysen und Agenten-basierte Aufgabenausführung.
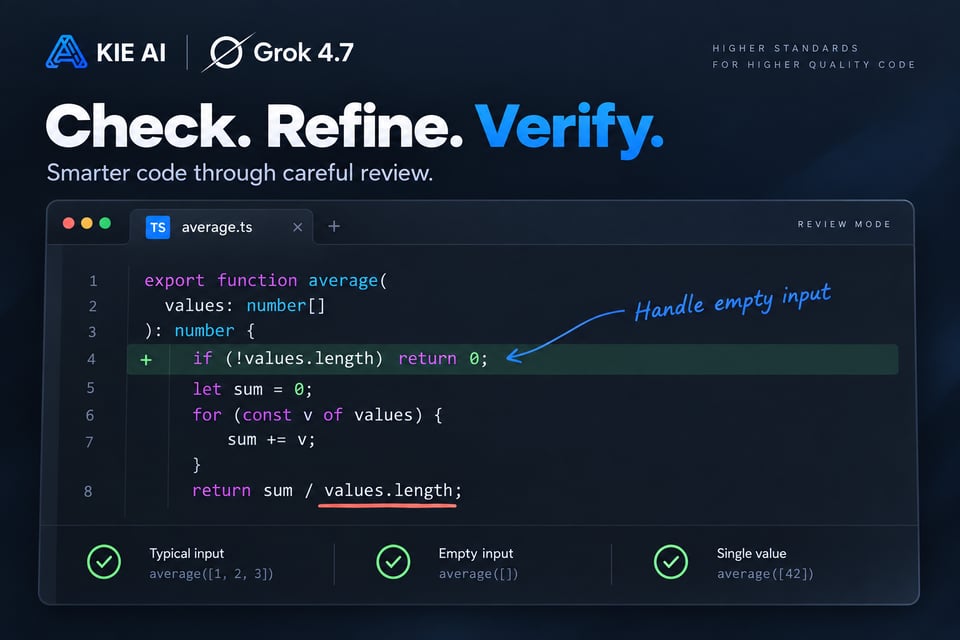
Bessere Selbstüberprüfung mit xAI Grok 4.7
Optimieren Sie komplexe Workflows mit einem Modell, das seine eigene Arbeit noch präziser überprüft. xAI Grok 4.7 bietet stärkere Fähigkeiten zur Selbstüberprüfung und hilft dabei, Zwischenergebnisse zu kontrollieren und anspruchsvolle Aufgaben effektiver zu bewältigen. Mit der Grok 4.7 API können Entwickler diese Fähigkeit fürs Coding sowie für Forschung, Analyse und weitere mehrstufige Aufgaben nutzen, bei denen es auf Genauigkeit und Konsistenz ankommt.
Entwickeln Sie fortschrittliche Coding-Workflows mit der Grok 4.7 API
Nutzen Sie die Grok 4.7 API für anspruchsvolle Software-Engineering-Aufgaben – von Codegenerierung und Debugging bis hin zu Repository-Analyse und längeren Entwicklungs-Workflows. Grok 4.7 zeigt in wichtigen Software-Engineering-Benchmarks eine stärkere Leistung als Grok 4.6 und eignet sich daher ideal für Coding-Assistenten, Entwicklertools und agentenbasierte Coding-Anwendungen.

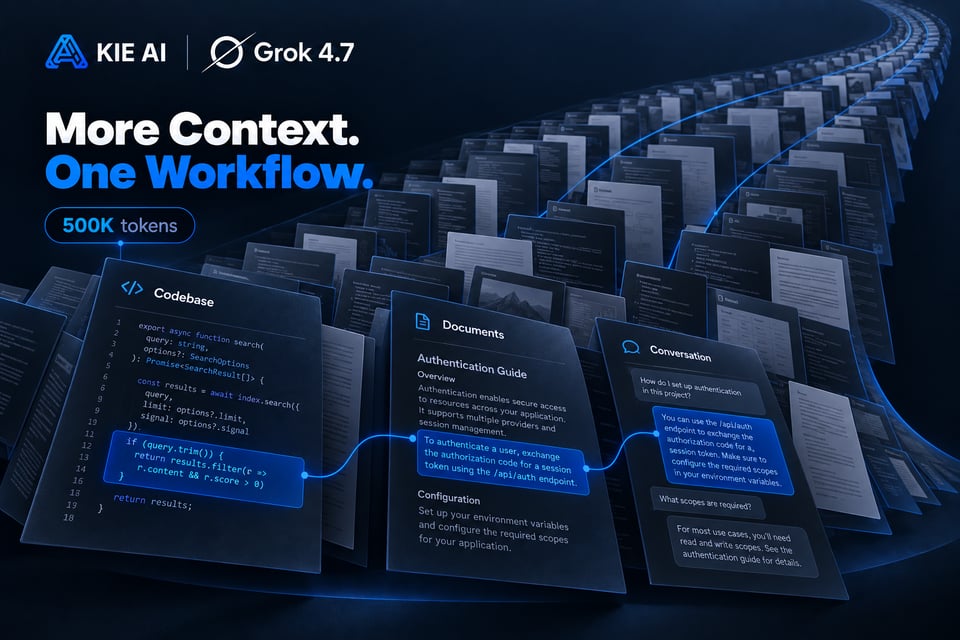
Mehr verarbeiten mit dem 500K-Kontextfenster der Grok-API
Arbeiten Sie mit bis zu 500.000 Token Kontext in einem einzigen Grok 4.7-Workflow. Das große Kontextfenster hilft der Grok 4.7 API dabei, umfangreiche Codebasen, lange Dokumente, detaillierte Anweisungen und ausgedehnte Chat-Verläufe zu verarbeiten. Entwickler können dem Modell mehr relevanten Kontext bereitstellen, ohne komplexe Eingaben in viele kleinere Anfragen aufteilen zu müssen.
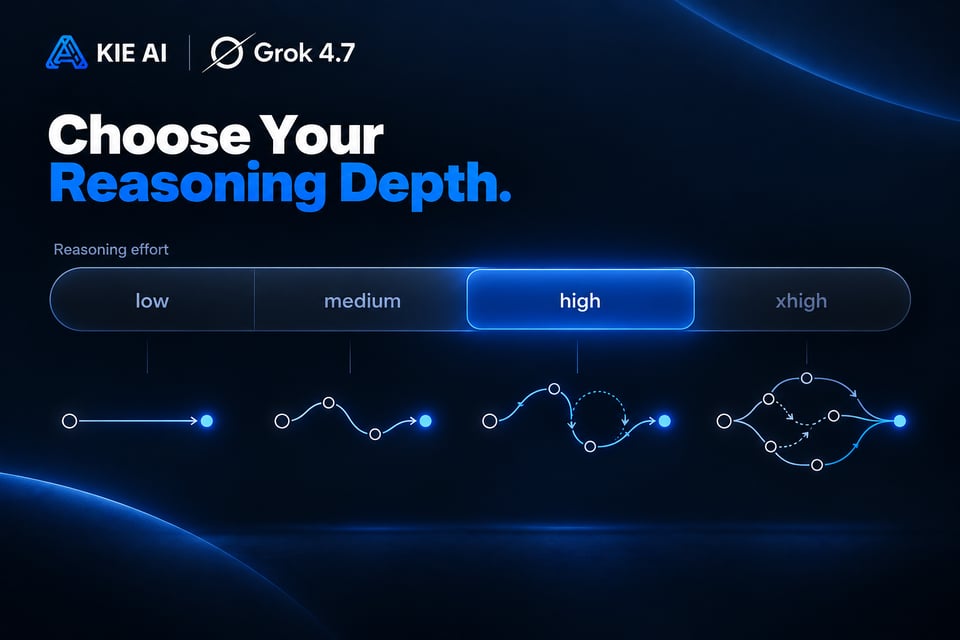
Steuern Sie das Grok 4.7 Reasoning über vier Aufwandsstufen
Passen Sie die Reasoning-Tiefe an die Anforderungen der jeweiligen Anwendung an. Die Grok 4.7 API unterstützt die Aufwandsstufen Low, Medium, High und xHigh. So erhalten Entwickler mehr Kontrolle darüber, wie intensiv das Modell ein Problem durchdenkt. Nutzen Sie einen niedrigeren Aufwand für einfachere oder latenzempfindliche Aufgaben und einen höheren Aufwand, wenn Ihr Grok API-Workflow tiefergehende Analysen und mehrstufiges Reasoning erfordert.
Professionelle Wissensarbeit meistern mit Grok 4.7
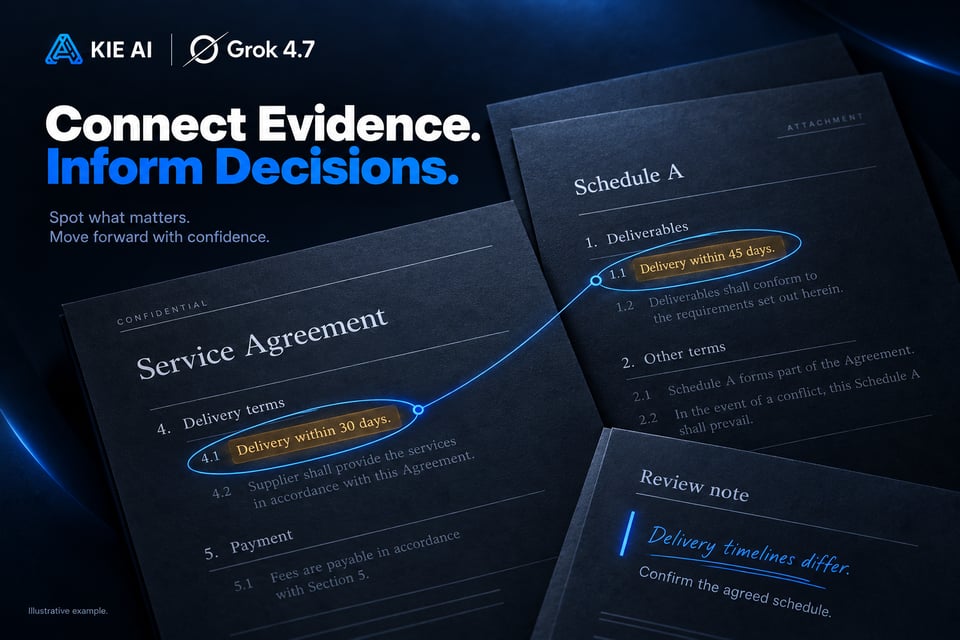
Nutzen Sie die Grok 4.7 API über das reine Coding hinaus für anspruchsvolle professionelle Aufgaben. Grok 4.7 zeigt Verbesserungen in Benchmarks, die mehrstündige Büroarbeit, Elektrotechnik, juristische Aufgaben und andere wissensintensive Workloads abdecken. Verwenden Sie die Grok 4.7 API auf Kie AI, um Recherchen, Dokumentenanalysen, professionelle Content-Workflows und SaaS-Tools anzutreiben, die ein stärkeres Reasoning bei spezialisierten Fachinformationen erfordern.
Grok 4.7 API Performance-Benchmarks
Überzeugende Ergebnisse in Coding und professioneller Wissensarbeit
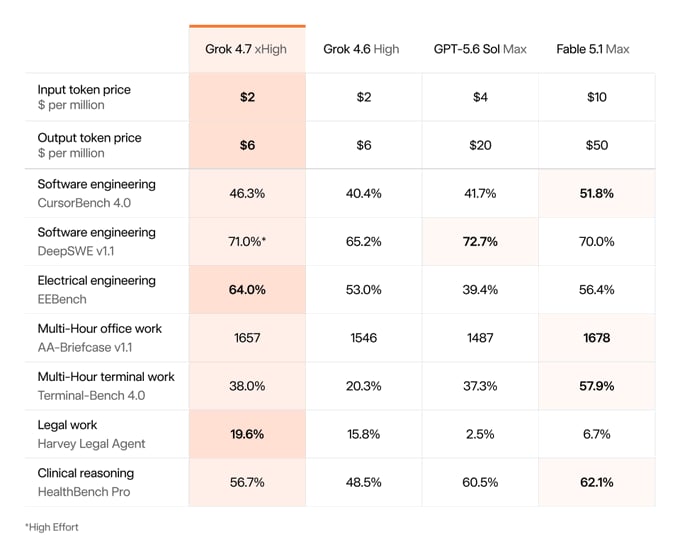
Laut den von SpaceXAI veröffentlichten Benchmark-Ergebnissen erreicht Grok 4.7 46,3 % bei CursorBench 4.0, 71,0 % bei DeepSWE v1.1 (bei hohem Aufwand), 64,0 % bei EEBench und 1.657 bei AA Briefcase v1.1. Diese Benchmarks bewerten verschiedene Bereiche, darunter Software Engineering, mehrstufige Coding-Aufgaben, Elektrotechnik und professionelle Büroarbeit.
Grok 4.7 vs. Grok 4.6: Was hat sich geändert?
Im Vergleich zu Grok 4.6 nutzt Grok 4.7 ein neues, größeres Basismodell und einen längeren Reinforcement-Learning-Durchlauf, der auf anspruchsvollere, langwierige Aufgaben ausgerichtet ist. Zudem verbessert es die Selbstverifizierung sowie das Long-Context-Management. Dadurch arbeitet die Grok 4.7 API bei der Programmierung, im Engineering, bei professioneller Wissensarbeit und anderen komplexen Workflows noch effizienter. Offizielle Benchmarks zeigen, dass Grok 4.7 in allen sieben unten aufgeführten Tests höhere Werte erzielt.
| Benchmark | Grok 4.7 | Grok 4.6 |
|---|---|---|
| CursorBench 4.0 | 46,3% | 40,4% |
| DeepSWE v1.1 | 71,0%* | 65,2% |
| EEBench | 64,0% | 53,0% |
| AA Briefcase v1.1 | 1.657 | 1.546 |
| Terminal-Bench 4.0 | 38,0% | 20,3% |
| Harvey Legal Agent Benchmark | 19,6% | 15,8% |
| HealthBench Professional | 56,7% | 48,5% |
| Der DeepSWE v1.1-Score von Grok 4.7 nutzt einen hohen Reasoning-Aufwand. Die Ergebnisse basieren auf den von SpaceXAI veröffentlichten Benchmarks. |
So nutzt du die Grok 4.7 API auf Kie AI
Schritt 1: Grok 4.7 kostenlos im Playground testen
Schritt 2: Grok 4.7 API-Schlüssel abrufen
Schritt 3: Erste Grok 4.7 API-Anfrage senden
Schritt 4: Grok 4.7 API in deine App integrieren
Entwickeln Sie leistungsstarke KI-Anwendungen mit der Grok 4.7-API auf Kie AI
KI-Coding-Agenten entwickeln mit der Grok 4.7 API
Entwickle Coding-Copilots, Debugging-Assistenten, Code-Review-Tools und autonome Entwicklungs-Agenten mit der Grok 4.7 API. Gib deinen Anwendungen die Fähigkeit, Code zu verstehen, Software-Engineering-Probleme zu durchdenken und umfangreiche Entwicklungsaufgaben zu bewältigen. Die Grok API ist ideal für Entwicklerprodukte, die weit mehr als nur einfache Code-Vervollständigung erfordern.
SaaS-KI-Assistenten erstellen mit xAI Grok 4.7
Integriere xAI Grok 4.7 in SaaS-Produkte, Produktivitätsplattformen, interne Tools und kundenorientierte KI-Funktionen. Nutze die Grok 4.7 API für leistungsstarke Assistenten, die detaillierte Anfragen verstehen, komplexe Probleme lösen und Nutzer durch mehrstufige Workflows führen.
Lange Dokumente analysieren mit der Grok 4.7 API
Entwickeln Sie Anwendungen zur Verarbeitung großer Dokumente und kontextintensiver Eingaben. Mit ihrem 500K-Kontextfenster unterstützt die Grok 4.7 API Workflows für Berichte, technische Dokumente, Verträge, Forschungsmaterialien und umfangreiche Textsammlungen. Damit ist sie ideal für Dokumentenanalyse, Zusammenfassung, Informationsextraktion und die Beantwortung von Fragen.
Professionelle Workflows mit der Grok API automatisieren
Nutzen Sie die Grok 4.7 API, um wissensintensive Aufgaben in professionellen Workflows zu automatisieren. Entwickeln Sie Tools für Dokumentenerstellung, Analyse, Reporting, Recherche und andere Aufgaben, die komplexes Schlussfolgern erfordern. Entwickler können die Grok API in interne Systeme oder SaaS-Produkte integrieren, um Routinearbeiten zu reduzieren und gleichzeitig komplexe Informationen im Kontext zu behalten.
Leistungsstarke Recherche-Anwendungen mit xAI Grok 4.7 entwickeln
Erstellen Sie Recherche-Assistenten und Wissensanwendungen, die detaillierte Informationen verarbeiten und Erkenntnisse aus umfangreichen Eingabedaten verknüpfen. Die Grok 4.7 API unterstützt Forschungssynthese, die Beantwortung von Fragen, die Auswertung von Dokumenten und wissensintensive Workflows, bei denen Nutzer mehr als nur eine schnell generierte Antwort benötigen.
Tool-nutzende KI-Agenten mit der Grok 4.7 API entwickeln
Erstellen Sie KI-Agenten, die von der Analyse zur Aktion übergehen. Kombinieren Sie die Grok 4.7-API mit Function Calling, strukturierten Ausgaben, externen APIs, Datenbanken und Anwendungstools, um Agenten zu entwickeln, die echte Workflows ausführen können. Setzen Sie diese für SaaS-Automatisierung, Entwickler-Agenten, Forschungssysteme und andere Anwendungen ein, die mit Tools außerhalb des eigentlichen Modells interagieren müssen.
Grok 4.7 vs. Fable 5.1 vs. GPT-6 Astra
Grok 4.7 vs. Fable 5.1: Coding und langfristige Aufgaben
Beide Modelle zielen auf komplexes Coding und langfristige Aufgaben ab. Laut SpaceXAI erreicht Grok 4.7 bei DeepSWE v1.1 (High Effort) 71,0 %, verglichen mit 70,0 % bei Fable 5.1, während Fable 5.1 bei einigen anderen Benchmarks für Coding und professionelle Aufgaben vorn liegt. Unabhängige Tests von Artificial Analysis zählen ebenfalls beide zu den führenden Modellen für Agenten-Workloads.
Grok 4.7 vs. GPT-6 Astra: Leistung, Effizienz und Kosten
Unabhängige Tests zeigen unterschiedliche Kompromisse zwischen den beiden Modellen auf. Im Intelligence Index von Artificial Analysis erreicht GPT-6 Astra Max 53 Punkte und Grok 4.7 xHigh 46 Punkte, während Grok 4.7 bei einigen Evaluierungen für langfristige professionelle Aufgaben bessere Ergebnisse erzielt und niedrigere Preise pro Token aufweist.Kie AI unterstützt Grok 4.7, Fable 5.1, GPT-6 Astra und weitere führende Modelle über eine einzige API-Plattform, was das Testen und Auswählen von Modellen für verschiedene Workloads erleichtert.
Warum Kie AI für die Grok 4.7 API?
Zugriff auf mehrere Grok-APIs an einem zentralen Ort
Nutzen Sie mehr als nur die Grok 4.7 API – mit einer zentralen Plattform für verschiedene Grok-Modelle und -Funktionen. Greifen Sie über Kie AI auf Grok-Sprachmodelle sowie die Grok-Bildgenerierung und Grok Imagine APIs zu. So erstellen Sie mühelos Text-, Bild- und multimodale KI-Workflows, ohne zwischen verschiedenen Plattformen hin- und herwechseln zu müssen.
Grok 4.7 kostenlos testen mit Startguthaben für Neukunden
Neukunden erhalten bei Kie AI ein kostenloses Startguthaben. Nutzen Sie Ihr Guthaben, um Grok 4.7 im Online-Playground unverbindlich zu testen, echte Prompts auszuprobieren und das Modell zu erkunden, bevor Kosten anfallen. Wenn Sie startklar sind, wechseln Sie einfach direkt vom Testen zur Grok 4.7 API.
Faire Grok 4.7 API-Preise
Halten Sie Ihre API-Kosten flexibel durch günstige, nutzungsbasierte Preise. Mit Kie AI zahlen Sie nur für die API-Kapazitäten, die Sie tatsächlich benötigen. Dadurch ist die Grok 4.7 API ideal für erste Tests, wachsende SaaS-Produkte und umfangreiche Produktions-Workloads – ganz ohne fixe Vorabkosten.
Einfache Grok API-Integration dank klarer Dokumentation
Legen Sie ohne kompliziertes Setup direkt los. Kie AI bietet eine übersichtliche API-Dokumentation und einen unkomplizierten Integrations-Workflow. So können Entwickler die Grok 4.7 API reibungslos in SaaS-Produkte, KI-Agenten, Entwicklertools und Backend-Dienste einbinden.
Immer auf dem neuesten Stand mit den aktuellen Grok APIs
Entwickle weiter mit einer Modellbibliothek, die mit dem KI-Ökosystem wächst. Kie AI integriert kontinuierlich neue und aktualisierte Modelle, einschließlich der neuesten Grok APIs, sobald diese verfügbar sind. Greife zentral an einem Ort auf die Grok 4.7 API und zukünftige Grok-Modelle zu, um neue Funktionen zu testen und diese schneller in deine Anwendungen zu integrieren.
24/7-Support für deine Grok API-Integration
Hol dir mit unserem 24/7-Kundensupport jederzeit die Hilfe, die du brauchst. Ob du Fragen zur Grok 4.7 API, zur Kontonutzung, Abrechnung oder zu Integrationsproblemen hast – der Support von Kie AI ist rund um die Uhr für dich da, damit dein Entwicklungs-Workflow reibungslos am Laufen bleibt.