Automatically append previous messages to maintain multi-turn context. May increase token usage.
How can I help you today?
Automatically append previous messages to maintain multi-turn context. May increase token usage.
How can I help you today?
README
Complete guide to using Gemini 3.8 Flash
API de Gemini 3.8 Flash para programación avanzada y agentes de IA
Crea agentes de programación y flujos de trabajo de IA complejos con la API de Gemini 3.8 Flash en Kie AI. Obtén razonamiento avanzado, programación de largo alcance y funciones de agentes a través de una API fácil de integrar.
Características principales de la API de Gemini 3.8 Flash en Kie AI
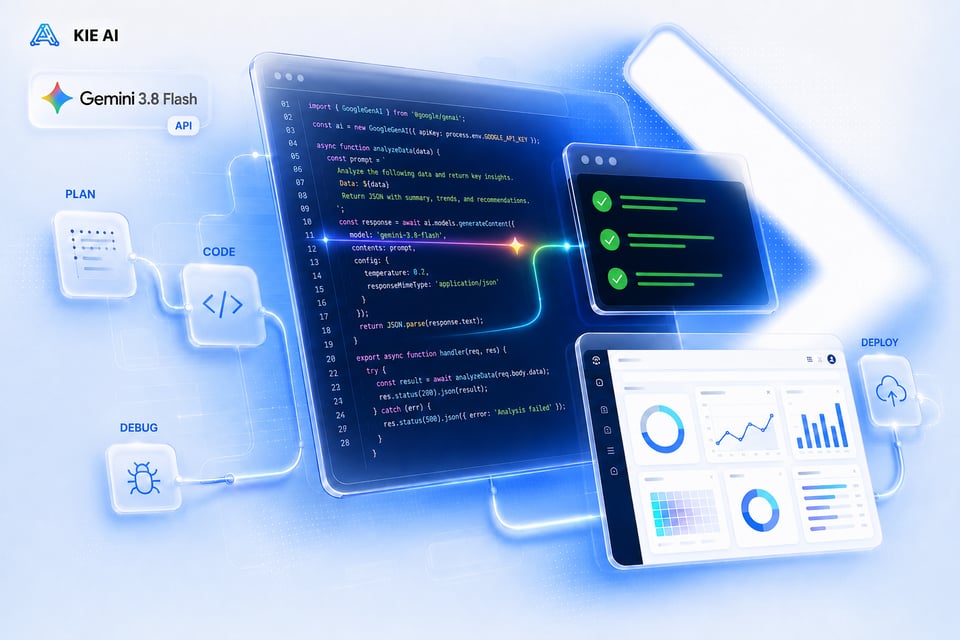
Programación avanzada con la API de Google Gemini 3.8 Flash
Desarrolla herramientas de programación más potentes con la API de Google Gemini 3.8 Flash. El modelo mejora la ingeniería de software, la generación de código complejo, la depuración y el análisis de bases de código, destacando en tareas de desarrollo de largo alcance. Es capaz de resolver problemas de ingeniería en múltiples pasos, desde la planificación hasta la implementación, lo que convierte a Gemini 3.8 Flash en la opción ideal para agentes de programación con IA y herramientas para desarrolladores.
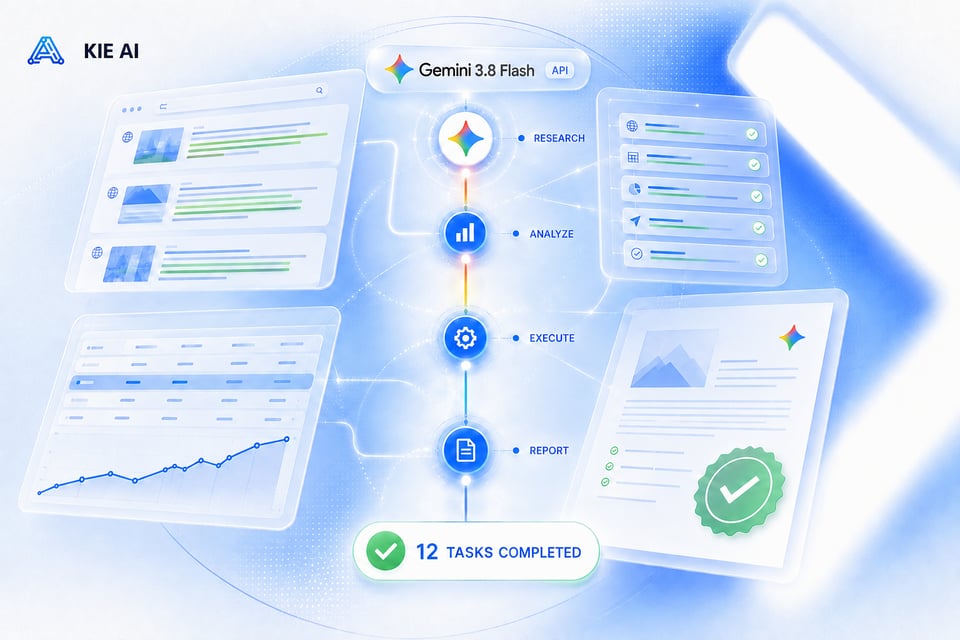
Gemini 3.8 Flash para flujos de trabajo con agentes de largo alcance
Gestiona tareas que van más allá de un simple prompt y respuesta. Gemini 3.8 Flash puede razonar en múltiples pasos, procesar tareas de larga duración y refinar su enfoque a medida que evoluciona el problema. Estas capacidades hacen que la API de Gemini 3.8 Flash sea ideal para agentes autónomos, flujos de trabajo de investigación y automatización compleja de SaaS.
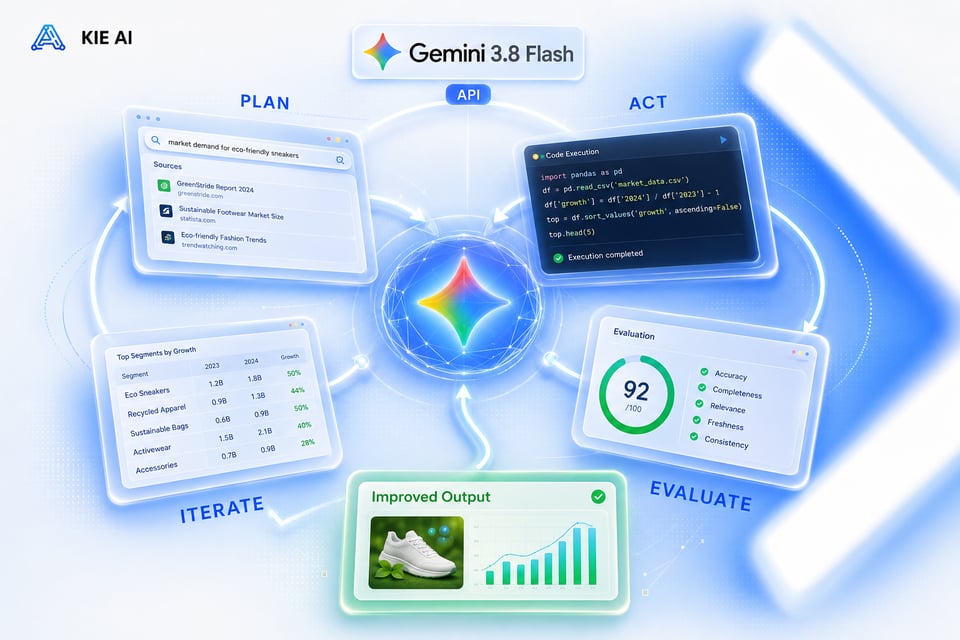
Invocación iterativa de herramientas con la API de Gemini 3.8 Flash
Crea agentes de IA capaces de planificar, actuar, evaluar resultados y seguir trabajando para alcanzar un objetivo. En tareas complejas, la API de Gemini 3.8 Flash puede ejecutar pasos de razonamiento adicionales e invocar herramientas de forma iterativa para mejorar los resultados. Esto ofrece a los desarrolladores una base más sólida para construir agentes que utilizan herramientas y flujos de trabajo automatizados de múltiples pasos.
Razonamiento de Gemini 3.8 Flash para Finanzas, el sector legal y STEM
Aplica Gemini 3.8 Flash en tareas intensivas en conocimiento en sectores como finanzas, el sector legal, STEM, investigación y otros campos profesionales. Su potente razonamiento de múltiples pasos permite a las aplicaciones analizar información compleja, resolver problemas especializados y generar resultados detallados, convirtiendo a la API de Gemini en una herramienta clave para asistentes de IA profesionales y productos SaaS verticales.
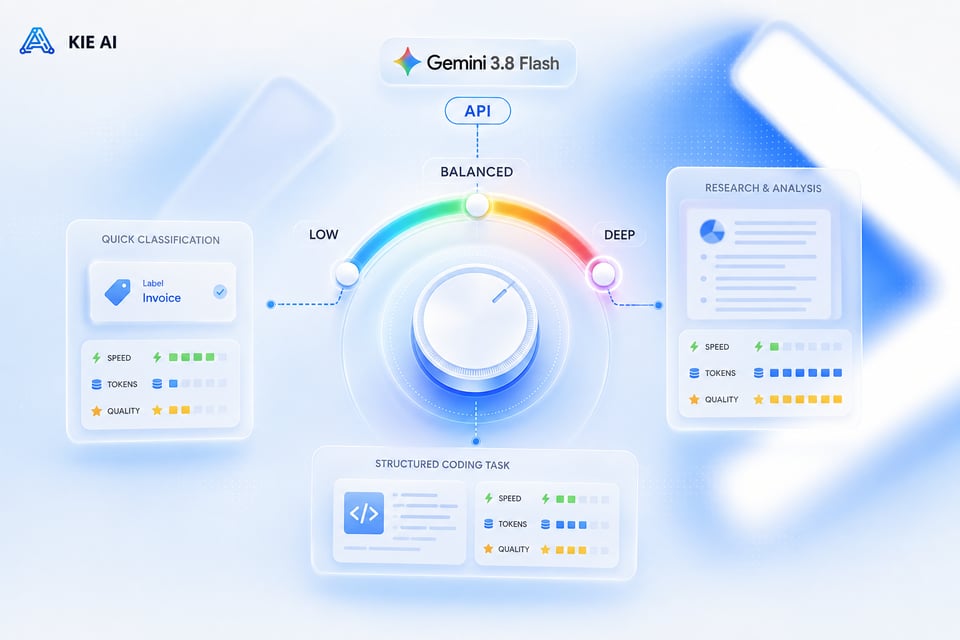
Nivel de razonamiento flexible con Google Gemini 3.8 Flash
Equilibra el rendimiento del modelo y el uso de tokens según tu carga de trabajo. Google Gemini 3.8 Flash puede aplicar un mayor esfuerzo de razonamiento en problemas difíciles, mientras que los niveles de esfuerzo más bajos ayudan a reducir el gasto adicional de tokens cuando la eficiencia es lo más importante. Esta flexibilidad permite a los desarrolladores ajustar la API de Gemini 3.8 Flash para diferentes tareas, presupuestos y requisitos de producción.
API de Gemini rápida y rentable para aplicaciones en producción
Obtén mayor capacidad de razonamiento y programación sin perder la velocidad y las ventajas de bajo coste de la familia Flash. La API de Gemini 3.8 Flash está diseñada para desarrolladores que necesitan funciones avanzadas de IA sin depender de modelos de vanguardia más caros en cada petición. Úsala para potenciar agentes de IA escalables, productos de programación y aplicaciones SaaS, manteniendo los costes de producción bajo control.
Benchmark y rendimiento de Gemini 3.8
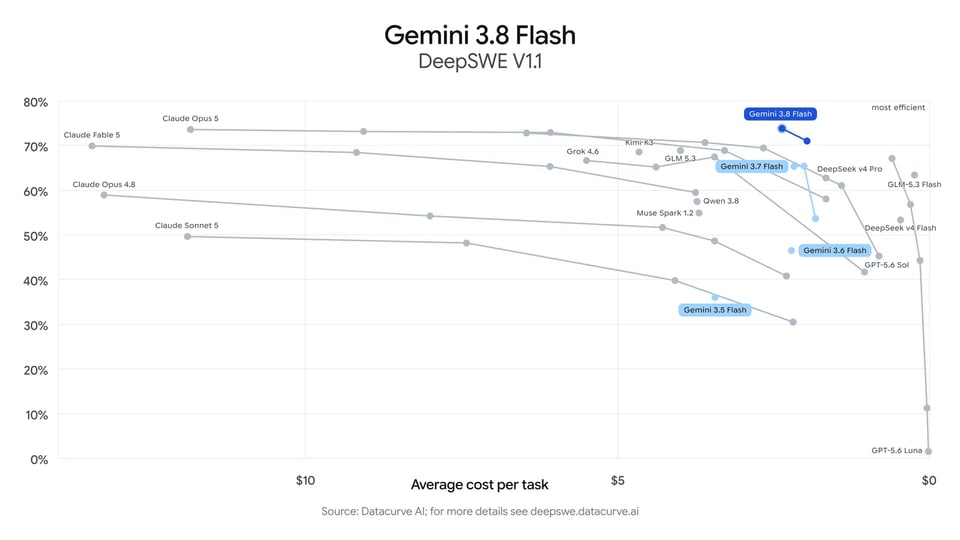
Benchmark de programación de Gemini 3.8 Flash en DeepSWE v1.1
Gemini 3.8 Flash ofrece un potente rendimiento en programación de largo alcance en DeepSWE v1.1, un benchmark centrado en resolver tareas complejas de ingeniería de software de principio a fin. Supera a la mayoría de los modelos de vanguardia de mayor tamaño en esta evaluación, lo que resalta su capacidad para planificar, razonar y ejecutar flujos de trabajo de código extensos.
Benchmark de razonamiento de Gemini 3.8 Flash en HLE-Verified
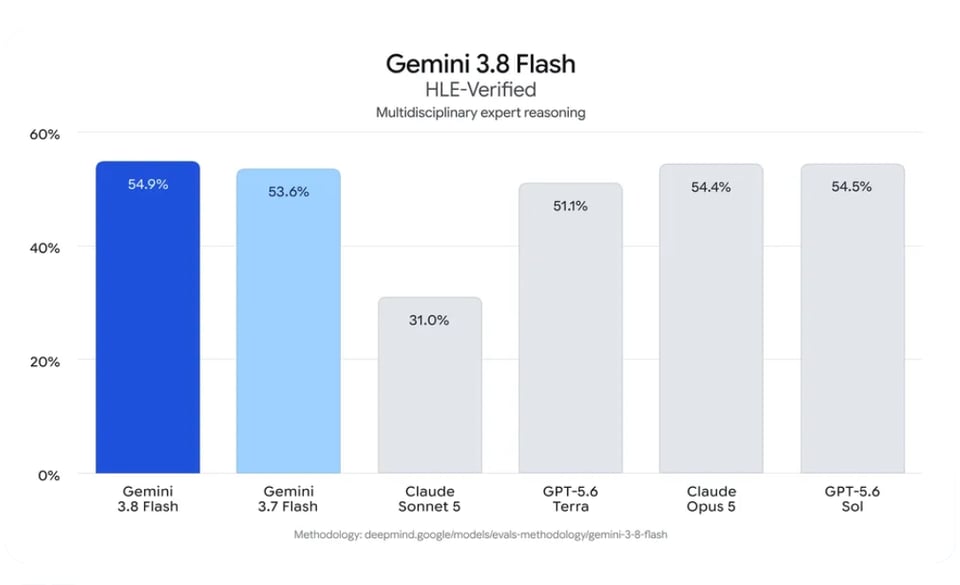
En cuanto a razonamiento avanzado, Gemini 3.8 Flash obtiene un 54,9% en HLE-Verified. Este benchmark evalúa problemas complejos de múltiples pasos en STEM, humanidades y conocimientos profesionales. Este resultado demuestra la mayor capacidad de razonamiento de la API de Gemini 3.8 Flash, especialmente en tareas que requieren un análisis profundo en lugar de respuestas simples.
Benchmark de Gemini 3.8 para IA financiera y legal
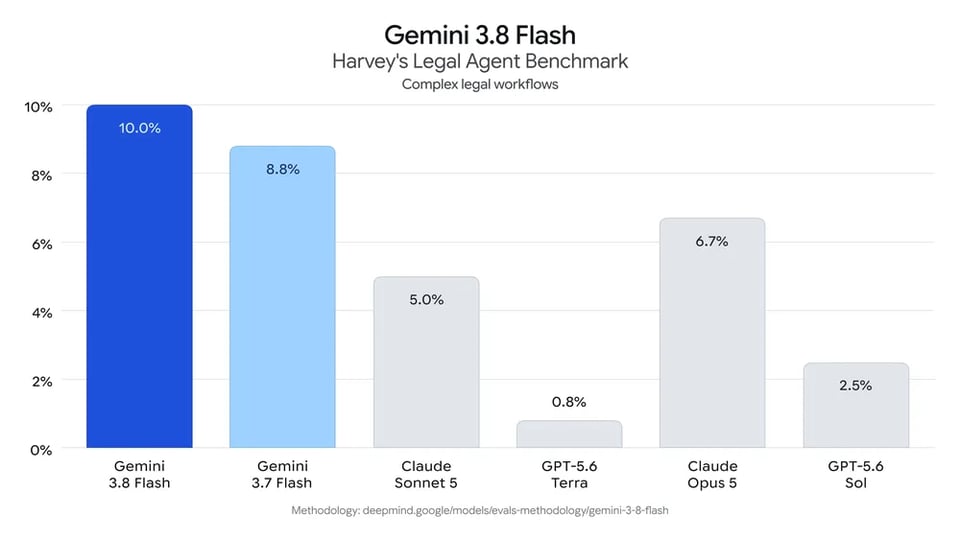
Gemini 3.8 Flash también mejora el rendimiento en los benchmarks de agentes profesionales, tales como Vals Finance Agent V2 y Harvey's Legal Agent Benchmark. Estos resultados del benchmark de Gemini 3.8 muestran un rendimiento superior al de Gemini 3.7 Flash en tareas financieras y legales especializadas, lo que convierte al modelo en una opción ideal para investigación, análisis y flujos de trabajo de IA que requieren un uso intensivo del conocimiento.
Cómo usar la API de Gemini 3.8 Flash en Kie AI
Paso 1: Crea tu cuenta en Kie AI
Paso 2: Prueba Gemini 3.8 Flash gratis en el Playground
Paso 3: Obtén tu clave para la API de Gemini 3.8 Flash
Paso 4: Integra la API de Gemini 3.8 Flash en tu aplicación
Google Gemini 3.8 Flash vs. 3.7 Flash
Gemini 3.8 Flash muestra mejores resultados de rendimiento en tareas de programación, razonamiento y de agentes, mientras que Gemini 3.7 Flash se enfoca en cargas de trabajo eficientes. Ambos modelos están disponibles en Kie AI, por lo que los desarrolladores pueden elegir según las necesidades de su aplicación.
| Capacidad | Gemini 3.8 Flash | Gemini 3.7 Flash |
|---|---|---|
| Typical Workloads | Long-horizon coding, agentic tasks, complex reasoning | Coding, agentic tasks, efficiency-focused workloads |
| DeepSWE v1.1 | 73.7% | 65.3% |
| Vals Finance Agent v2 | 61.4% | 59.0% |
| HLE-Verified | 54.9% | 53.6% |
| OSWorld-2.0 | 59.0% | 50.6% |
| Reasoning Behavior | More reasoning steps on complex tasks | Lower reasoning overhead |
| Tool Use | More iterative tool calling | Efficiency-oriented tool use |
¿Por qué elegir Kie AI para Gemini 3.8 Flash API?
Accede a múltiples APIs de Gemini desde una sola API
Conéctate a la API de Gemini 3.8 Flash y a otros modelos de Gemini mediante una API unificada. Kie AI permite a los desarrolladores probar y cambiar entre distintas APIs de Gemini sin necesidad de reconstruir su integración, facilitando la adaptación de cada modelo a diferentes cargas de trabajo de programación, razonamiento y de agentes.
Prueba Gemini 3.8 Flash gratis con créditos para nuevos usuarios
Explora Gemini 3.8 Flash gratis con los créditos disponibles para nuevos usuarios de Kie AI. Prueba prompts, compara resultados y evalúa la API de Google Gemini 3.8 Flash antes de escalar su uso. Es una forma sencilla de comprobar cómo el modelo se adapta a tu aplicación con un menor coste inicial.
Precios asequibles de la API de Gemini 3.8 Flash
Encuentra el equilibrio entre rendimiento, velocidad y coste con los precios flexibles de Gemini 3.8 Flash API en Kie AI. Elige el nivel de uso que mejor se adapte a tu carga de trabajo y escala a medida que crezca la demanda. Este enfoque flexible ayuda a los desarrolladores a usar Gemini API en prototipos, productos SaaS en crecimiento y aplicaciones de IA en producción sin costes innecesarios.
Integración sencilla de Gemini API con documentación clara
Integra Gemini 3.8 Flash API en tu aplicación con un flujo de trabajo de la API sencillo y documentación clara para desarrolladores. Kie AI te ayuda a pasar de la fase de pruebas a producción mucho más rápido, ya sea que desarrolles un agente de IA, un asistente de programación, una herramienta de automatización o un producto SaaS.
Accede a los modelos más recientes de Google Gemini API
Mantén tu stack de IA preparado para los nuevos lanzamientos. Kie AI amplía continuamente su biblioteca de modelos con las opciones más recientes de Gemini API, facilitando a los desarrolladores el acceso a los nuevos modelos y funciones de Google Gemini mediante la misma integración, en lugar de reconstruir su stack de API para cada actualización.
Soporte para desarrolladores para tu Gemini 3.8 Flash API
Obtén soporte confiable al integrar o escalar Gemini 3.8 Flash API en Kie AI. Desde la configuración de la API y el acceso a los modelos hasta dudas de facturación e integración, nuestro equipo de soporte ayuda a los desarrolladores a resolver problemas y a mantener sus flujos de trabajo con Gemini API funcionando sin interrupciones.
Qué puedes crear con la API de Gemini 3.8 Flash
Crea agentes de programación con Gemini 3.8 Flash API
Crea agentes de programación con IA que generen código, depuren errores, razonen sobre bases de código y gestionen tareas de ingeniería de software de múltiples pasos. La API de Gemini 3.8 Flash es ideal para herramientas de desarrollo que requieren flujos de trabajo de programación más extensos y complejos.
Crea agentes de programación con la API de Gemini 3.8 Flash
Crea agentes de programación con IA que generen código, depuren errores, razonen sobre bases de código y gestionen tareas de ingeniería de software de múltiples pasos. La API de Gemini 3.8 Flash es ideal para herramientas de desarrollo que requieren flujos de trabajo de programación más extensos y complejos.
Crea agentes autónomos con Google Gemini 3.8 Flash
Desarrolla agentes de investigación, asistentes de flujos de trabajo y otros sistemas autónomos con Google Gemini 3.8 Flash. El modelo puede razonar en múltiples pasos y usar herramientas de forma iterativa para planificar, ejecutar, evaluar y continuar tareas complejas.
Desarrolla aplicaciones financieras y legales con la API de Gemini 3.8 Flash
Lleva las capacidades de razonamiento de la API de Gemini 3.8 Flash a las aplicaciones financieras y legales. Crea herramientas para análisis profesional, razonamiento sobre documentos, investigación, generación de informes y otros flujos de trabajo especializados que requieran razonamiento de múltiples pasos.
Impulsa herramientas para desarrolladores y SaaS con la API de Gemini
Integra la API de Gemini en IDEs con IA, asistentes de programación, plataformas de automatización y productos SaaS verticales. Los desarrolladores pueden usar Gemini 3.8 Flash para añadir capacidades de programación, razonamiento y comportamiento de agente a sus aplicaciones existentes.
Crea aplicaciones interactivas con la API de Google Gemini 3.8 Flash
Usa la API de Gemini 3.8 Flash de Google para crear experiencias interactivas, visualizaciones de datos, aplicaciones 3D y otras herramientas generativas. Su capacidad de programación y razonamiento es ideal para respaldar aplicaciones que combinan lógica compleja, datos e interfaces interactivas.