Automatically append previous messages to maintain multi-turn context. May increase token usage.
How can I help you today?
Automatically append previous messages to maintain multi-turn context. May increase token usage.
How can I help you today?
README
Complete guide to using Gemini 4 Neon
Gemini 4 Neon API para programación compleja, análisis y ciencia

curl https://api.kie.ai/gemini-4-neon-openai/v1/chat/completions \-H "Authorization: Bearer $KIE_API_KEY" \-H "Content-Type: application/json" \-d '{"messages": [{ "role": "user", "content": "Analyze the latency vs consistency trade-offs of multi-region consensus." }],"reasoning_effort": "high","stream": false}'
Capacidades clave de Gemini 4 Neon


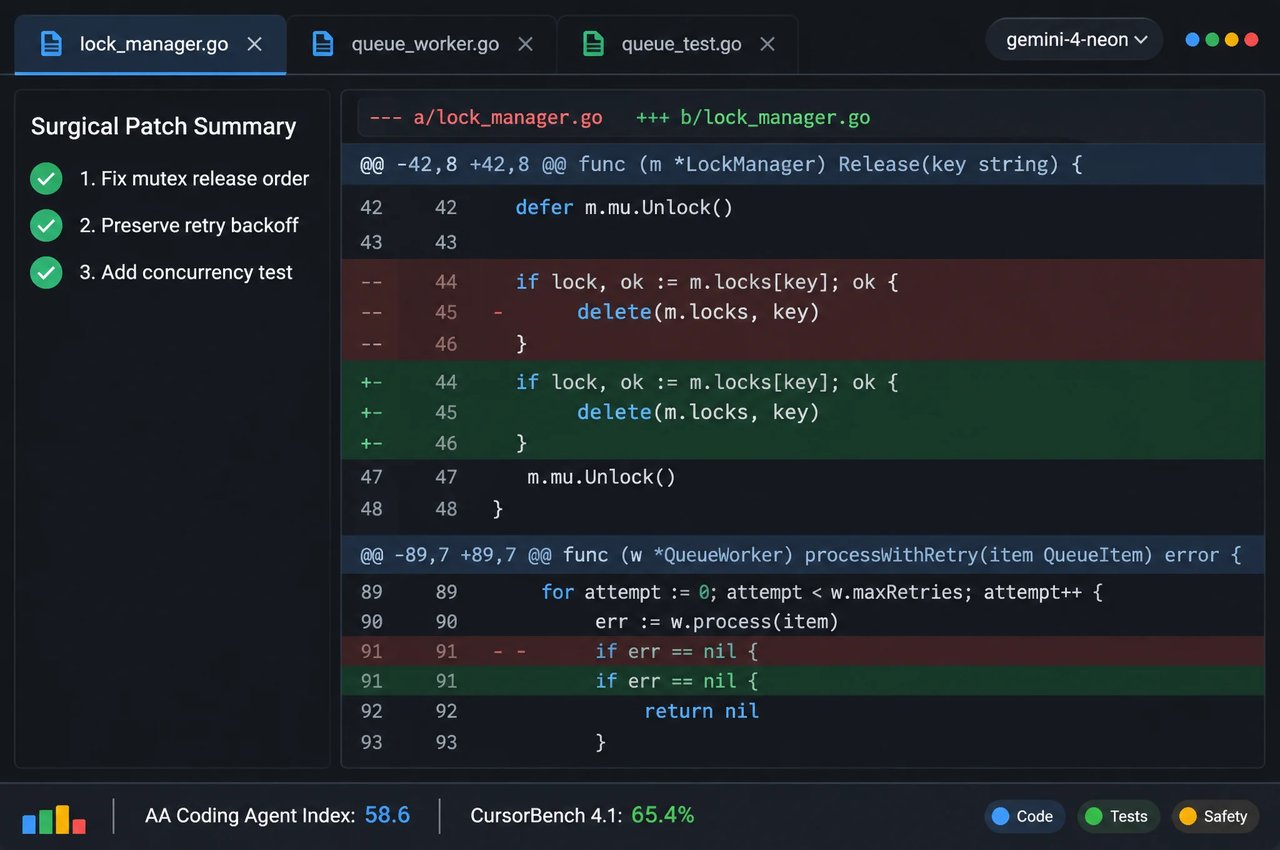
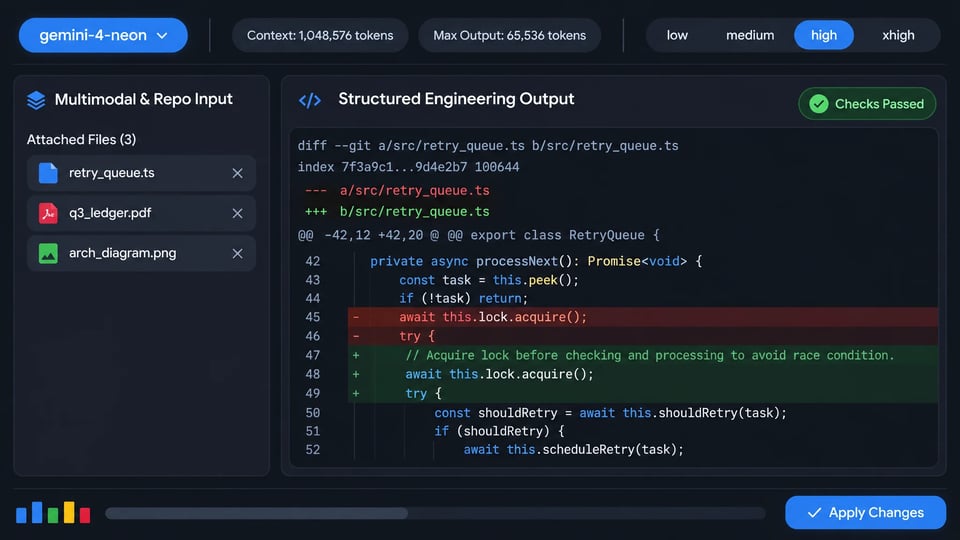
Programación a nivel de repositorio y refactorización multiarchivo

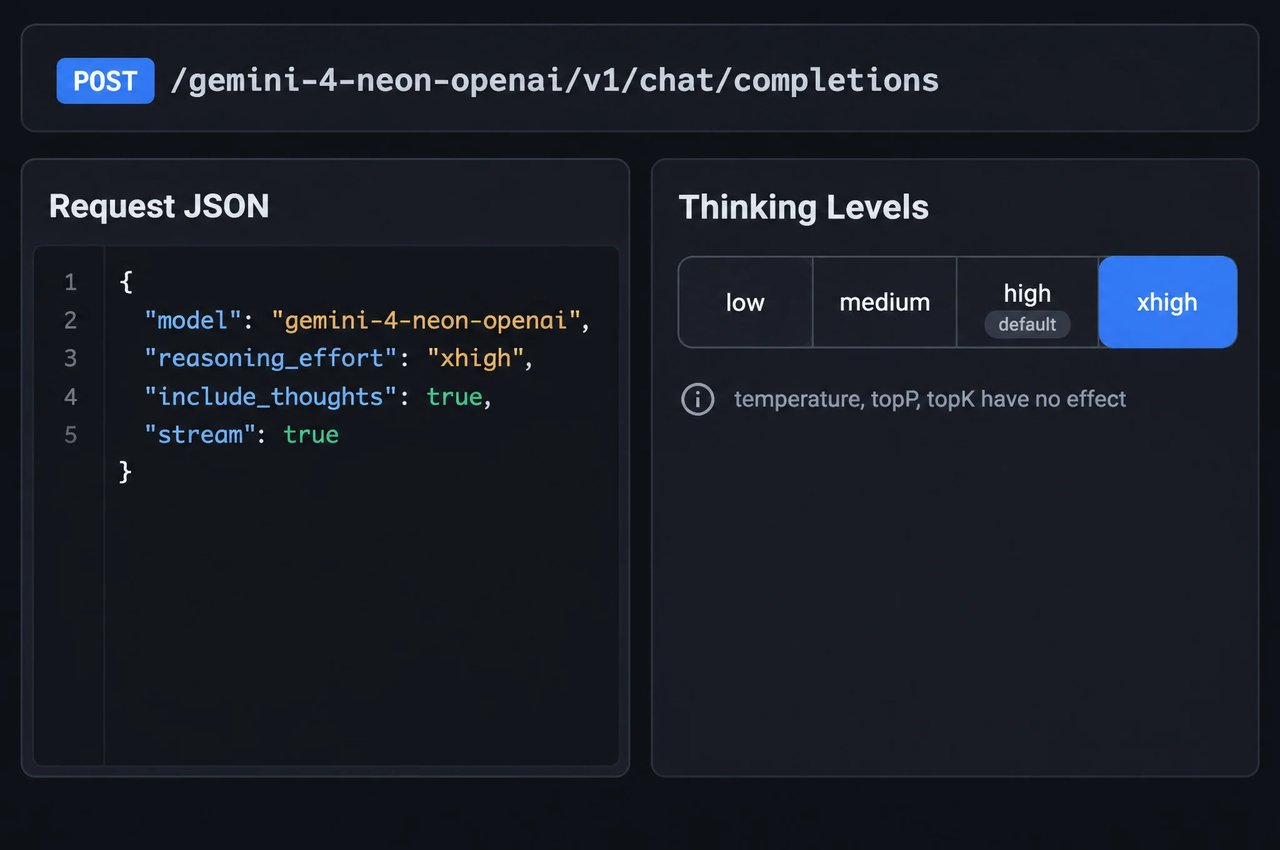
Cuatro niveles de razonamiento de low a xhigh

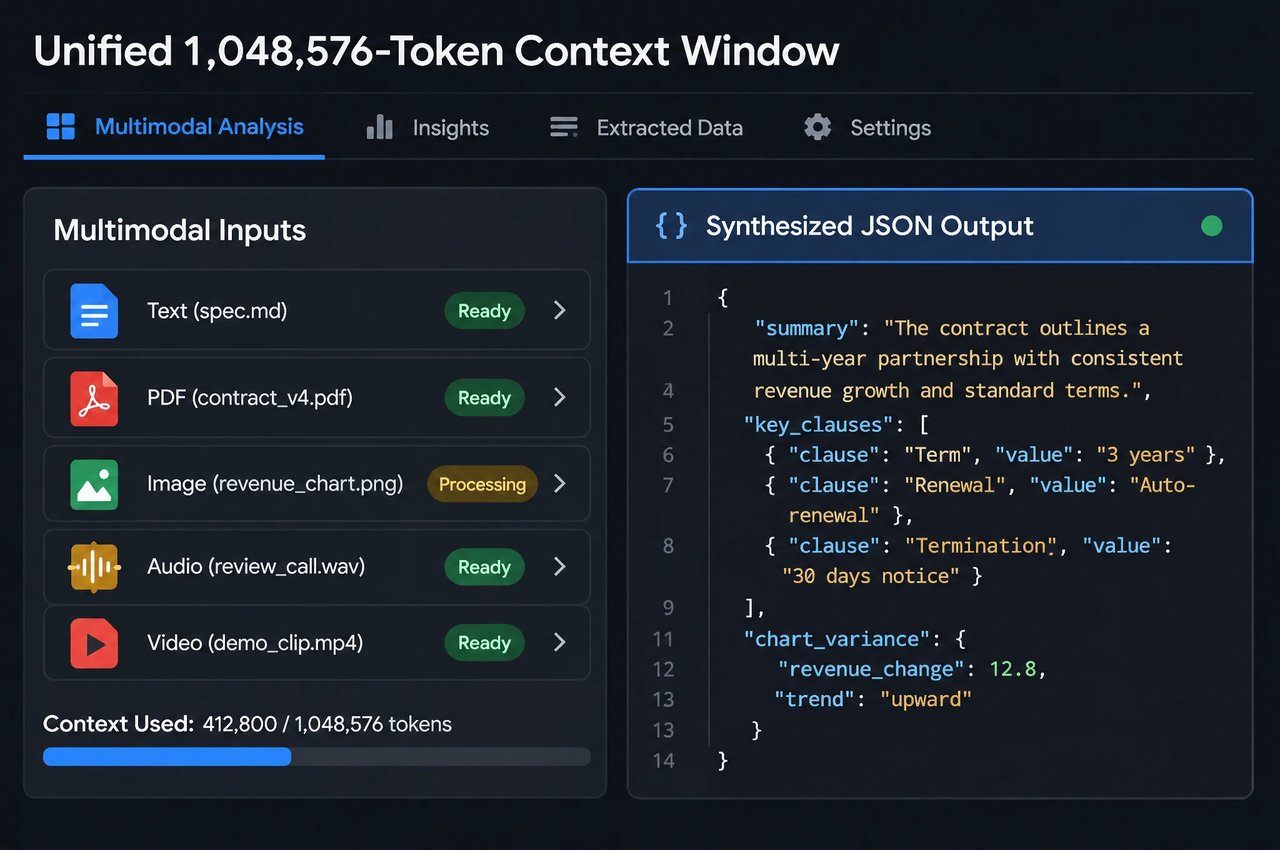
Ventana de contexto multimodal unificada de 1M de tokens

Flujos de trabajo analíticos, legales y científicos

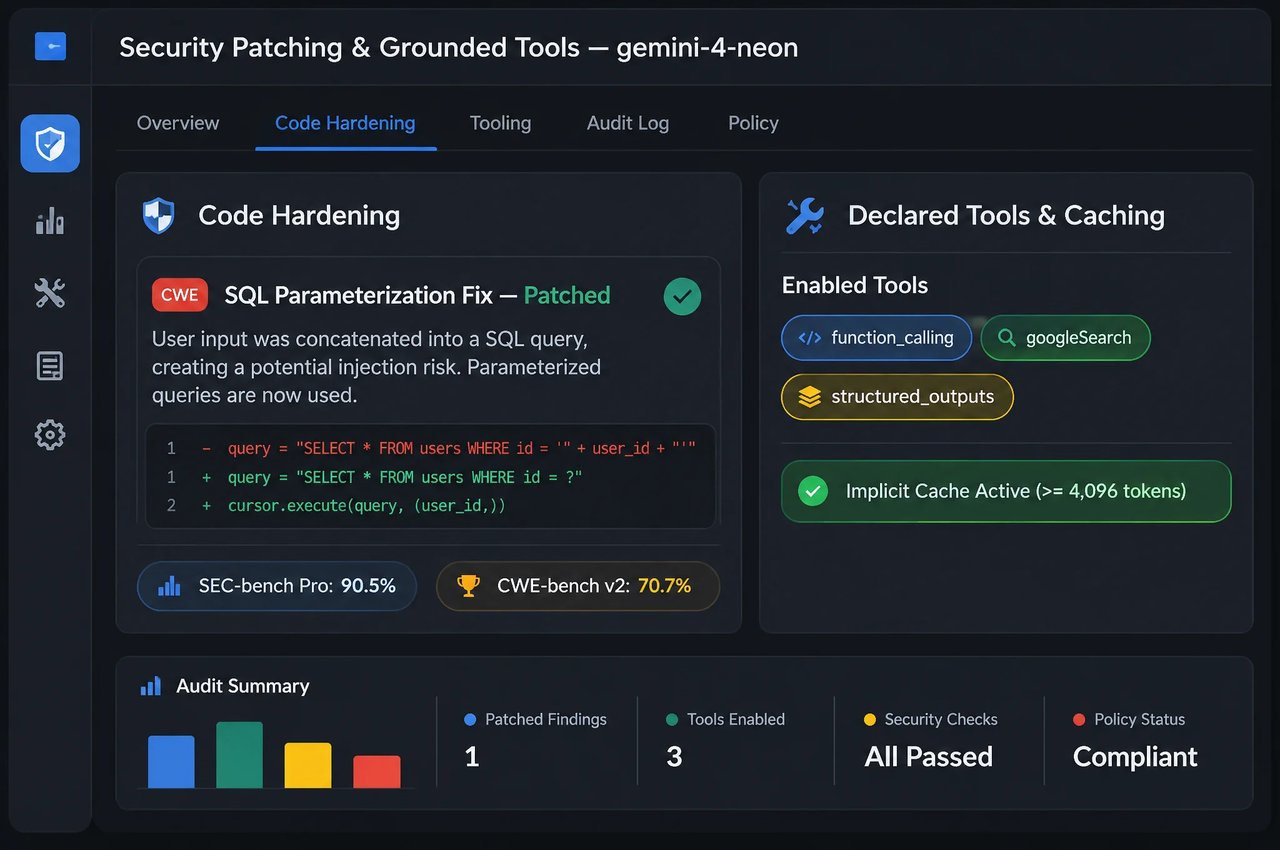
Generación de código segura, grounding y herramientas
Especificaciones de Gemini 4 Neon
Especificaciones del modelo y parámetros de la API de Kie.ai para Gemini 4 Neon según la ficha de modelo de Google y la documentación de la API de Kie.ai.
| Specification | Gemini 4 Neon |
|---|---|
| Developer | Google (Google DeepMind) |
| IDs de modelo en Kie.ai | gemini-4-neon-openai (compatible con OpenAI); gemini-4-neon (Gemini nativo) |
| Fecha de lanzamiento | 18 de noviembre de 2026 |
| Adaptado de | Gemini 4 Carbon |
| Modalities | Entrada de texto, imagen, video, audio y PDF (hasta 10 archivos por solicitud); salida de texto |
| Ventana de contexto | 1 048 576 tokens unificados entre entrada, razonamiento y salida |
| Máximo de tokens de salida | Hasta 65 536 tokens por respuesta síncrona por defecto (los tokens de razonamiento cuentan para la salida) |
| Niveles de razonamiento | low, medium, high (por defecto), xhigh mediante reasoning_effort o thinkingLevel (minimal ignorado; include_thoughts / includeThoughts opcionales) |
| Formatos de API en Kie.ai | POST /gemini-4-neon-openai/v1/chat/completions (stream default false); POST /gemini/v1/models/gemini-4-neon:streamGenerateContent (stream default true) |
| Herramientas y parámetros en Kie.ai | Grounding con Google Search (googleSearch), herramientas de funciones, response_format con esquema JSON (compatible con OpenAI), caché implícita (temperature, topP y topK no tienen efecto; solo solicitudes de chat) |
| Fecha límite de conocimiento | Marzo de 2026 |
Resultados de benchmarks de Gemini 4 Neon
Resultados de evaluación reportados por Google en su anuncio de lanzamiento del 18 de noviembre de 2026 y en la ficha de modelo de DeepMind.
| Benchmark | Gemini 4 Neon | Qué mide |
|---|---|---|
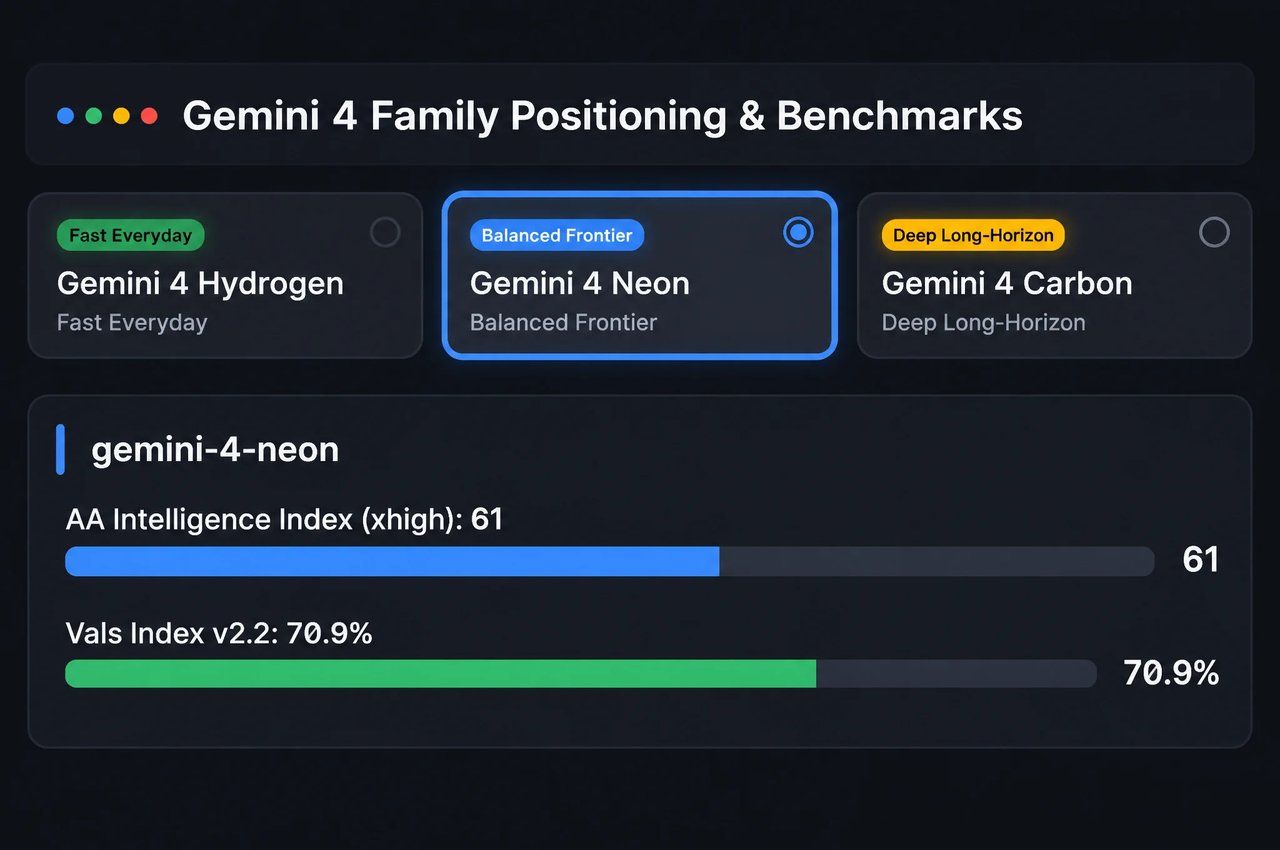
| AA Intelligence Index v5.0.1 | 61 (#3 en general, en xhigh) | Índice de capacidad general |
| Vals Index v2.2 | 70.9% (#2 en general; #1 en Legal Research y Tax Agent) | Evaluaciones empresariales, legales y fiscales |
| AA Coding Agent Index | 58.6 (#1 en general) | Evaluación de capacidad de ingeniería de software |
| CursorBench 4.1 / Terminal-Bench 4.1 | 65.4% / 65.2% (ajustado por trampas) | Programación en repositorios y ejecución en terminal |
| FrontierCode 2.0 / SWE-sweep | 46.2% (en high) / 39.0% (entorno de evaluación Antigravity), 12.8% (mini-SWE) | Benchmarks de ingeniería de software |
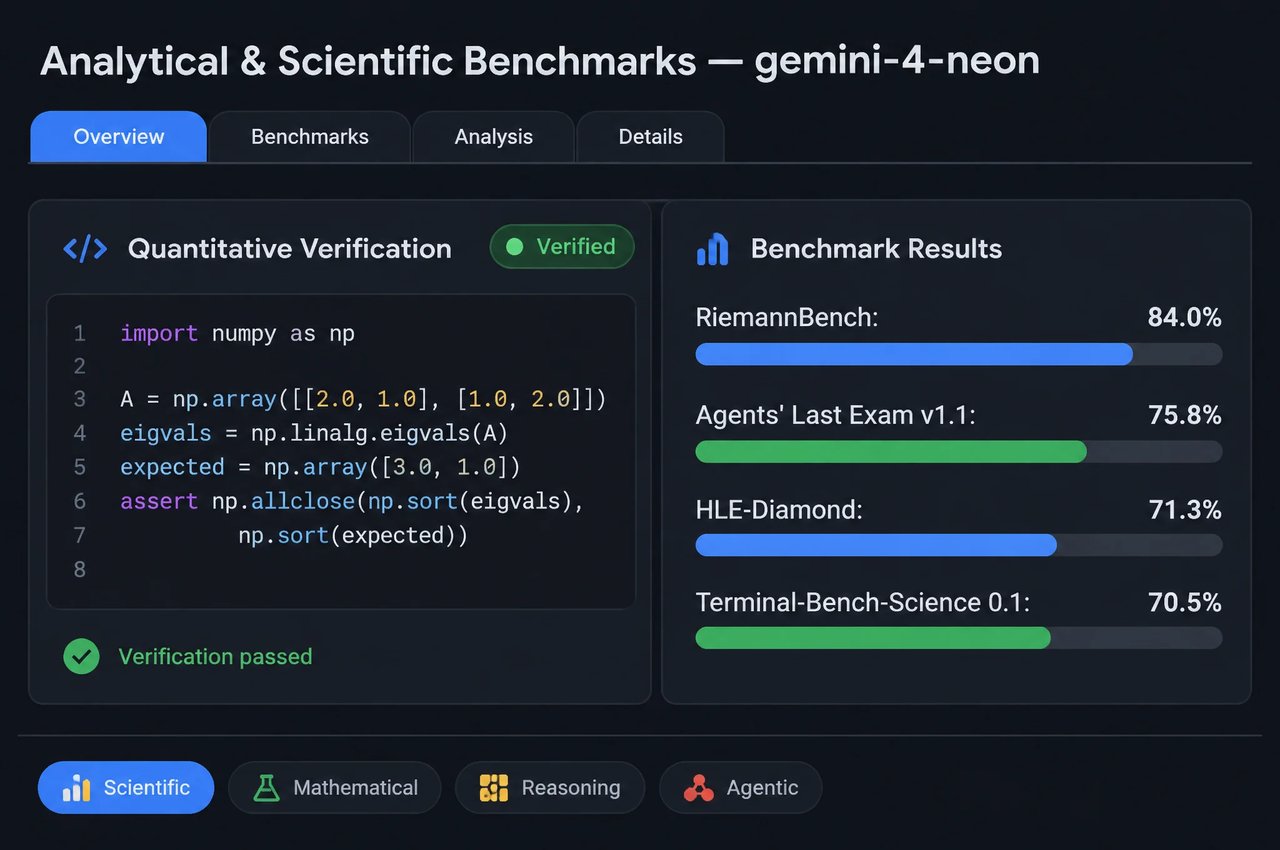
| Agents' Last Exam v1.1 / AutomationBench | 75.8% / 56.3% (#1 en general) | Trabajo intelectual en varios pasos y automatización de flujos de trabajo |
| RiemannBench / HLE-Diamond / Terminal-Bench-Science 0.1 | 84.0% / 71.3% / 70.5% | Razonamiento matemático y científico |
| GraphWalks (256K a 1M, BFS F1) | 95.2% | Recuperación y razonamiento en contexto largo |
| LVBench / Chartography / MKA | 89.0% / 73.5% / 56.5% | Video largo, gráficos densos y razonamiento multimodal |
| SEC-bench Pro, CWE-bench v2 y WebExploitBench v1.2 | 90.5% / 70.7% / 51.3% | Detección de vulnerabilidades, aplicación de parches y seguridad web |
Cómo trabajar con Gemini 4 Neon
- 1
Paso 1: Elige entre Hydrogen, Neon y Carbon
Usa Gemini 4 Neon para flujos de trabajo complejos de ingeniería de software, razonamiento analítico y ciencia en los que busques profundidad de razonamiento de vanguardia con una finalización eficiente de tareas de principio a fin. Deja Gemini 4 Hydrogen para la programación y ejecución rápidas del día a día, y reserva Gemini 4 Carbon para los proyectos de largo horizonte más difíciles. - 2
Paso 2: Empieza en high y reserva xhigh para problemas difíciles
High es el nivel de pensamiento predeterminado en Kie.ai. Configura reasoning_effort (compatible con OpenAI) o generationConfig.thinkingConfig.thinkingLevel (nativo) en medium o low para un consumo de tokens más ajustado en instrucciones más sencillas, o en xhigh para problemas difíciles de varios pasos de ingeniería, análisis y ciencia. Deja temperature, topP y topK sin configurar, ya que no tienen efecto en Gemini 4. - 3
Paso 3: Deja margen para los tokens de pensamiento y de salida
Los tokens de entrada, pensamiento y salida comparten la ventana de 1 048 576 tokens, y el presupuesto de salida predeterminado de 65 536 tokens cubre tanto el pensamiento como el texto visible de la respuesta. En tareas difíciles con xhigh, recuerda que un pensamiento más profundo consume una mayor parte de ese presupuesto de salida compartido, y pasa hasta 10 archivos multimedia por solicitud. - 4
Paso 4: Usa fundamentación, herramientas de funciones y caché de prefijos
Activa googleSearch cuando una pregunta requiera datos web posteriores a marzo de 2026, declara herramientas de funciones personalizadas en cualquiera de los puntos de conexión o pasa un esquema JSON en response_format en el punto de conexión compatible con OpenAI. Mantén sin cambios los prefijos de instrucciones compartidos entre turnos para que el contexto repetido pueda acogerse a la tarifa de entrada en caché.