Gemini 4 Hydrogen
gemini-4-hydrogen-openai

Google describe a Gemini 4 Hydrogen como un modelo rápido y eficiente para la programación diaria. Está adaptado a partir de Gemini 4 Carbon y sucede a Gemini 3.8 Flash. En Kie.ai actualmente solo admite solicitudes de chat.

Model Type:
Pricing: Input 120 credits / 1M tokens (≈ $0.60), Output 600 credits / 1M tokens (≈ $3.00) — both 60% below official pricing. High-tier top-ups come with bonus credits that lower the effective price by about 10%.

Automatically append previous messages to maintain multi-turn context. May increase token usage.

Function calling
Grounding with Google Search
Source:Google Search
Thinking process
Reasoning effort
Stream Response

How can I help you today?

README

Complete guide to using Gemini 4 Hydrogen

Gemini 4 Hydrogen API para programación rápida y tareas diarias

Gemini 4 Hydrogen lee texto, imágenes, vídeo, audio y PDF y responde en texto. La entrada y la salida comparten una ventana de contexto de hasta 1M de tokens, y cuatro niveles de pensamiento, de low a xhigh, te permiten equilibrar la profundidad de razonamiento y la velocidad.
Gemini 4 Hydrogen API para programación rápida y tareas diarias

Capacidades principales de Gemini 4 Hydrogen

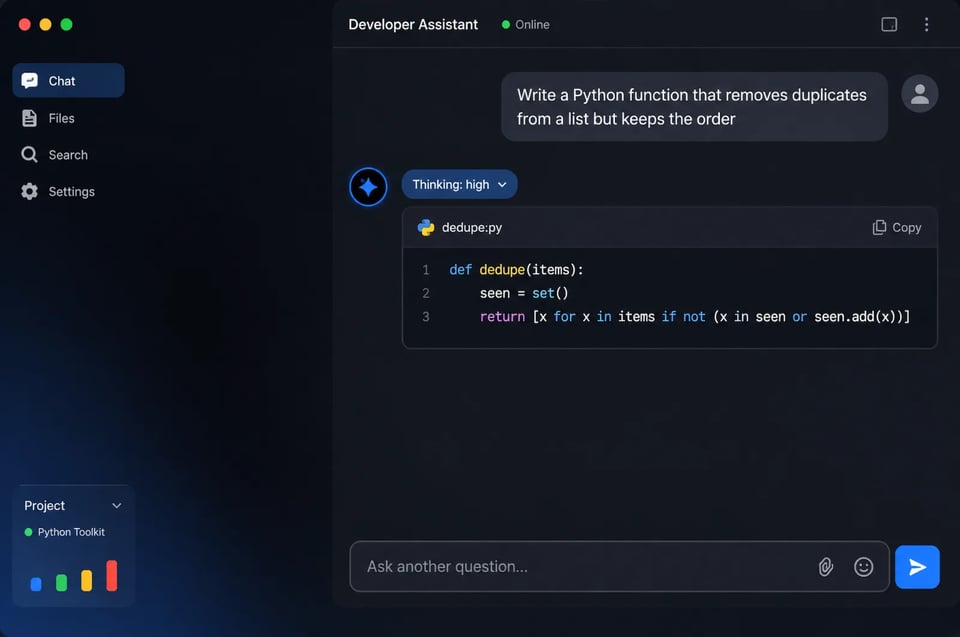
Google posiciona Hydrogen para una ejecución rápida en tareas cotidianas, como escribir y corregir código, responder preguntas sobre entradas extensas y resumir documentos, mientras que Gemini 4 Carbon y Argon se encargan del razonamiento profundo y a largo plazo.
El modelo rápido de la familia Gemini 4
01

El modelo rápido de la familia Gemini 4

Google posiciona Hydrogen como el modelo rápido de la familia Gemini 4, diseñado para una ejecución ágil. En el Artificial Analysis Intelligence Index alcanza 51 puntos con su nivel de pensamiento high predeterminado, frente a los 50 de Gemini 4 Argon.
Cuatro niveles de pensamiento hasta Xhigh
02

Cuatro niveles de pensamiento hasta Xhigh

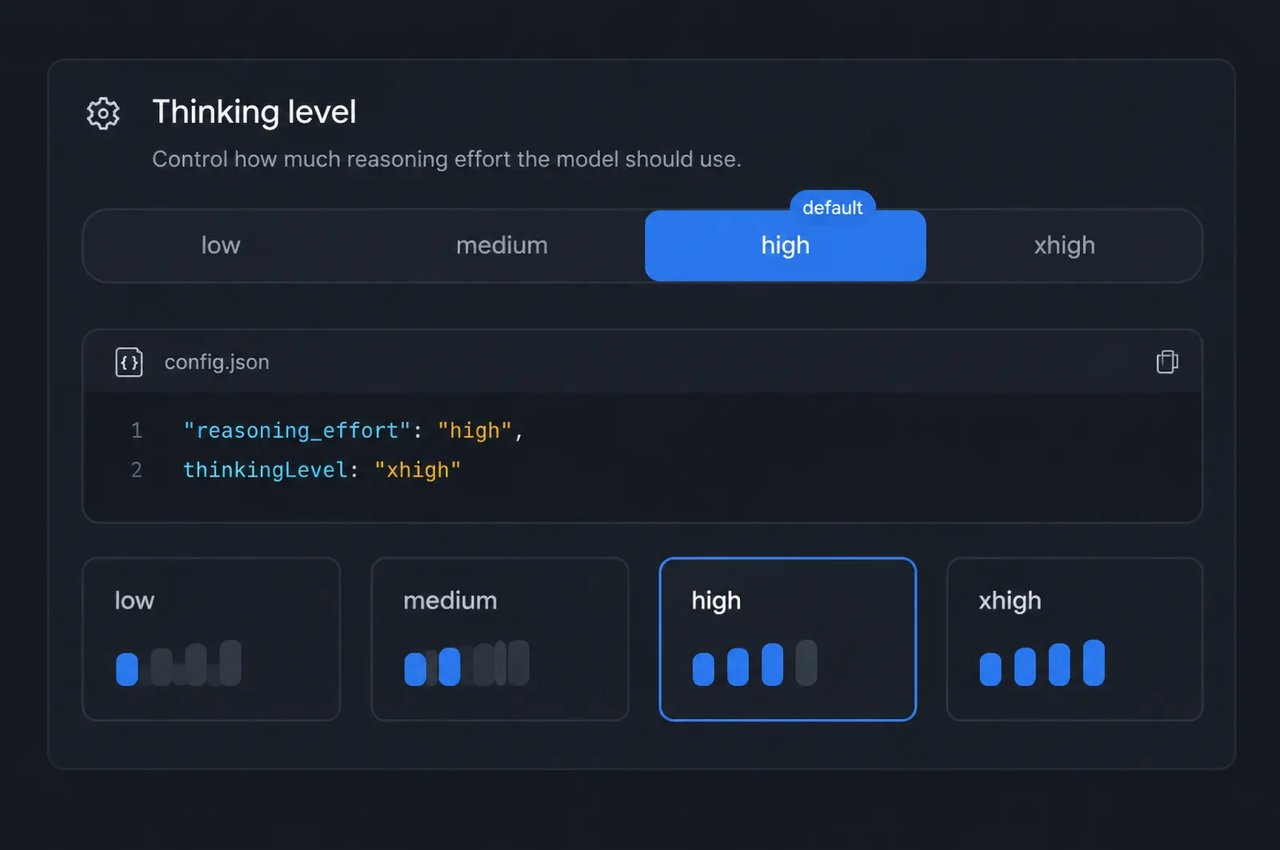
Los niveles low, medium, high y xhigh equilibran la calidad de respuesta frente a la latencia y el consumo de tokens. High es el valor predeterminado. Xhigh se estrena con Hydrogen y alcanzó 54 puntos en el Artificial Analysis Intelligence Index según los resultados de Google. En Kie.ai, configura reasoning_effort o thinkingLevel.
Ventana de contexto de hasta 1M de tokens
03

Ventana de contexto de hasta 1M de tokens

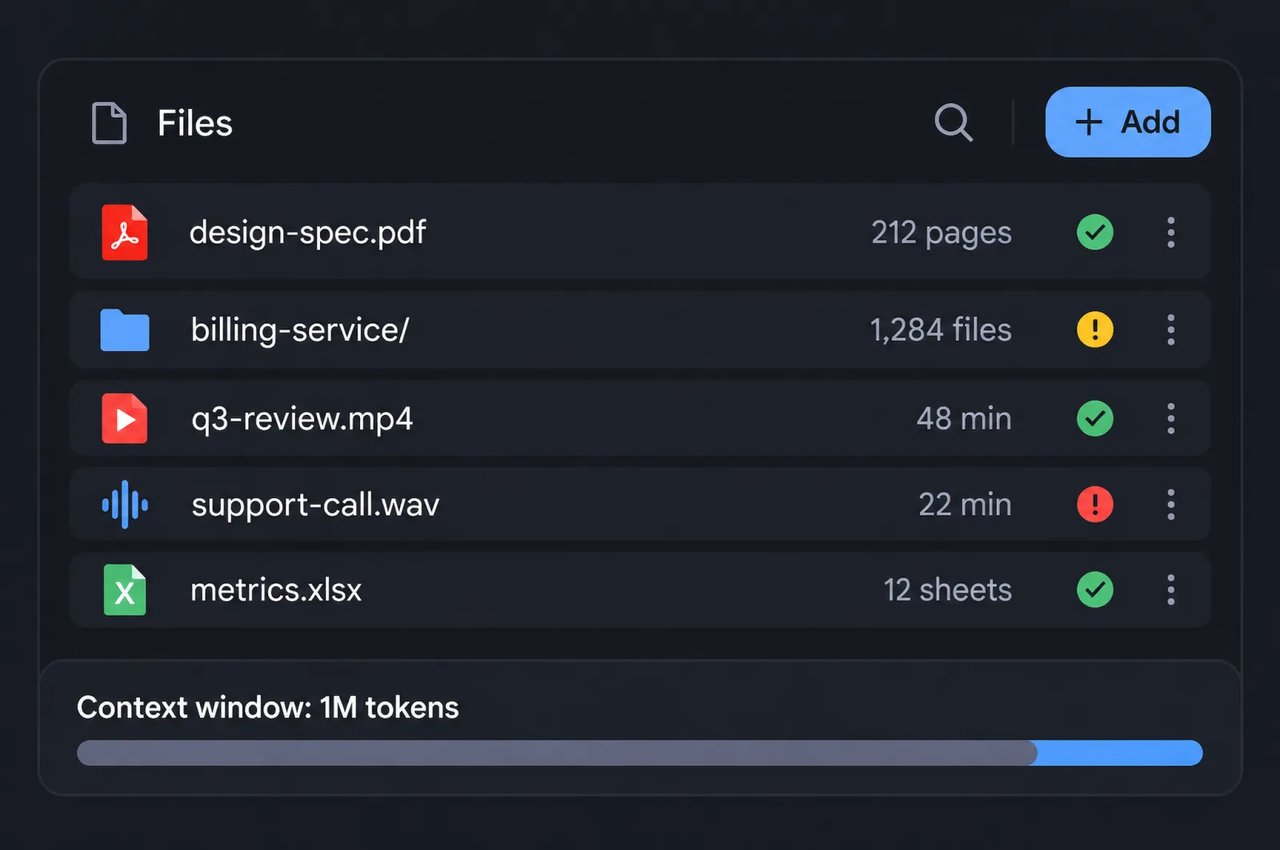
La entrada y la salida comparten una ventana de contexto de hasta 1M de tokens, por lo que una sola solicitud puede incluir documentos extensos o grandes partes de una base de código. La ficha del modelo de Google indica hasta 64K tokens de salida por respuesta síncrona de forma predeterminada.
Programación y depuración cotidianas
04

Programación y depuración cotidianas

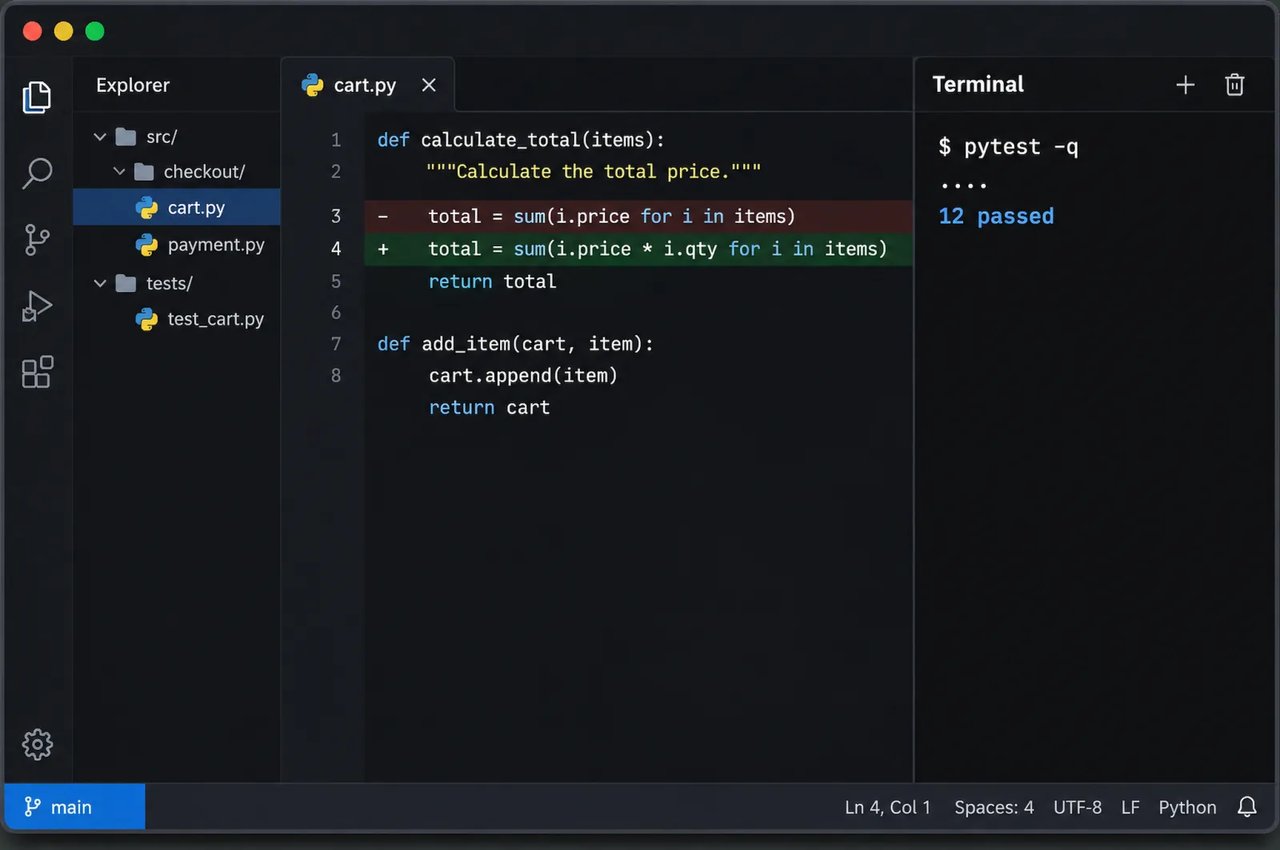
Google informa que Hydrogen realiza ediciones precisas para la resolución de problemas, la depuración y las consultas sobre la base de código sin reescribir archivos no relacionados. Obtiene un 57% en Terminal-Bench 4.1, frente al 18.2% de Gemini 3.8 Flash.
Entrada de texto, imagen, vídeo, audio y PDF
05

Entrada de texto, imagen, vídeo, audio y PDF

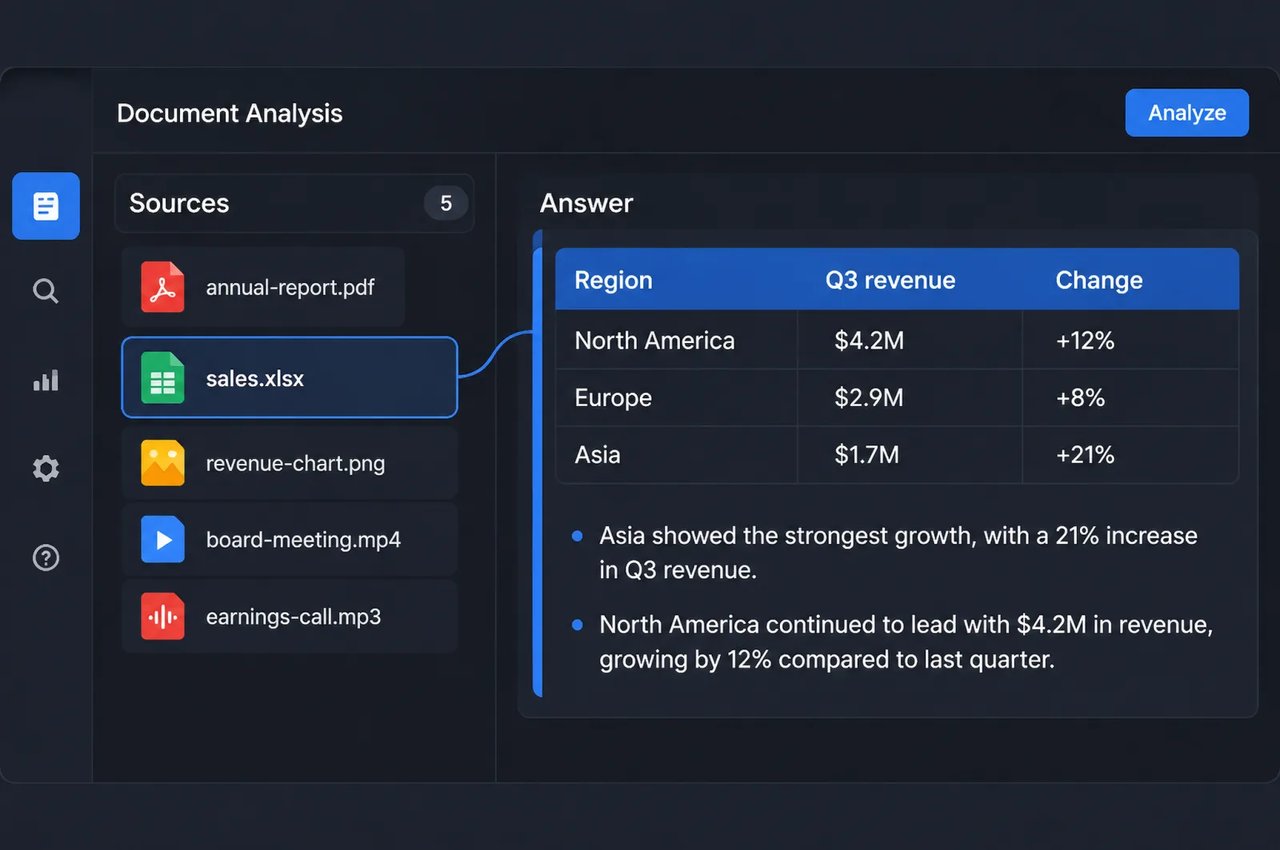
Hydrogen acepta texto, imágenes, vídeo, audio y PDF y responde en texto. Úsalo para convertir documentos densos, gráficos, hojas de cálculo y reuniones grabadas en respuestas estructuradas.
Fundamentación con Google Search
06

Fundamentación con Google Search

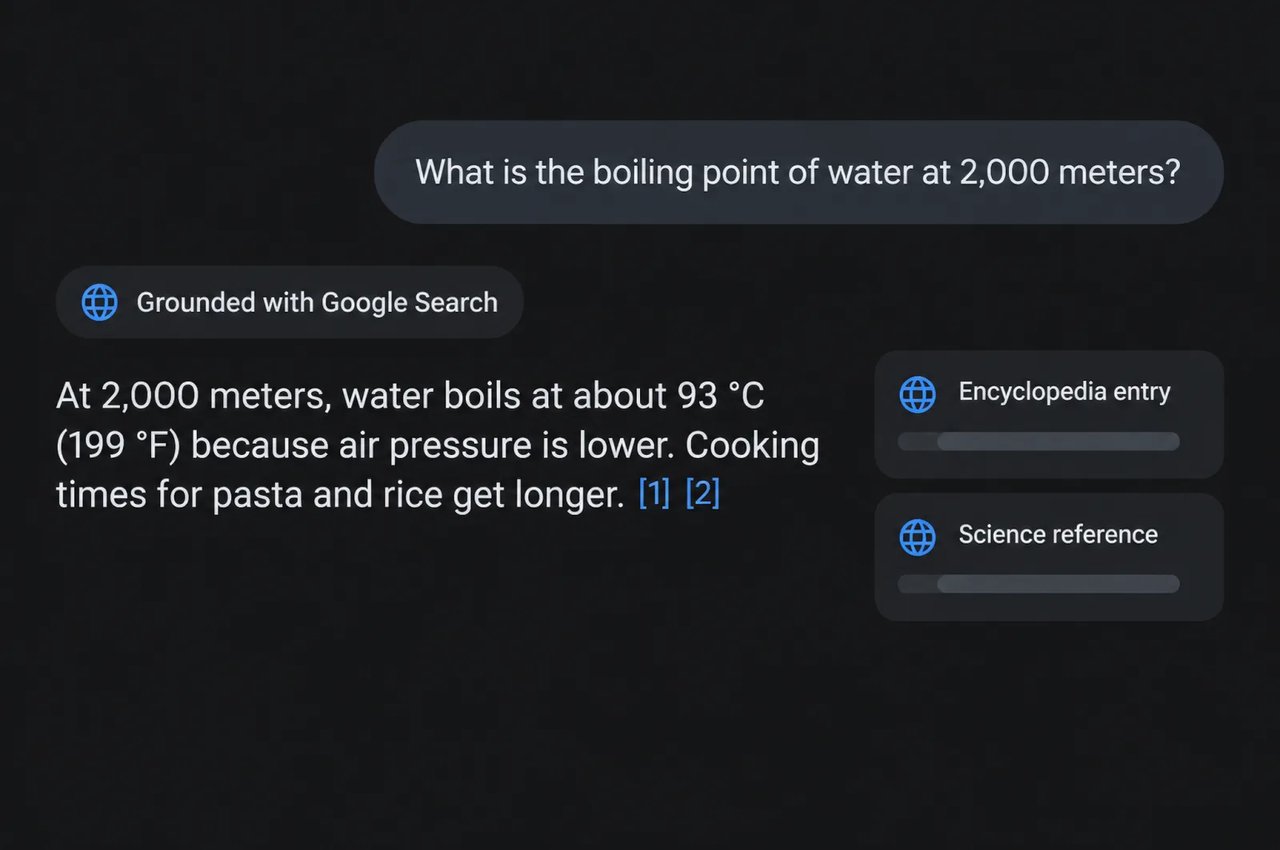
Añade googleSearch a la solicitud para que el modelo fundamente su respuesta en resultados en tiempo real de Google Search, incluyendo las fuentes. Ambos formatos de API en Kie.ai también aceptan declaraciones de funciones.
SpecificationGemini 4 Hydrogen
DeveloperGoogle
Adaptado deGemini 4 Carbon
InputTexto, imagen, vídeo, audio, PDF
OutputText
Ventana de contextoHasta 1M de tokens, entrada y salida combinadas
Límite de salidaHasta 64K tokens por respuesta síncrona de forma predeterminada (ficha del modelo de Google)
Niveles de pensamientoLow, medium, high (predeterminado), xhigh; reasoning_effort o thinkingLevel en Kie.ai
ToolsFundamentación con Google Search, declaraciones de funciones
Formatos de API en Kie.aiChat completions compatibles con OpenAI; streamGenerateContent nativo de Gemini
StreamingOpcional en la API compatible con OpenAI (stream: true); activado de forma predeterminada en la API nativa
Fecha de corte de conocimientoMarzo de 2026
BenchmarkGemini 4 Hydrogen
SWE-sweep13.5%
Terminal-Bench 4.1 (ajustado por trampas)57.0%
Agents' Last Exam v1.171.6%
AutomationBench-AA76.1%
Vending-Bench 2 (saldo bancario)$14,549
OSWorld-2.1 (subconjunto sin conexión)77.6%
MKA (Agente de conocimiento multimodal)53.4%
Chartography66.6%
Terminal-Bench-Science 0.151.4%
HLE-Diamond58.8%

Cómo trabajar con Gemini 4 Hydrogen

Cuatro decisiones determinan la velocidad, la calidad y el consumo de tokens.
  1. 1

    Paso 1: Elige el modelo adecuado para la tarea

    Usa Hydrogen para programación diaria, análisis y chat. Google posiciona Gemini 4 Carbon y Gemini 4 Argon como modelos de razonamiento profundo y a largo plazo para los problemas más complejos.
  2. 2

    Paso 2: Empieza en el nivel alto predeterminado

    El nivel de pensamiento predeterminado es alto (high). Los niveles superiores permiten un razonamiento más profundo, pero pueden tardar más y consumir más tokens; baja a medium o low para prompts sencillos y usa xhigh solo cuando el razonamiento adicional valga la pena.
  3. 3

    Paso 3: Deja espacio para la respuesta

    Google señala que el modelo puede consumir más tokens en los niveles de pensamiento más altos. Mantén los prompts concisos y, en preguntas difíciles, deja margen para la respuesta final dentro del límite de salida.
  4. 4

    Paso 4: Recibe las respuestas largas en streaming

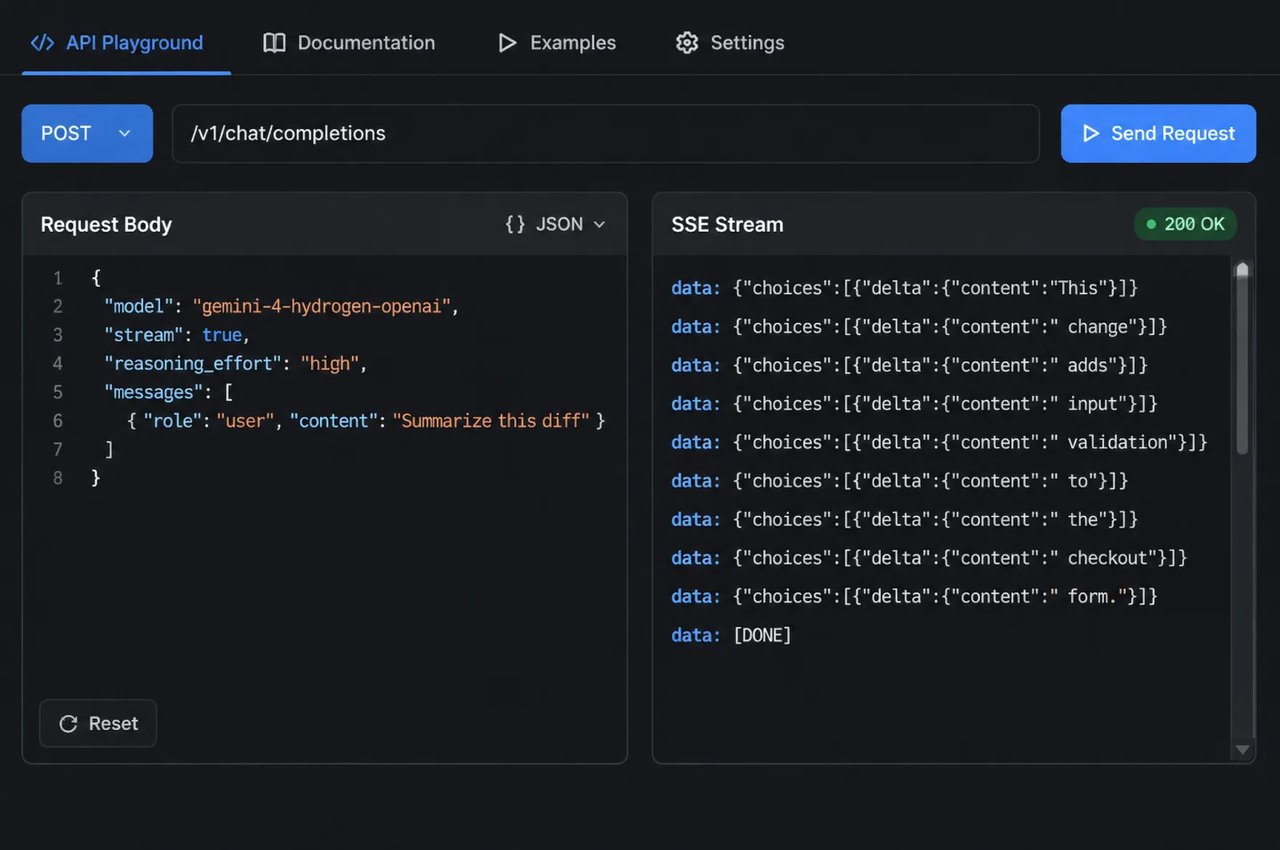
    En la API compatible con OpenAI, establece stream en true para recibir la respuesta como eventos enviados por el servidor; el endpoint nativo transmite en tiempo real de forma predeterminada. Con la transmisión activada, el último fragmento incluye los datos de uso y credits_consumed.

Qué puedes construir con Gemini 4 Hydrogen

Google posiciona Hydrogen para la programación diaria y la ejecución rápida. En Kie.ai, el modelo actualmente solo admite solicitudes de chat, por lo que los usos siguientes son tareas que ejecutas mediante chat.

Ayuda de programación y revisión de código

Pide correcciones de errores, pequeñas refactorizaciones, casos de prueba y explicaciones de código desconocido, con ediciones precisas en lugar de reescrituras completas.

Preguntas sobre documentos y datos

Resume archivos PDF largos, compara hojas de cálculo y extrae cifras clave de gráficos, con respuestas en el formato que pidas.

Respuestas fundamentadas en búsquedas

Activa la fundamentación con Google Search para preguntas sobre lanzamientos recientes, precios o noticias, y obtén las fuentes junto con la respuesta.

Redacción y trabajo diario

Redacta correos electrónicos, guías de estudio y reescrituras con el tono y el formato que prefieras, siguiendo tus pautas.

Gemini 4 Hydrogen en Kie.ai

01

Inicio rápido de Gemini 4 Hydrogen API

Envía una solicitud POST a https://api.kie.ai/gemini-4-hydrogen-openai/v1/chat/completions con tus mensajes, o usa el formato nativo de Gemini en https://api.kie.ai/gemini/v1/models/gemini-4-hydrogen:streamGenerateContent, con el encabezado Authorization: Bearer YOUR_API_KEY. Establece reasoning_effort o thinkingLevel en low, medium, high o xhigh. En Kie.ai, el modelo actualmente solo admite solicitudes de chat y aún no se ha adaptado para el uso con agentes. Conectarlo a un agente puede provocar errores en las solicitudes o resultados inesperados.
03

Una sola clave en todo el mercado de Kie.ai

Todos los modelos del mercado de Kie.ai usan el mismo método de autenticación: un encabezado Authorization: Bearer YOUR_API_KEY con la clave de tu página de gestión de API keys de Kie.ai.
04

Un único saldo de créditos

Tu cuenta tiene un único saldo de créditos que comparten todos los servicios de generación, y puedes consultarlo con la API para obtener créditos restantes.

Preguntas frecuentes

¿Qué tipo de modelo es Gemini 4 Hydrogen?

Gemini 4 Hydrogen es el modelo rápido de Google dentro de la familia Gemini 4, adaptado a partir de Gemini 4 Carbon y lanzado el 12 de noviembre de 2026. Sucede a Gemini 3.8 Flash para la programación diaria y la ejecución rápida. En Kie.ai actualmente solo admite solicitudes de chat.

¿En qué se diferencia Gemini 4 Hydrogen de Gemini 4 Carbon?

Google posiciona a Carbon y Argon como sus modelos de frontera para el razonamiento profundo y a largo plazo en los problemas más complejos, y a Hydrogen para la ejecución rápida. Google informa que Hydrogen suele completar tareas más rápido que los modelos de su clase y que obtiene una puntuación de 51 en el Artificial Analysis Intelligence Index en su nivel alto predeterminado, frente a 50 de Gemini 4 Argon.

¿Qué tamaño tiene la ventana de contexto de Gemini 4 Hydrogen?

Hasta 1M de tokens, sumando entrada y salida. La ficha del modelo de Google indica hasta 64K tokens de salida por respuesta síncrona de forma predeterminada.

¿Qué entradas acepta Gemini 4 Hydrogen?

Texto, imágenes, vídeo, audio y archivos PDF. Responde en texto.

¿Cuáles son los niveles de pensamiento en Gemini 4 Hydrogen?

Hay cuatro: low (bajo), medium (medio), high (alto) y xhigh (muy alto). El valor predeterminado es high. Google indica que los niveles escalan en una progresión gradual, por lo que solo esperas y pagas por la profundidad de razonamiento que necesita una tarea; xhigh es nuevo con Hydrogen. En Kie.ai, configura reasoning_effort en la API compatible con OpenAI o thinkingLevel en la API nativa.

¿Puede Gemini 4 Hydrogen buscar en la web?

Sí. Añade googleSearch a las herramientas y la respuesta se fundamentará en resultados en tiempo real de Google Search, con fuentes.

¿Cuál es la fecha límite de conocimiento de Gemini 4 Hydrogen?

Google indica marzo de 2026 como la fecha límite de conocimiento del modelo. Usa la fundamentación con Google Search para obtener información más reciente.

¿Cómo llamo a la Gemini 4 Hydrogen API en Kie.ai?

Crea una clave en la página de gestión de API keys de Kie.ai y envíala en un encabezado Authorization: Bearer YOUR_API_KEY. Envía una solicitud POST a /gemini-4-hydrogen-openai/v1/chat/completions para el formato compatible con OpenAI o a /gemini/v1/models/gemini-4-hydrogen:streamGenerateContent para el formato nativo; con transmisión por secuencias, el último fragmento incluye los datos de uso y credits_consumed. Actualmente, el modelo solo admite solicitudes de chat y aún no se ha adaptado para el uso con agentes. Conectarlo a un agente puede provocar errores en las solicitudes o resultados inesperados. Consulta la documentación de la API.