Automatically append previous messages to maintain multi-turn context. May increase token usage.
How can I help you today?
README
Complete guide to using deepseek-v4-1-flash
API de DeepSeek V4.1 Flash para chat multimodal
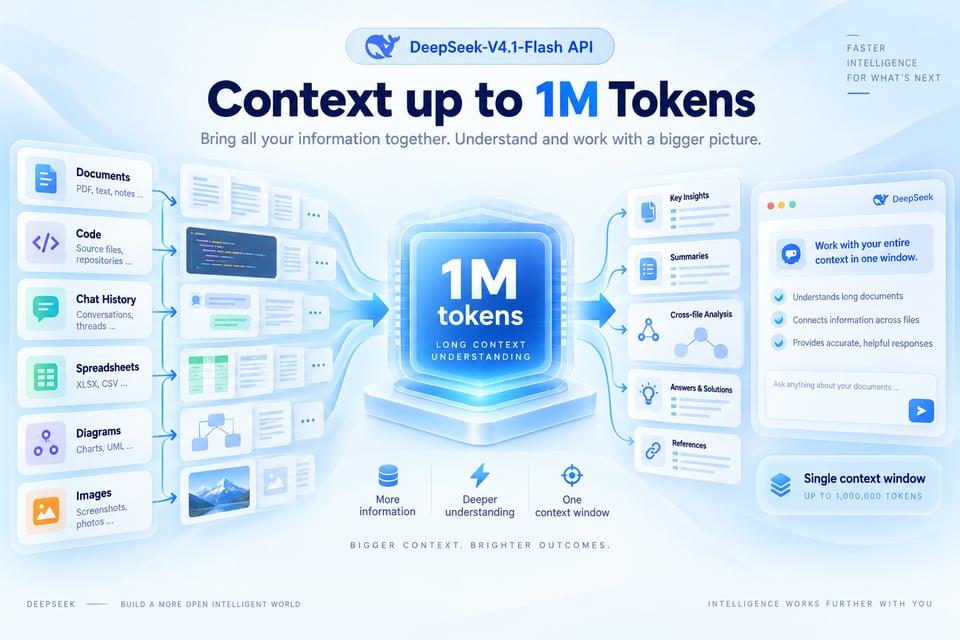
DeepSeek diseñó V4.1 Flash para ofrecer mayor capacidad, inferencia más rápida y mayor rendimiento de procesamiento: un modelo MoE de 552B de parámetros que usa solo 8B de parámetros activos para la entrada y 16B para la salida, lee imágenes y texto de forma nativa y, según su ficha del modelo, admite contextos de hasta un millón de tokens. La actualización del 17 de octubre, DeepSeek V4.1 Flash 1017, mantiene el mismo nombre de modelo y formato de solicitud. En Kie.ai, llamas a la API de DeepSeek 4.1 Flash en el punto de conexión /openai/v1/responses compatible con OpenAI Responses.
Parámetros de la API de DeepSeek V4.1 Flash en Kie.ai
| Parameter | Value |
|---|---|
| Model | deepseek-v4-1-flash |
| Endpoint | POST /openai/v1/responses, compatible with the OpenAI Responses API |
| Ventana de contexto | Hasta 1M de tokens (ficha del modelo de DeepSeek en Hugging Face) |
| Tipos de entrada | Texto e imágenes (partes input_text e input_image en un mismo mensaje); la salida es texto |
| Thinking | Activado por defecto; reasoning.effort acepta none, minimal, low, medium, high, xhigh y max (none desactiva el pensamiento) |
| Tools | Solo herramientas de funciones; tool_choice auto (por defecto), required o una función con nombre |
| Salida estructurada | text.format json_object o json_schema |
| Streaming | stream true o false |
| No admitido | max_output_tokens, temperature y top_p no tienen efecto en este modelo |
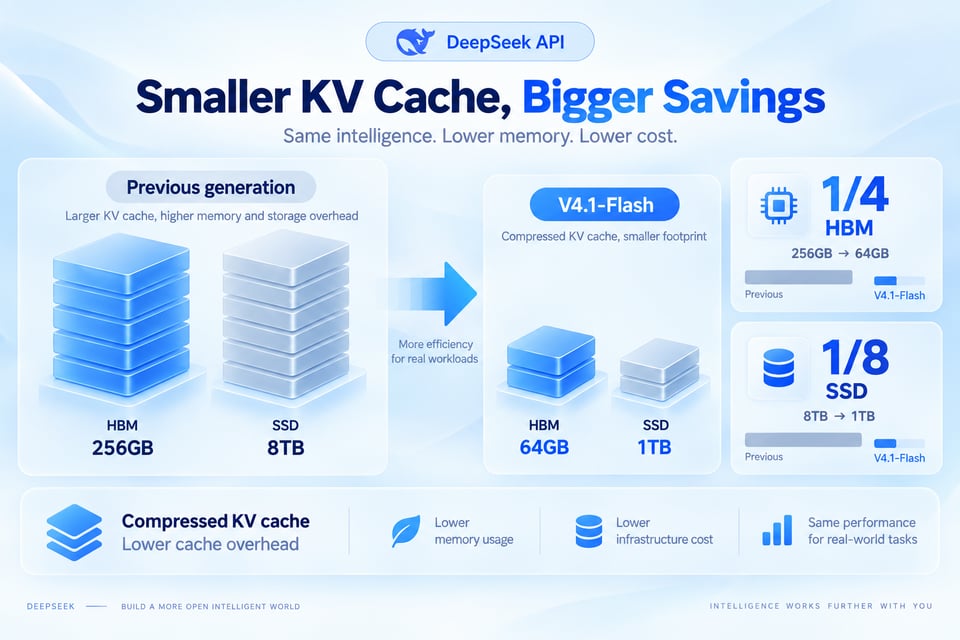
| Architecture | MoE de 552B de parámetros, codificador-decodificador causal, 8B de parámetros activos para la entrada y 16B para la salida (DeepSeek) |
Características clave de la API de DeepSeek V4.1 Flash
Comprensión nativa de imágenes
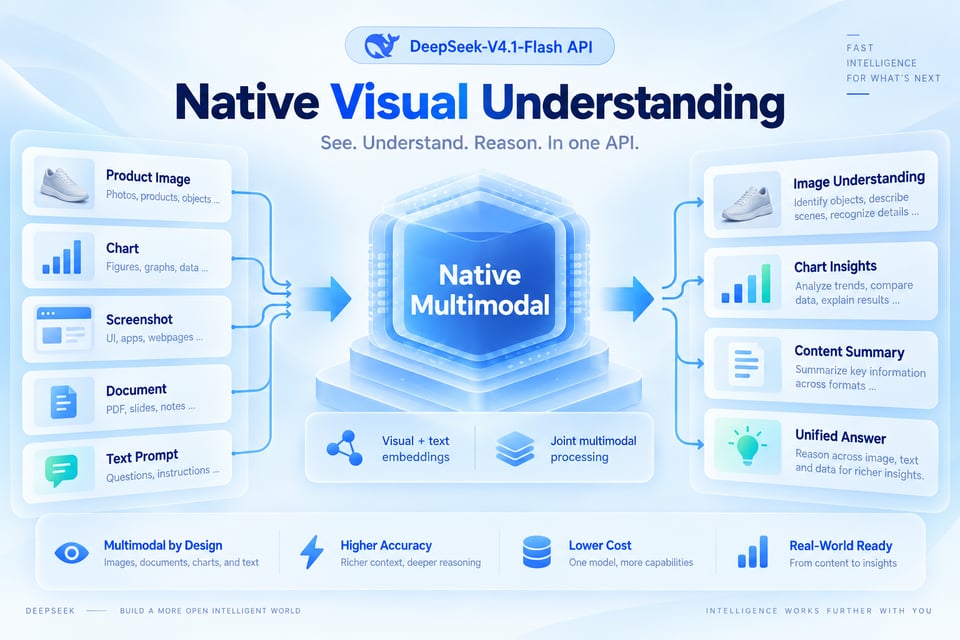
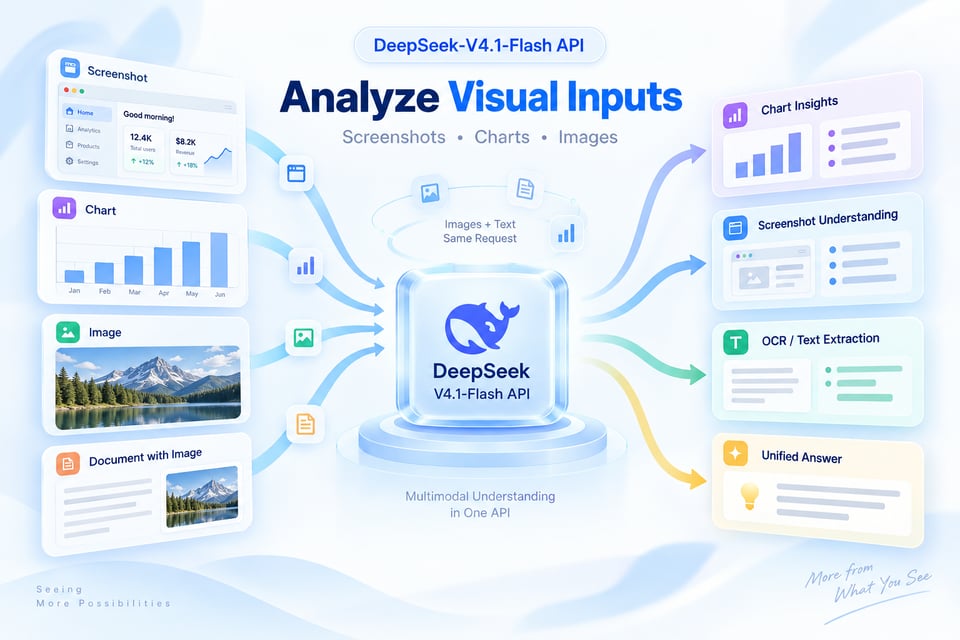
DeepSeek V4.1 Flash procesa imágenes y texto de forma nativa. Combina partes input_image e input_text en un mismo mensaje; image_url acepta una URL accesible públicamente o una cadena data:image en base64. En nuestra prueba en Kie.ai, leyó con exactitud el titular de una imagen de cabecera e identificó el sol brillante de la ilustración.
Arquitectura MoE Efficient 552B
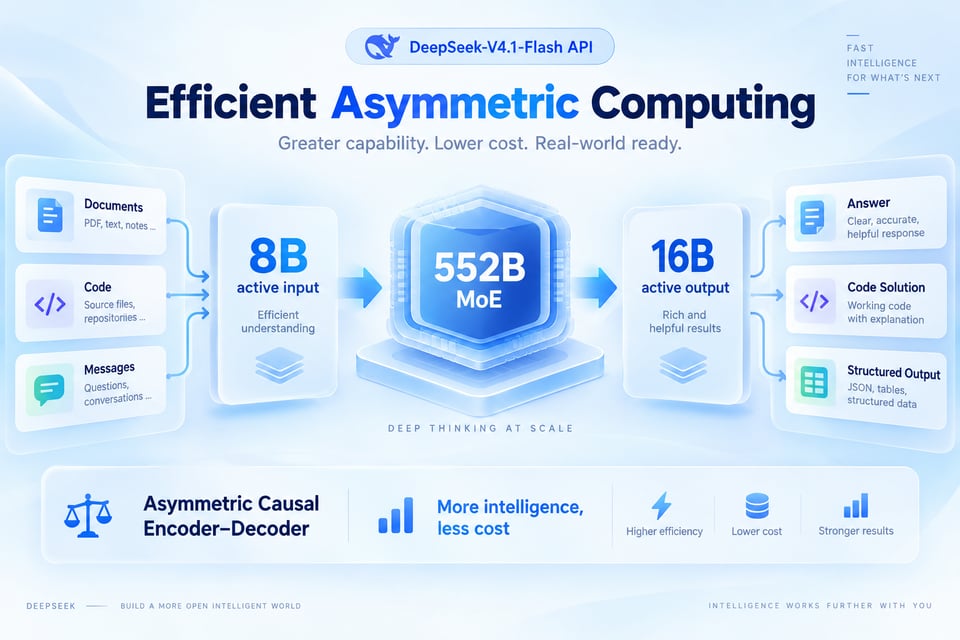
DeepSeek describe V4.1 Flash como el modelo más pequeño de su nueva familia de arquitecturas: un modelo de mezcla de expertos de 552B de parámetros con una arquitectura de codificador-decodificador causal que usa solo 8B de parámetros activos para la entrada y 16B para la salida. DeepSeek informa de una caché KV que necesita 1/4 de la memoria HBM y 1/8 del almacenamiento SSD de la generación anterior.
Hasta 1M de tokens de contexto
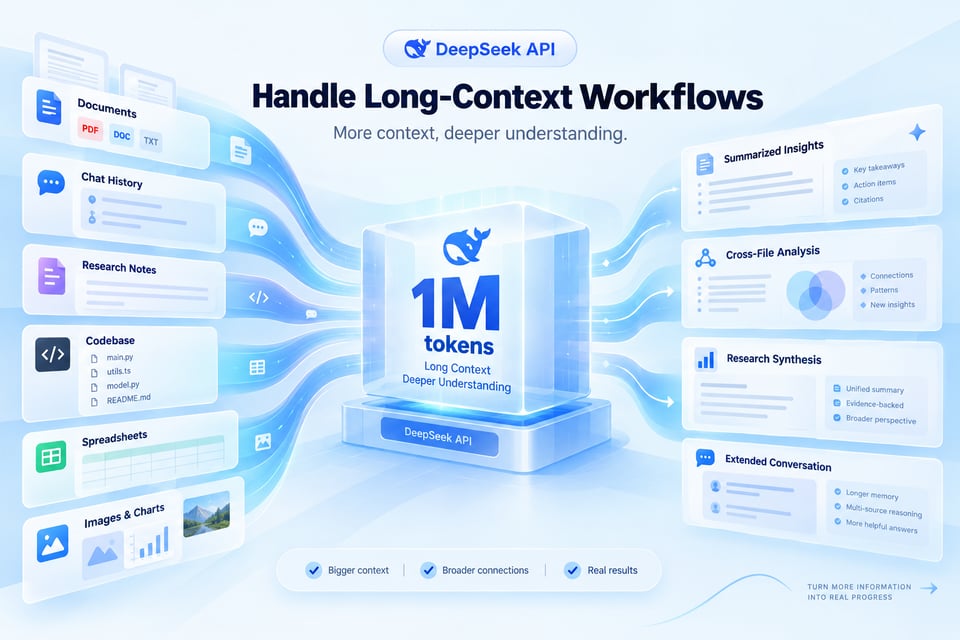
Según la ficha del modelo de DeepSeek, V4.1 Flash admite contextos de hasta un millón de tokens, lo que deja espacio para documentos largos y grandes bases de código. La documentación de Kie.ai no indica ningún límite de contexto distinto para este modelo.
Pensamiento que puedes intensificar o desactivar
El modelo piensa por defecto. Configura reasoning.effort en none para desactivar el pensamiento, en minimal para mantenerlo breve, o en low, medium, high, xhigh o max para un razonamiento más profundo.
Herramientas de funciones y salida JSON
Declara herramientas de funciones y deja que el modelo elija con tool_choice auto, exige una llamada o fija una función con nombre; devuelve los resultados como function_call_output asociados por call_id. Configura text.format en json_object o json_schema para obtener una salida que tu código pueda procesar.
La actualización 1017, la misma integración
DeepSeek V4.1 Flash 1017, lanzado el 17 de octubre de 2026, aporta lo que DeepSeek denomina un mayor rendimiento en las pruebas de referencia, una finalización de tareas más rápida y respuestas más breves que la versión anterior. El nombre del modelo, el punto de conexión y el formato de solicitud no cambian, por lo que las integraciones existentes siguen funcionando.
Resultados de las pruebas de referencia de DeepSeek V4.1 Flash 1017 frente a la versión anterior
Resultados publicados por DeepSeek en su ficha del modelo en Hugging Face para la actualización 1017. Terminal-Bench 4.0 se ejecutó con el entorno de pruebas de Claude Code y DeepSWE v1.1 con el entorno de pruebas de Mini-SWE-V2.
| Benchmark | V4.1 Flash 1017 | V4.1 Flash anterior |
|---|---|---|
| HLE (sin herramientas) | 42.6 | 36.8 |
| Terminal-Bench 4.0 | 42.3 | 31.2 |
| DeepSWE v1.1 | 77.0 | 74.2 |
| ProgramBench | 29.1 | 20.3 |
| NL2Repo-Bench | 68.2 | 65.4 |
| Apex Bench v1.1 | 72.1 | 64.6 |
| Chartography (con herramientas) | 83.0 | 78.9 |
| BabyVision (con herramientas) | 92.5 | 89.6 |
Cómo usar la API de DeepSeek V4.1 Flash en Kie.ai
Paso 1. Obtén tu API key
Paso 2. Envía una solicitud
Paso 3. Añade imágenes, herramientas y salida JSON
Por qué usar la API de DeepSeek V4.1 Flash en Kie.ai
La misma clave en todo el mercado de Kie.ai
Todos los modelos del mercado de Kie.ai usan el mismo método de autenticación: un encabezado Authorization: Bearer YOUR_API_KEY con la clave de tu página de gestión de API keys de Kie.ai.
Créditos gratis y un único saldo
Los nuevos usuarios de Kie.ai reciben 80 créditos gratis para pruebas. Tu cuenta tiene un único saldo de créditos del que se descuentan todos los servicios de generación, y puedes consultarlo con la API Get Remaining Credits.
Nada que alojar ni instalar
Kie.ai ofrece este modelo como una API con un entorno de pruebas; no hay ninguna aplicación que descargar ni instalar. Tampoco hay GPU ni pesos de modelos que gestionar.
Qué puedes crear con la API de DeepSeek V4.1 Flash
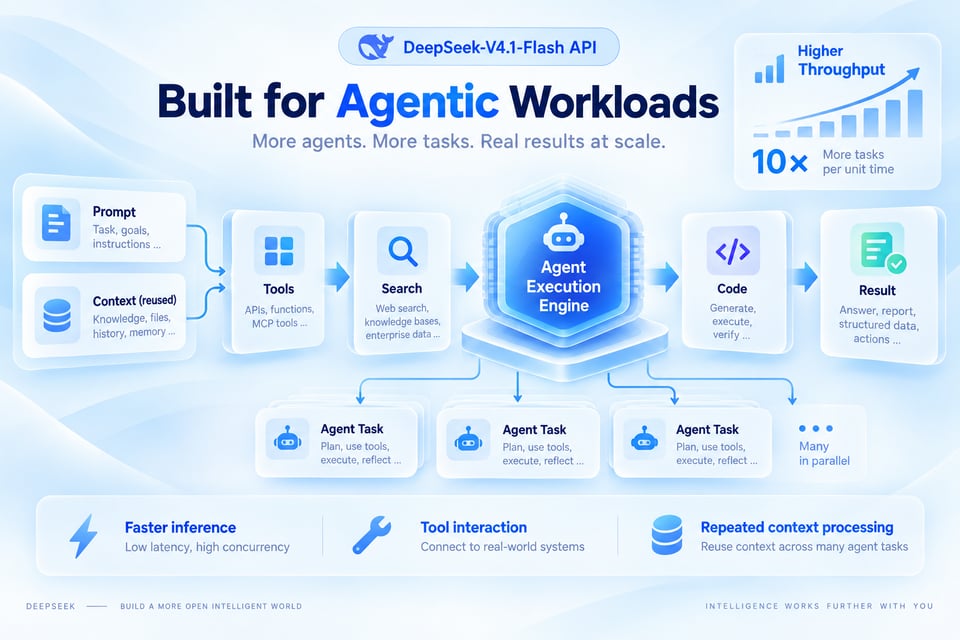
DeepSeek diseñó V4.1 Flash para una inferencia más rápida y un mayor rendimiento de procesamiento. Si buscas un modelo de pesos abiertos más grande con una ventana de contexto de 1 millón de tokens en el mismo endpoint, consulta la API de Kimi K3.1 Pro.
Chat y preguntas y respuestas sobre imágenes
Responder preguntas sobre capturas de pantalla, gráficos, banners y fotos junto con texto en el mismo mensaje.
Preguntas sobre documentos largos y bases de código
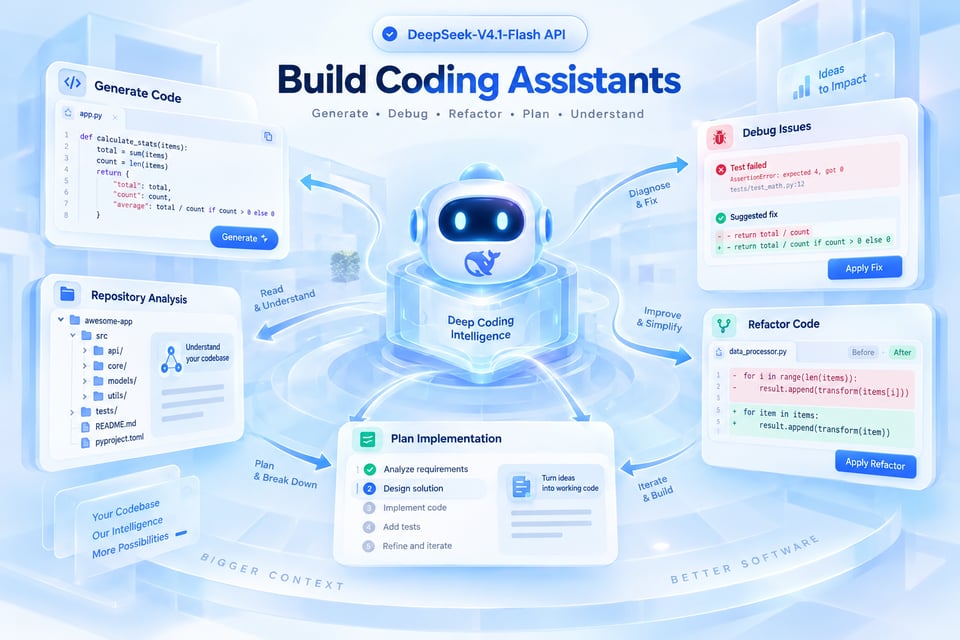
Analizar documentos largos o grandes bases de código en una sola solicitud; la ficha del modelo de DeepSeek indica contextos de hasta un millón de tokens.
Extracción estructurada
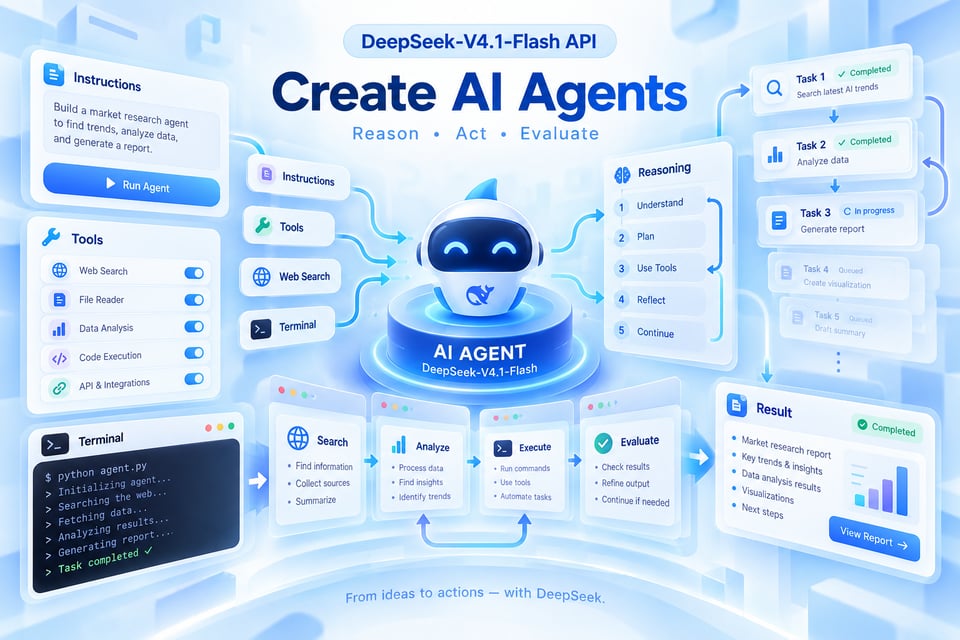
Extraer campos de texto o imágenes a un JSON que siga tu esquema con text.format json_schema.
Funciones de chat de alto volumen
Impulsar funciones de chat donde el rendimiento de procesamiento es clave, reduciendo o desactivando el razonamiento para solicitudes sencillas.