Automatically append previous messages to maintain multi-turn context. May increase token usage.
How can I help you today?
README
Complete guide to using gpt-6-2-sol
GPT-6.2 Sol API para programación diaria y flujos agénticos multietapa

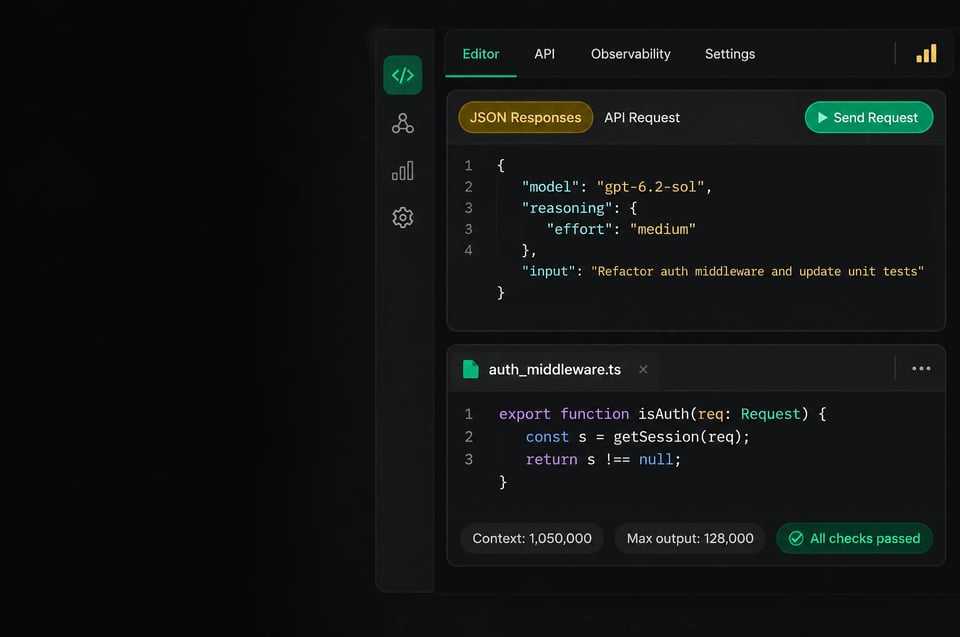
curl https://api.kie.ai/codex/v1/responses \-H "Authorization: Bearer $KIE_API_KEY" \-H "Content-Type: application/json" \-d '{"model": "gpt-6-2-sol","input": "Compare blue-green and canary rollouts for a stateless API.","reasoning": { "effort": "medium" },"stream": false}'
Capacidades clave de GPT-6.2 Sol


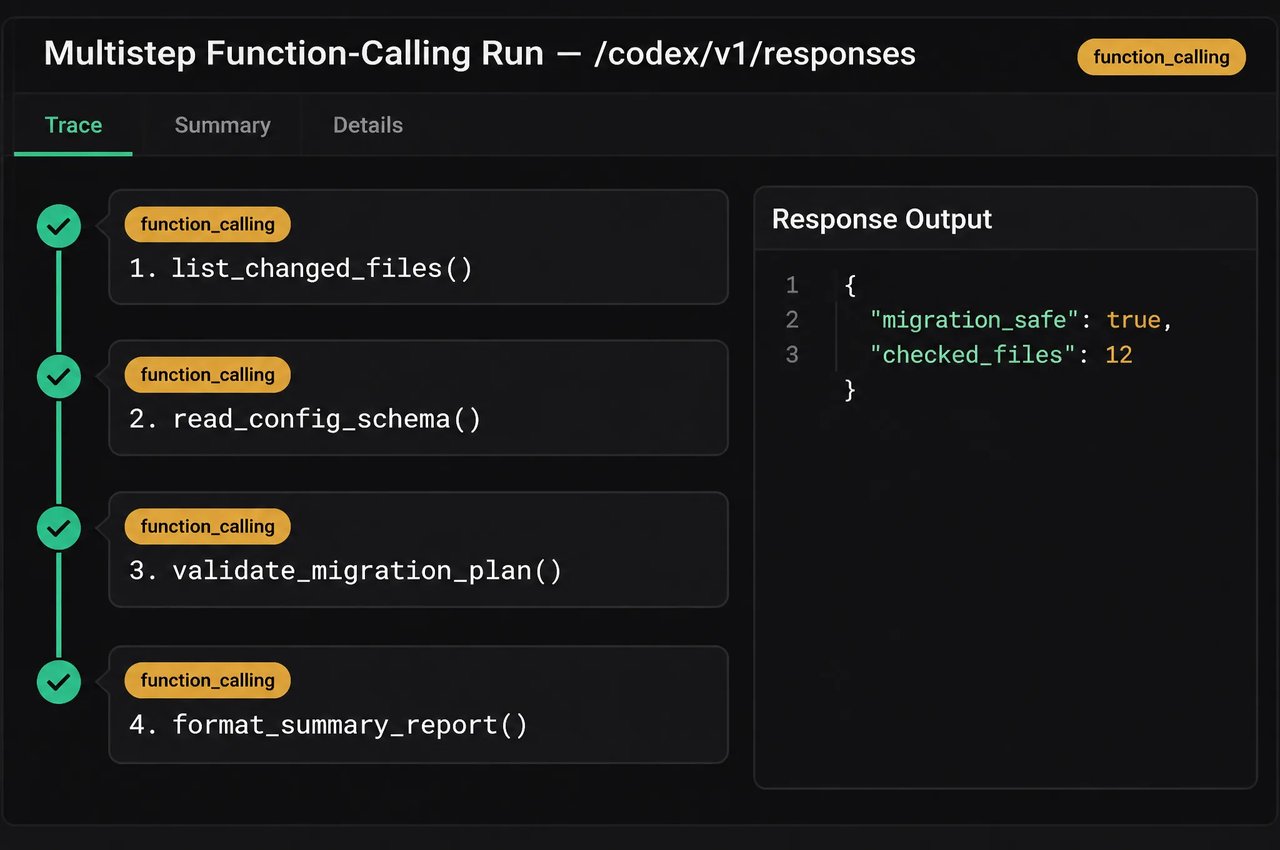
Flujos agénticos multietapa y llamadas a herramientas

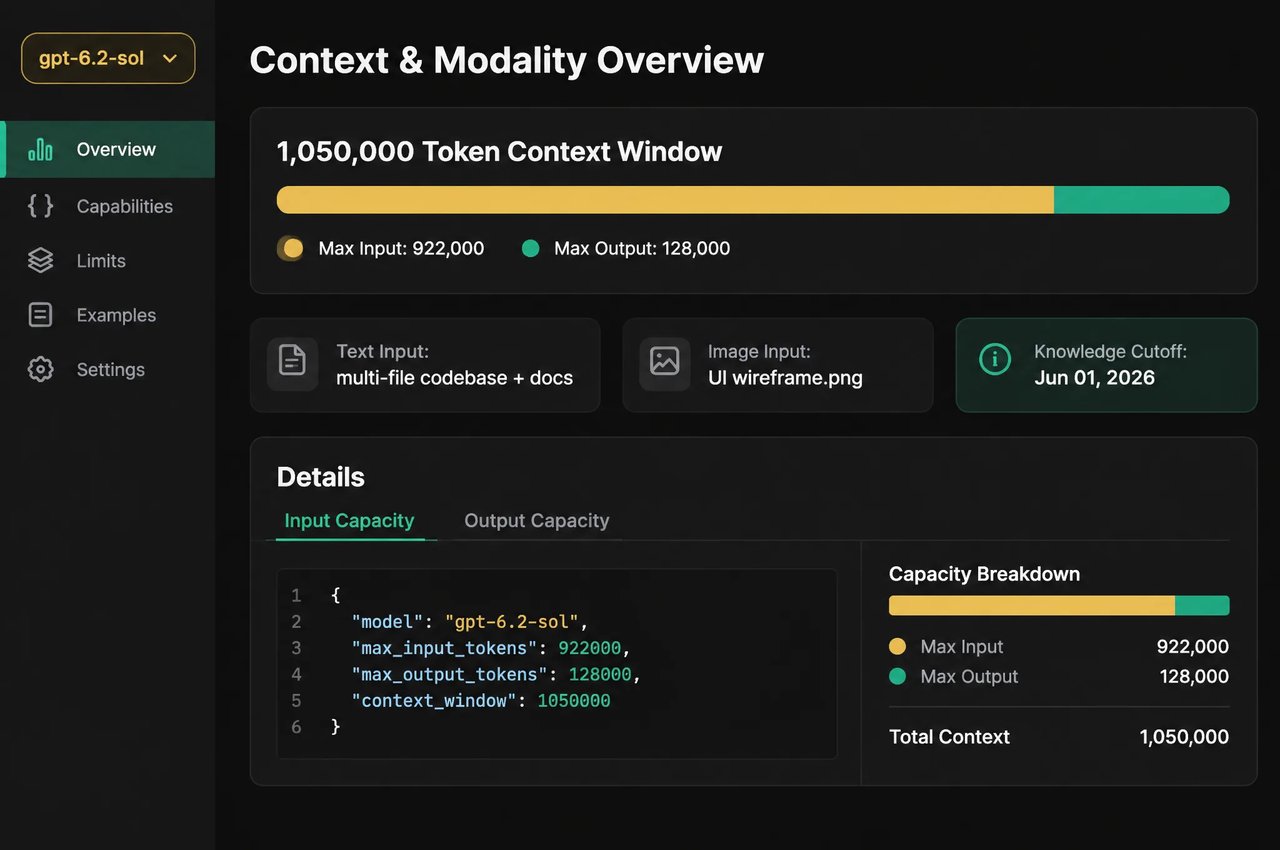
Contexto de 1 050 000 tokens y corte en junio de 2026

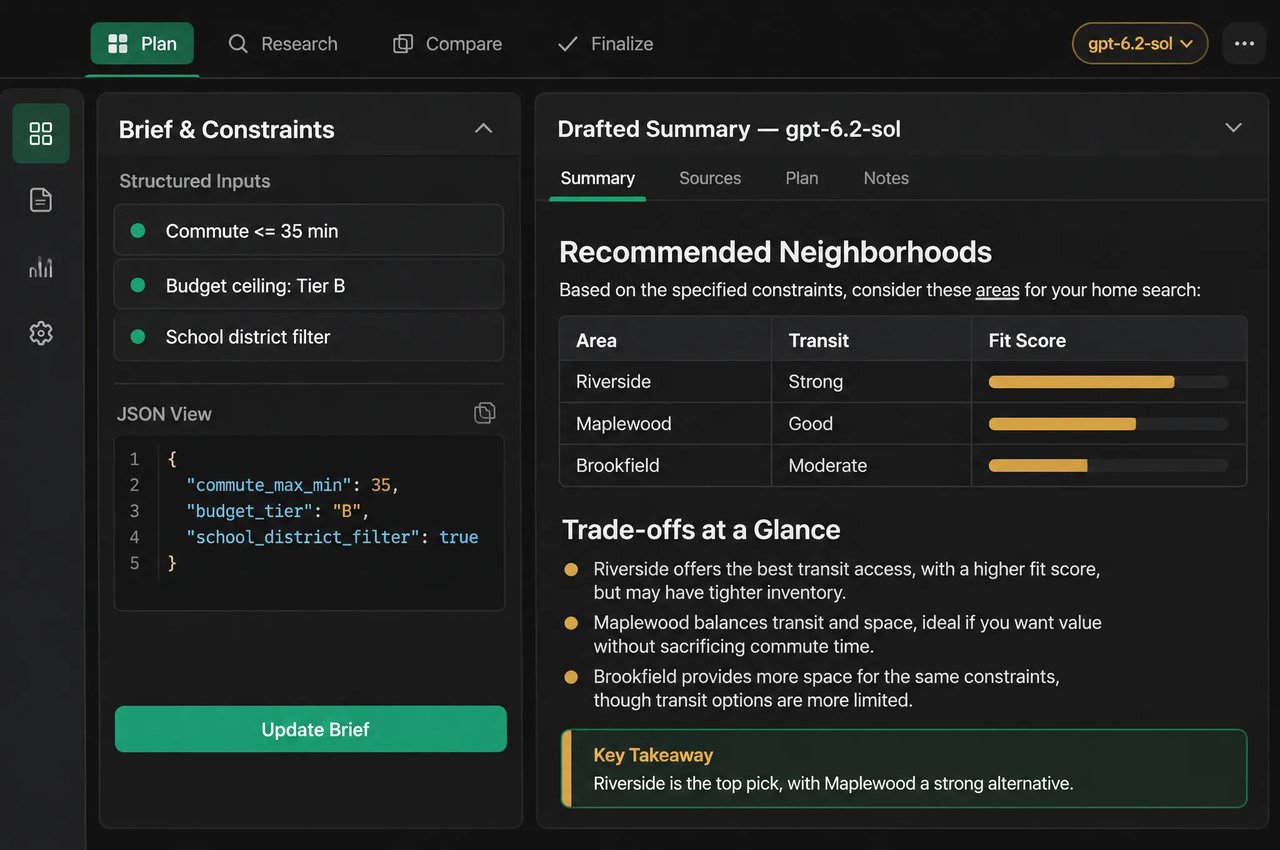
Redacción clara y natural para tareas cotidianas

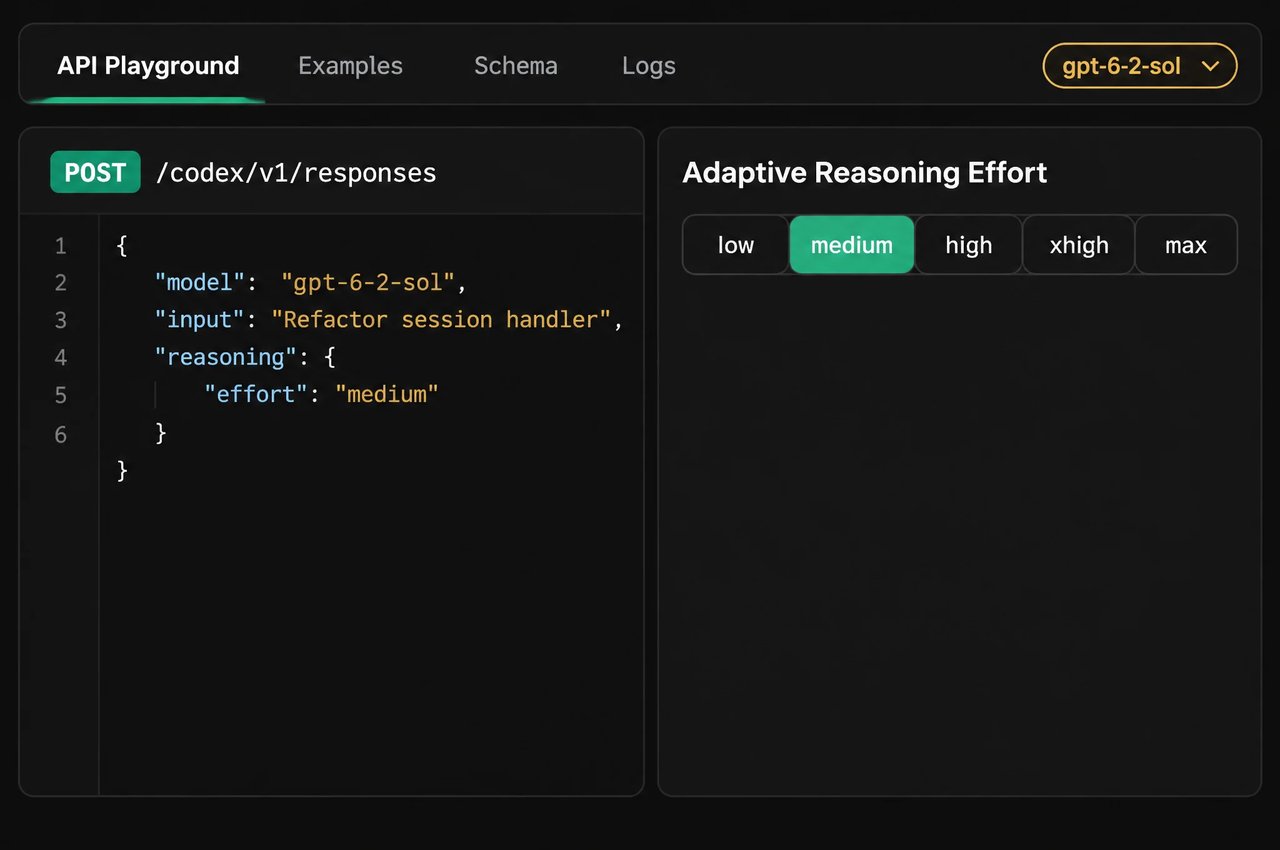
Razonamiento adaptativo de bajo a máximo

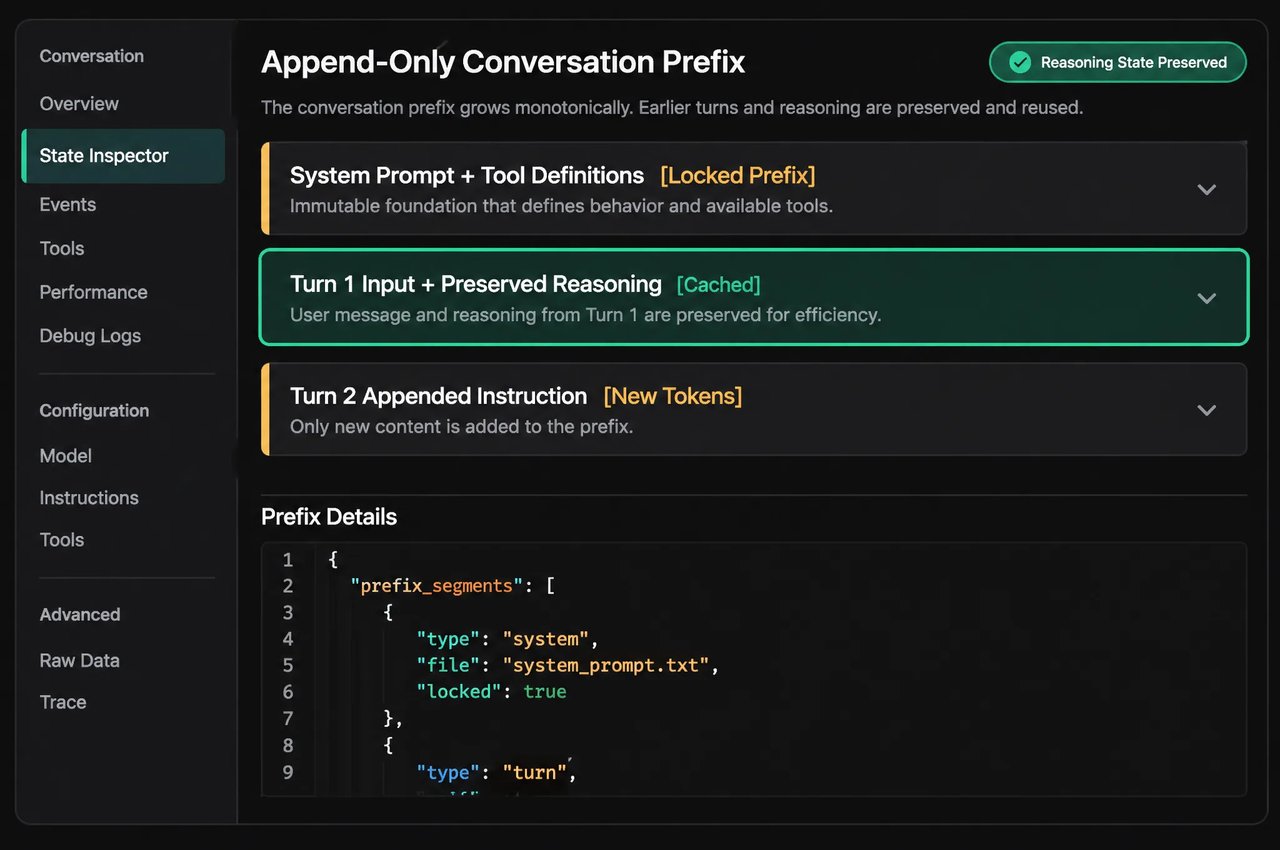
Preservación del razonamiento y almacenamiento en caché de prompts
Especificaciones de GPT-6.2 Sol
Especificaciones de GPT-6.2 Sol de la documentación de OpenAI, junto con detalles del endpoint de Kie.ai.
| Specification | GPT-6.2 Sol |
|---|---|
| Developer | OpenAI |
| ID del modelo | gpt-6-2-sol en Kie.ai (también se acepta gpt-6.2-sol) |
| Fecha de lanzamiento | 17 de noviembre de 2026 |
| Modalities | Entrada de texto e imagen; salida de texto (no admite audio ni video) |
| Ventana de contexto | 1 050 000 tokens (hasta 922 000 tokens de entrada) |
| Tokens de salida máximos | 128 000 tokens |
| Esfuerzo de razonamiento | low, medium, high, xhigh, max |
| Endpoint y herramientas de Kie.ai | POST /codex/v1/responses; custom function calling or web_search (one per request); text, input_image and input_file |
| Características de Kie.ai | Streaming (predeterminado), llamadas a funciones o búsqueda web (una de las dos opciones por petición), entrada de imágenes y archivos, almacenamiento en caché de prompts |
| Parámetros y características no compatibles | Parámetros: temperature, top_p, logprobs, top_logprobs; características: fine-tuning, predicted outputs |
| Fecha de corte de conocimiento | 1 de junio de 2026 |
Aspectos destacados de la evaluación de GPT-6.2 Sol
Resultados de evaluación informados por OpenAI en su anuncio de lanzamiento del 17 de noviembre de 2026, publicaciones de lanzamiento y System Card.
| Benchmark | Resultado de GPT-6.2 Sol | Qué mide |
|---|---|---|
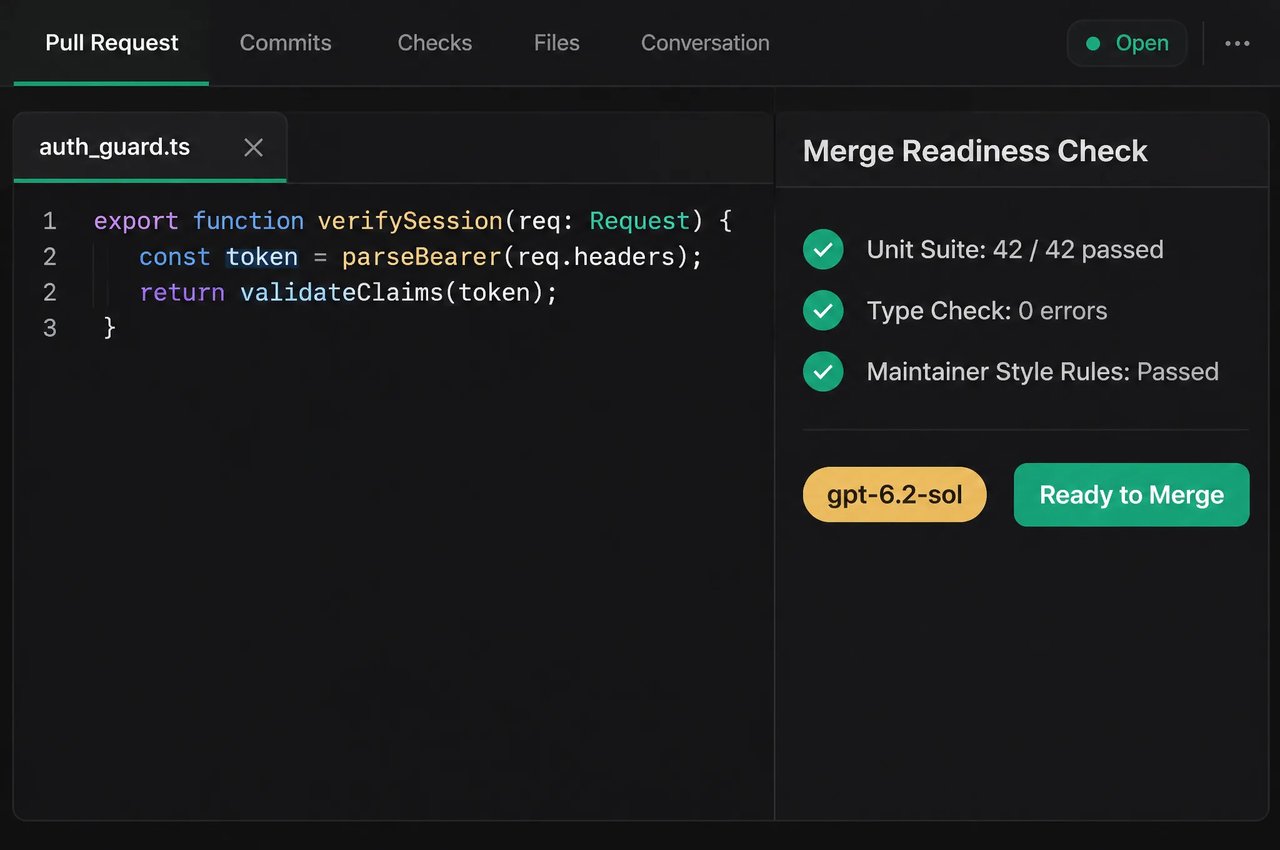
| FrontierCode 2.0 (al máximo) | A menos de 0.5 puntos de GPT-6.2 Astra | Cambios reales en la base de código evaluados según los criterios de los mantenedores para fusionarlos |
| GDPval v2 | +5.3 puntos por encima de GPT-6.1 Sol | Encargos de consultoría, finanzas y diseño que requieren varios pasos |
| LifeVal | Supera a GPT-6 Astra | Tareas de planificación y toma de decisiones cotidianas personalizadas |
| AA-3D | 1259 Elo (GPT-6.2 Astra: 1318 Elo) | Preferencias humanas evaluadas a ciegas sobre aplicaciones 3D interactivas para navegador |
| Objetivos de ciberseguridad de la System Card | 25.0% de los objetivos resueltos frente al 11.4% de GPT-6.1 Sol | Evaluación de objetivos de ciberseguridad en la System Card de GPT-6.2 |
Cómo trabajar con GPT-6.2 Sol
- 1
Paso 1: Empieza con GPT-6.2 Sol y escala a Astra cuando sea necesario
OpenAI recomienda empezar con GPT-6.2 Sol para la programación diaria y lo posiciona como su modelo principal para el trabajo cotidiano. Para tus proyectos más difíciles, pasa a GPT-6.2 Astra, el modelo de frontera de OpenAI. - 2
Paso 2: Elige el esfuerzo de razonamiento de low a max
En Kie.ai, pasa reasoning.effort como low, medium, high, xhigh o max en /codex/v1/responses. OpenAI recomienda empezar con medium para una nueva integración, o cambiar la configuración heredada none y minimal a low. Omite temperature, top_p, logprobs y top_logprobs. - 3
Paso 3: Llama a /codex/v1/responses para herramientas y entradas multimodales
En Kie.ai, envía solicitudes a POST /codex/v1/responses con definiciones de funciones personalizadas o {"type":"web_search"} (elige un tipo de herramienta por solicitud), y adjunta URLs de imágenes o archivos junto con el texto cuando sea necesario. - 4
Paso 4: Mantén los prefijos de los prompts sin cambios entre turnos
A partir de GPT-6.2, la API de OpenAI descarta los elementos de razonamiento cuando detecta ediciones de prefijos a mitad de la conversación (como cambios en las instrucciones o llamadas a herramientas), un cambio a un modelo de menor capacidad o un cambio en el usuario final u organización. OpenAI recomienda mantener los prefijos de los prompts sin cambios y añadir nuevas instrucciones para ayudar a preservar el razonamiento entre turnos y mantener la entrada anterior elegible para el almacenamiento en caché de los prompts.