Automatically append previous messages to maintain multi-turn context. May increase token usage.
How can I help you today?
README
Complete guide to using deepseek-v4-1-flash
DeepSeek V4.1 Flash API для мультимодального чата
Компания DeepSeek разработала V4.1 Flash для расширения возможностей, ускорения инференса и повышения пропускной способности: это MoE-модель с 552 млрд параметров, которая использует всего 8 млрд активных параметров на входе и 16 млрд на выходе, нативно обрабатывает изображения и текст и, согласно карточке модели, поддерживает контекст объёмом до одного миллиона токенов. Обновление от 17 октября, DeepSeek V4.1 Flash 1017, сохраняет прежнее имя модели и формат запросов. На платформе Kie.ai вызов DeepSeek 4.1 Flash API выполняется через эндпоинт /openai/v1/responses, совместимый с OpenAI Responses.
Параметры DeepSeek V4.1 Flash API на Kie.ai
| Parameter | Value |
|---|---|
| Model | deepseek-v4-1-flash |
| Endpoint | POST /openai/v1/responses, compatible with the OpenAI Responses API |
| Контекстное окно | До 1 млн токенов (карточка модели DeepSeek на Hugging Face) |
| Типы входных данных | Текст и изображения (элементы input_text и input_image в одном сообщении); на выходе — текст |
| Thinking | Включено по умолчанию; reasoning.effort принимает значения none, minimal, low, medium, high, xhigh и max (none отключает размышление) |
| Tools | Только функциональные инструменты; tool_choice: auto (по умолчанию), required или одна указанная функция |
| Структурированный вывод | text.format: json_object или json_schema |
| Streaming | stream: true или false |
| Не поддерживается | Параметры max_output_tokens, temperature и top_p не влияют на работу этой модели |
| Architecture | MoE с 552 млрд параметров, каузальный энкодер-декодер, 8 млрд активных параметров на входе и 16 млрд на выходе (DeepSeek) |
Ключевые возможности DeepSeek V4.1 Flash API
Нативное понимание изображений
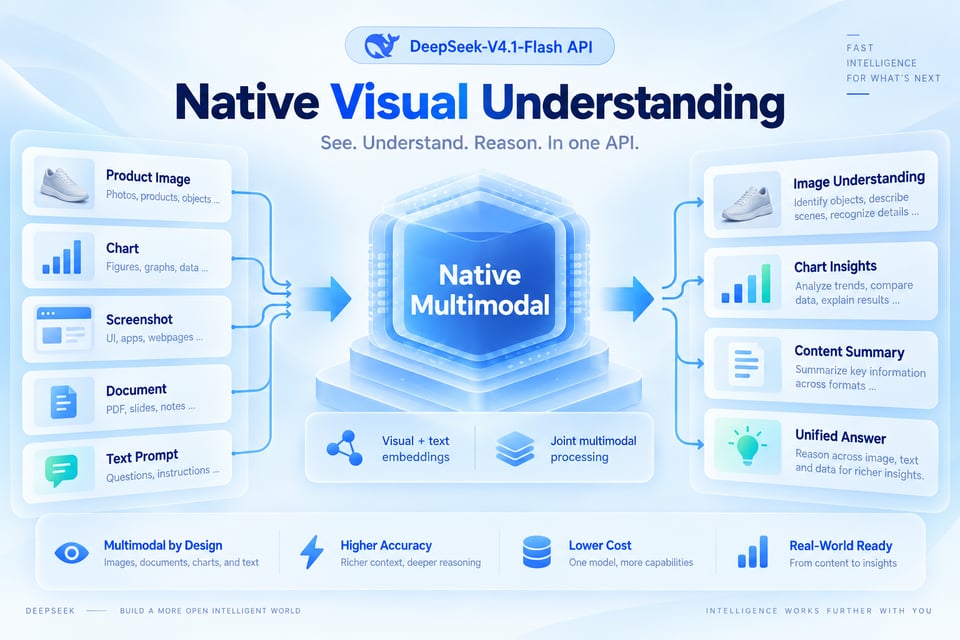
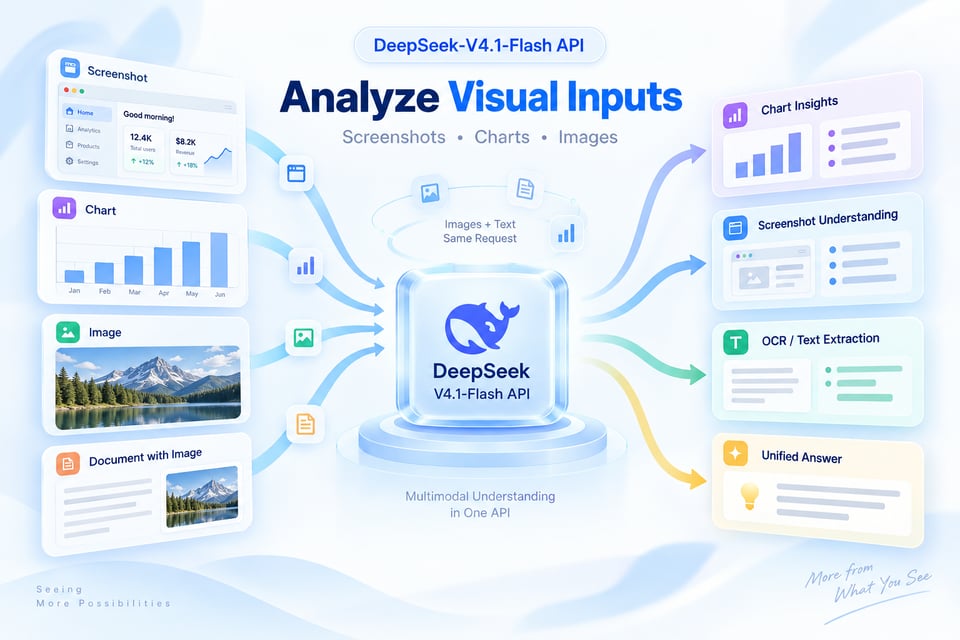
DeepSeek V4.1 Flash нативно обрабатывает изображения и текст. Комбинируйте элементы input_image и input_text в одном сообщении: image_url принимает публично доступный URL или строку base64 в формате data:image. В нашем тесте на Kie.ai модель точно прочитала заголовок на баннере и назвала светящееся солнце на изображении.
Архитектура Efficient 552B MoE
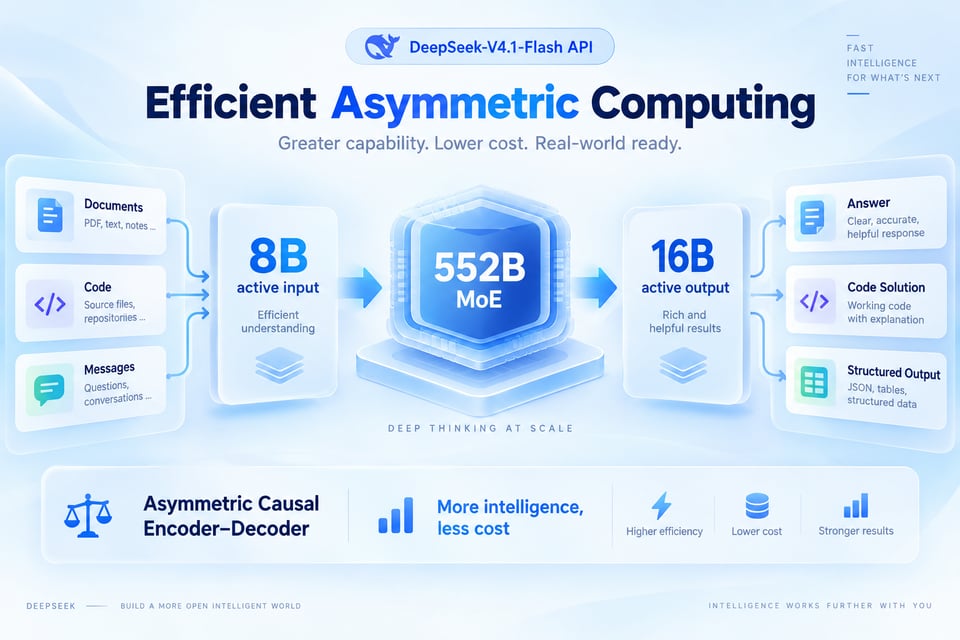
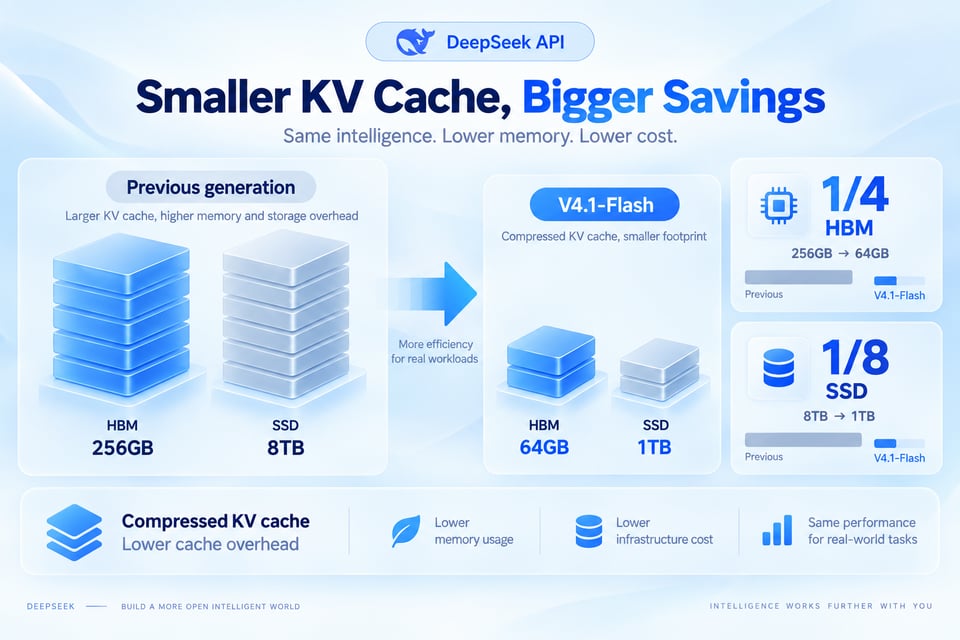
DeepSeek описывает V4.1 Flash как самую компактную модель в своём новом семействе архитектур: это модель «смесь экспертов» (MoE) с 552 млрд параметров на базе каузального энкодера-декодера, которая использует всего 8 млрд активных параметров на входе и 16 млрд на выходе. По данным DeepSeek, её KV-кэш требует 1/4 объёма памяти HBM и 1/8 объёма накопителя SSD по сравнению с предыдущим поколением.
До 1 млн токенов контекста
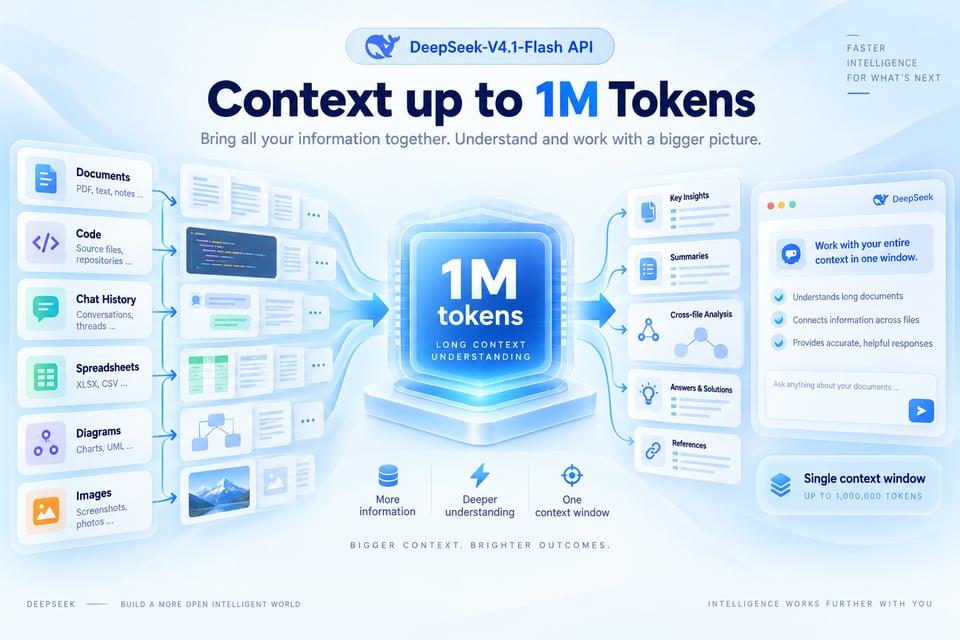
Согласно карточке модели DeepSeek, V4.1 Flash поддерживает контекст объёмом до одного миллиона токенов, что позволяет работать с длинными документами и крупными кодовыми базами. В документации Kie.ai не указано отдельное ограничение контекста для этой модели.
Режим размышления, который можно усилить или отключить
По умолчанию модель использует режим размышления. Установите для reasoning.effort значение none, чтобы отключить размышление, minimal — для краткого размышления, либо low, medium, high, xhigh или max — для более глубоких рассуждений.
Функциональные инструменты и вывод в формате JSON
Объявляйте функциональные инструменты и позволяйте модели выбирать их с помощью tool_choice auto, требуйте обязательный вызов или закрепляйте одну указанную функцию; возвращайте результаты через function_call_output с привязкой по call_id. Установите для text.format значение json_object или json_schema, чтобы получать вывод, удобный для парсинга в коде.
Обновление 1017: прежняя интеграция
Версия DeepSeek V4.1 Flash 1017, выпущенная 17 октября 2026 года, обеспечивает, по заявлению DeepSeek, более высокие результаты в бенчмарках, более быстрое выполнение задач и более лаконичные ответы по сравнению с предыдущей версией. Имя модели, эндпоинт и формат запросов остались прежними, поэтому существующие интеграции продолжают работать.
Результаты бенчмарков DeepSeek V4.1 Flash 1017 по сравнению с предыдущей версией
Результаты, опубликованные DeepSeek в карточке модели на Hugging Face для обновления 1017. Тест Terminal-Bench 4.0 запускался в тестовой среде Claude Code, а DeepSWE v1.1 — в тестовой среде Mini-SWE-V2.
| Benchmark | V4.1 Flash 1017 | Предыдущая версия V4.1 Flash |
|---|---|---|
| HLE (без инструментов) | 42.6 | 36.8 |
| Terminal-Bench 4.0 | 42.3 | 31.2 |
| DeepSWE v1.1 | 77.0 | 74.2 |
| ProgramBench | 29.1 | 20.3 |
| NL2Repo-Bench | 68.2 | 65.4 |
| Apex Bench v1.1 | 72.1 | 64.6 |
| Chartography (с инструментами) | 83.0 | 78.9 |
| BabyVision (с инструментами) | 92.5 | 89.6 |
Как использовать DeepSeek V4.1 Flash API на Kie.ai
Шаг 1. Получите API-ключ
Шаг 2. Отправьте запрос
Шаг 3. Добавьте изображения, инструменты и вывод в JSON
Почему стоит использовать DeepSeek V4.1 Flash API на Kie.ai
Один ключ для всего каталога Kie.ai
Все модели в каталоге Kie.ai используют один метод аутентификации: заголовок Authorization: Bearer YOUR_API_KEY с ключом со страницы управления API-ключами Kie.ai.
Бесплатные кредиты и единый баланс
Новые пользователи Kie.ai получают 80 бесплатных кредитов для тестирования. В вашем аккаунте единый баланс кредитов для всех сервисов генерации, который можно проверить через API получения остатка кредитов.
Ничего не нужно размещать или устанавливать
Kie.ai предоставляет эту модель через API с площадкой для тестирования; скачивать или устанавливать приложение не нужно. Вам не придётся управлять графическими процессорами или весами модели.
Что можно создать с DeepSeek V4.1 Flash API
DeepSeek разработала V4.1 Flash для более быстрого инференса и более высокой пропускной способности. Если нужна более крупная модель с открытыми весами и контекстным окном на 1 миллион токенов на той же конечной точке, обратите внимание на Kimi K3.1 Pro API.
Чат и ответы на вопросы об изображениях
Ответы на вопросы о скриншотах, диаграммах, баннерах и фотографиях, переданных вместе с текстом в одном сообщении.
Вопросы по длинным документам и кодовым базам
Работа с длинными документами или большими кодовыми базами в одном запросе; в карточке модели DeepSeek указан контекст до одного миллиона токенов.
Структурированное извлечение данных
Извлечение полей из текста или изображений в JSON, соответствующий вашей схеме, с помощью text.format json_schema.
Чат для высоких нагрузок
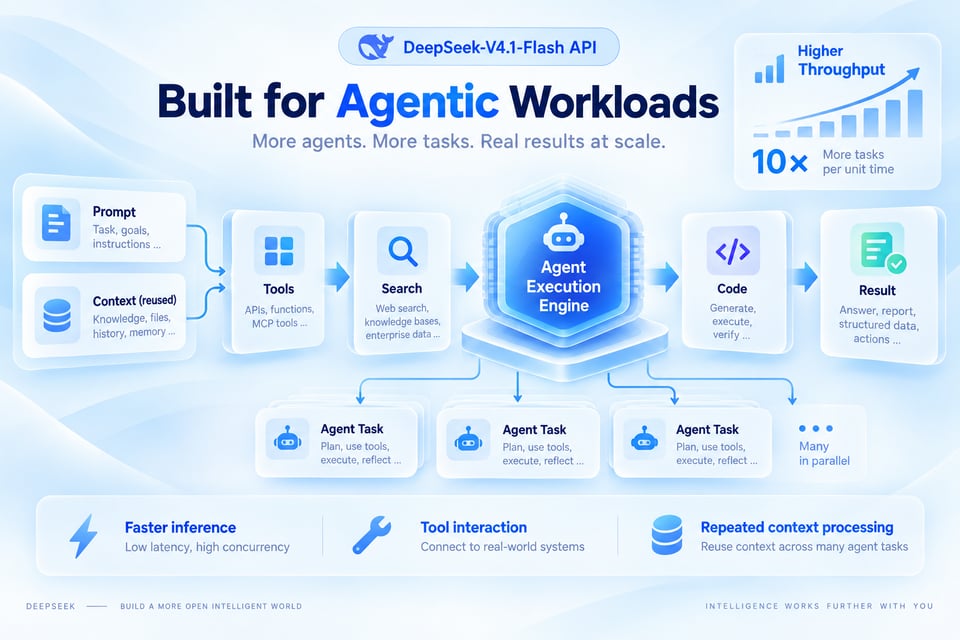
Обеспечение работы чата, где важна пропускная способность, с сокращёнными или отключёнными рассуждениями для простых запросов.