Явно указывайте формат выходного файла
В документации рекомендуется задавать параметр output_format явно, поэтому указывайте PNG или JPEG в каждом запросе, не полагаясь на значение по умолчанию.
Qwen Image 3.0 — передовая модель генерации изображений от Alibaba для создания реалистичных изображений, структурированных макетов, богатой визуальной детализации и качественной типографики.
Click to upload or drag and drop
Supported formats: JPEG, PNG, WEBP, BMP, GIF, TIFF Maximum file size: 10MB; Maximum files: 3
Upload an image file to use as input for the API
The positive prompt that describes the image content, style, and composition you want to generate or edit. Both Chinese and English are supported.
0/5000The output image resolution.
The output image size.
Generate image format
Whether to enable intelligent prompt rewriting. Default: true (recommended). When enabled, the model optimizes the positive prompt, which significantly improves results for simple descriptions.
The negative prompt that describes content you do not want to appear in the image.
0/5000The random seed. Value range: [0, 2147483647]. A fixed seed helps maintain relatively stable results.
A configurable parameter. Defaults to true in the Playground.
Explore different use cases and parameter configurations
The positive prompt that describes the image content, style, and composition you want to generate or edit. Both Chinese and English are supported.
0/5000The output image resolution.
The output image size
Generate image format
Whether to enable intelligent prompt rewriting. Default: true (recommended). When enabled, the model optimizes the positive prompt, which significantly improves results for simple descriptions.
The negative prompt that describes content you do not want to appear in the image.
0/5000The random seed. Value range: [0, 2147483647]. A fixed seed helps maintain relatively stable results.
A configurable parameter. Defaults to true in the Playground.
Explore different use cases and parameter configurations
The positive prompt that describes the image content, style, and composition you want to generate or edit. Both Chinese and English are supported.
0/5000The output image resolution.
The output image size
Generate image format
Whether to enable intelligent prompt rewriting. Default: true (recommended). When enabled, the model optimizes the positive prompt, which significantly improves results for simple descriptions.
The negative prompt that describes content you do not want to appear in the image.
0/5000The random seed. Value range: [0, 2147483647]. A fixed seed helps maintain relatively stable results.
A configurable parameter. Defaults to true in the Playground.
Explore different use cases and parameter configurations
Click to upload or drag and drop
Supported formats: JPEG, PNG, WEBP, BMP, GIF, TIFF Maximum file size: 10MB; Maximum files: 3
Upload an image file to use as input for the API
The positive prompt that describes the image content, style, and composition you want to generate or edit. Both Chinese and English are supported.
0/5000The output image resolution.
The output image size.
Generate image format
Whether to enable intelligent prompt rewriting. Default: true (recommended). When enabled, the model optimizes the positive prompt, which significantly improves results for simple descriptions.
The negative prompt that describes content you do not want to appear in the image.
0/5000The random seed. Value range: [0, 2147483647]. A fixed seed helps maintain relatively stable results.
A configurable parameter. Defaults to true in the Playground.
Explore different use cases and parameter configurations
Complete guide to using Qwen Image 3.0
Qwen-Image-3.0 — модель третьего поколения в серии Qwen-Image, созданная для информационно насыщенных изображений: промпты до 4,5K токенов, читаемый текст размером от 10px и нативная отрисовка на 12 языках. На Kie.ai она доступна в виде четырёх моделей API: стандартной и Pro, каждая — для генерации по тексту и по изображению.
Qwen Image 3 и Qwen Image 3 Pro на Kie.ai принимают одни и те же параметры; различаются сами модели, а не структура запроса.
| Parameter | Value |
|---|---|
| Models | Стандартная: qwen3/text-to-image, qwen3/image-to-image. Pro: qwen3/pro-text-to-image, qwen3/pro-image-to-image |
| Endpoint | POST /api/v1/jobs/createTask, then Get Task Details or a callBackUrl for the result |
| Prompt | Обязательный; китайский или английский; до 5 000 символов на запрос. По данным команды Qwen, модель обрабатывает длинные промпты объёмом около 4,5K токенов |
| Негативный промпт | Необязательный; до 5 000 символов |
| Входные изображения (генерация по изображению) | От 1 до 3 URL изображений; JPEG, PNG, WebP, BMP, GIF или TIFF; до 10 МБ каждое |
| Resolution | 1K или 2K (для генерации по изображению по умолчанию 1K) |
| Соотношение сторон | 1:1, 3:2, 2:3, 4:3, 3:4, 16:9, 9:16, 21:9 (по умолчанию 16:9) |
| Формат вывода | PNG или JPEG |
| Переписывание промпта | prompt_extend, включено по умолчанию |
| Seed | Необязательный, от 0 до 2 147 483 647; случайное значение, если не указано |
| Pricing | Зависит от модели и разрешения, указана в карточке цен выше |
Каждый пример ниже сгенерирован с помощью Qwen Image 3 Pro на Kie.ai в октябре 2026 года по промпту, описанному в подписи; изображения показаны без изменений, уменьшены только для веб-страницы.
Модель Qwen-Image-3.0 рассчитана на длинные промпты объёмом около 4,5K токенов, поэтому в одном запросе можно описать весь макет. Эта инфографика получена из одного промпта примерно на 110 слов, в котором были заданы четыре панели, их подписи, столбчатая диаграмма с четырьмя значениями и подпись в нижнем колонтитуле — все эти элементы присутствуют на изображении.

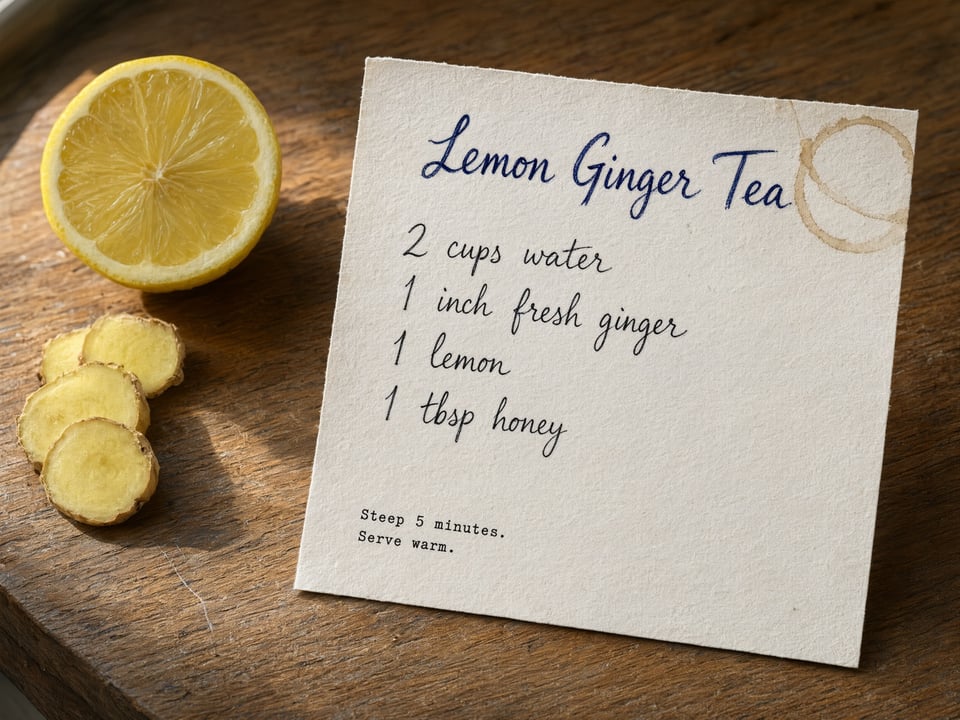
По заявлению команды Qwen, модель отрисовывает текст размером от 10px и мелкие детали поверхностей. Здесь рукописный список ингредиентов и небольшая печатная заметка остаются читаемыми; также видны волокна бумаги, слабый кольцевой след от кофейной чашки и текстура дерева.
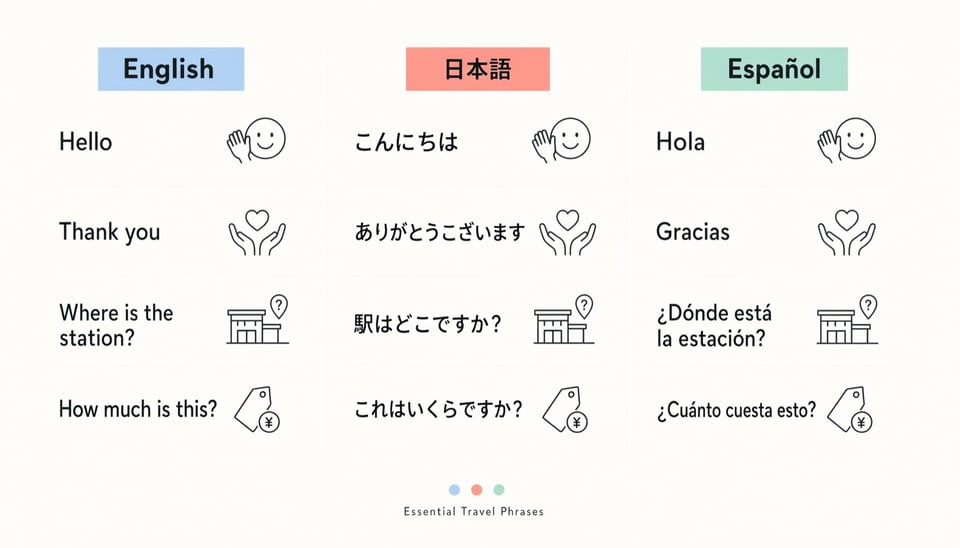
Qwen-Image-3.0 нативно отрисовывает текст на 12 языках. На этом постере размещены одни и те же четыре фразы на английском, японском и испанском языках, включая символы японского письма кана и кандзи, а также испанские диакритические знаки и перевёрнутые вопросительные знаки.
На основе карточки с рецептом выше одной инструкцией были добавлены три рукописные заметки, две из которых — со стрелками. При редактировании сама карточка, стол и освещение остались прежними — были добавлены только заметки.

На Kie.ai обе версии принимают одинаковый запрос, поэтому для переключения достаточно изменить одно слово в названии модели. В рейтинге генерации изображений по тексту Artificial Analysis модель Qwen-Image-3.0-Pro набирает 1 087 баллов, а Qwen-Image-3.0 — 1 075, при этом диапазоны их оценок пересекаются. Поскольку измеренная разница невелика, на практике по умолчанию подойдёт стандартная модель; используйте версию Pro для финальных материалов с большим количеством текста, только если прямое сравнение на ваших промптах покажет разницу. Стоимость каждой модели указана в карточке цен выше.Команда Qwen позиционирует Qwen-Image-3.0 как решение для информационно насыщенных изображений: газет, раскадровок, экзаменационных бланков и макетов интерфейсов. Что касается именно текста, в рейтинге отрисовки текста LMArena у Qwen-Image-3.0-Pro 1 283 балла, у GPT Image 2 (medium) — 1 425, а у Seedream 5.0 Pro — 1 255 (по состоянию на 7 октября 2026 года).
| Qwen Image 3 | Qwen Image 3 Pro | |
|---|---|---|
| Модели на Kie.ai | qwen3/text-to-image, qwen3/image-to-image | qwen3/pro-text-to-image, qwen3/pro-image-to-image |
| Параметры запроса | Те же, что у Pro | Те же, что у стандартной версии |
| Оценка Artificial Analysis (генерация изображений по тексту, окт. 2026 г.) | 1075 | 1087 |
| Оценка LMArena (генерация изображений по тексту, 7 окт. 2026 г.) | Нет в рейтинге | 1255 |
| Оценка LMArena (рендеринг текста, 7 окт. 2026 г.) | Нет в рейтинге | 1283 |
| Pricing | Указано в карточке с ценами выше | Указано в карточке с ценами выше |
Команда Qwen создала Qwen-Image-3.0 для изображений, где важны не только визуальный стиль, но и точность текста и верстки. Ниже перечислены задачи, для которых подходит эта модель.
Слайды для уроков, экзаменационные работы, страницы с большим количеством формул и газетная верстка, где каждый заголовок, подпись и уравнение должны четко читаться на одном изображении.
Реалистичные экраны веб-страниц, мобильных приложений, игр и прямых трансляций, которые можно использовать в презентациях проектов, при обсуждении дизайна или в ранних пользовательских тестах еще до начала разработки.
Постеры, меню, вывески и графика для соцсетей, которым нужен одинаковый дизайн на нескольких языках: текст генерируется сразу внутри изображения, а не добавляется впоследствии.
Превращение готовой фотографии в размеченную иллюстрацию для отчетов, научных заметок или документации к продукту в режиме image-to-image с сохранением исходного объекта и добавлением подписей.
В документации рекомендуется задавать параметр output_format явно, поэтому указывайте PNG или JPEG в каждом запросе, не полагаясь на значение по умолчанию.
Режим image-to-image принимает URL-адреса размещенных в сети изображений. Локальные файлы можно предварительно загрузить через File Upload API на Kie.ai (поддерживаются Base64, файловый поток или внешний URL).
На одном из четырех тестовых изображений модель добавила подписи, о которых мы не просили (см. инфографику выше), поэтому перед публикацией проверяйте сгенерированный текст, особенно цифры и имена. Переписывание промпта (prompt_extend) включено по умолчанию: если вам нужна точная формулировка, сравните результаты с включенной и выключенной опцией.
Все модели в каталоге Kie.ai используют один и тот же метод аутентификации — заголовок Authorization: Bearer YOUR_API_KEY с ключом со страницы управления API-ключами Kie.ai.
Новые пользователи Kie.ai получают 80 бесплатных кредитов для тестирования. У вашего аккаунта единый баланс кредитов для всех сервисов генерации; проверить его можно с помощью API Get Remaining Credits.
Kie.ai предоставляет эту модель через API и песочницу; скачивать или устанавливать приложение не нужно. Управлять GPU или весами модели также не требуется.