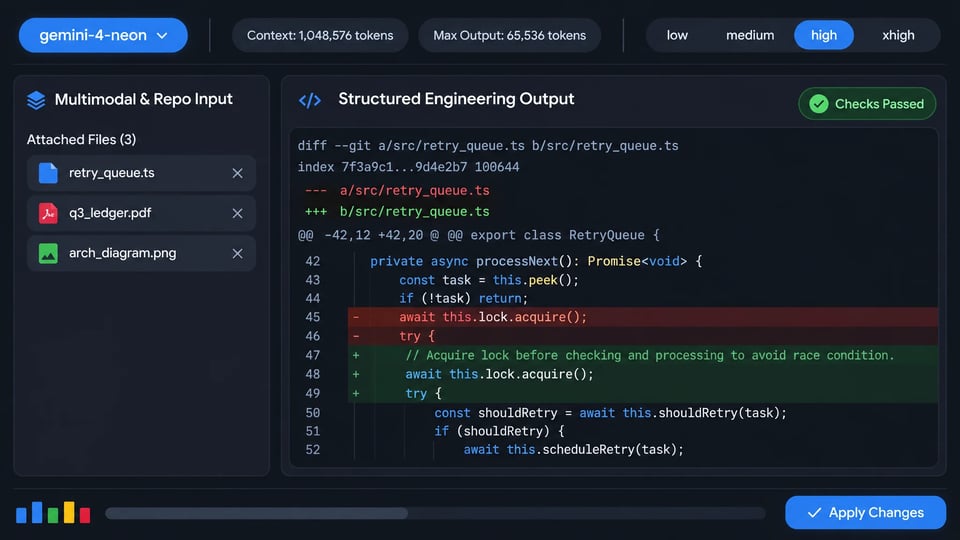
Google представила Gemini 4 Neon (gemini-4-neon) 18 ноября 2026 года, чтобы сбалансировать глубину рассуждений передового уровня и эффективное выполнение задач от начала до конца в сложной разработке ПО, аналитике, работе со знаниями и научных сценариях. Модель адаптирована на базе Gemini 4 Carbon, занимает место между Gemini 4 Hydrogen и Gemini 4 Carbon в семействе Gemini 4 и предлагает единое контекстное окно на 1 048 576 токенов с четырьмя уровнями мышления — от low до xhigh. На Kie.ai она сейчас поддерживает только чат-запросы.

Model Type:
Pricing: Input 240 credits / 1M tokens (≈ $1.20), Cached Input 12 credits / 1M tokens (≈ $0.06), Output 1200 credits / 1M tokens (≈ $6.00) — all 60% below official pricing. High-tier top-ups come with bonus credits that lower the effective price by about 10%.

Automatically append previous messages to maintain multi-turn context. May increase token usage.

Function calling
Grounding with Google Search
Source:Google Search
Thinking process
Reasoning effort
Stream Response

How can I help you today?

README

Complete guide to using Gemini 4 Neon

Gemini 4 Neon API для сложного программирования, анализа и науки

Gemini 4 Neon принимает текст, изображения, видео, аудио и PDF и генерирует текстовые ответы. Токены ввода, рассуждения и вывода используют единое контекстное окно на 1 048 576 токенов, а максимальный объём вывода по умолчанию составляет 65 536 токенов на один синхронный ответ. Четыре уровня рассуждения — low, medium, high и xhigh — позволяют настраивать глубину анализа и расход токенов под каждую задачу.
curl https://api.kie.ai/gemini-4-neon-openai/v1/chat/completions \
-H "Authorization: Bearer $KIE_API_KEY" \
-H "Content-Type: application/json" \
-d '{
"messages": [{ "role": "user", "content": "Analyze the latency vs consistency trade-offs of multi-region consensus." }],
"reasoning_effort": "high",
"stream": false
}'
Thinking

Ключевые возможности Gemini 4 Neon

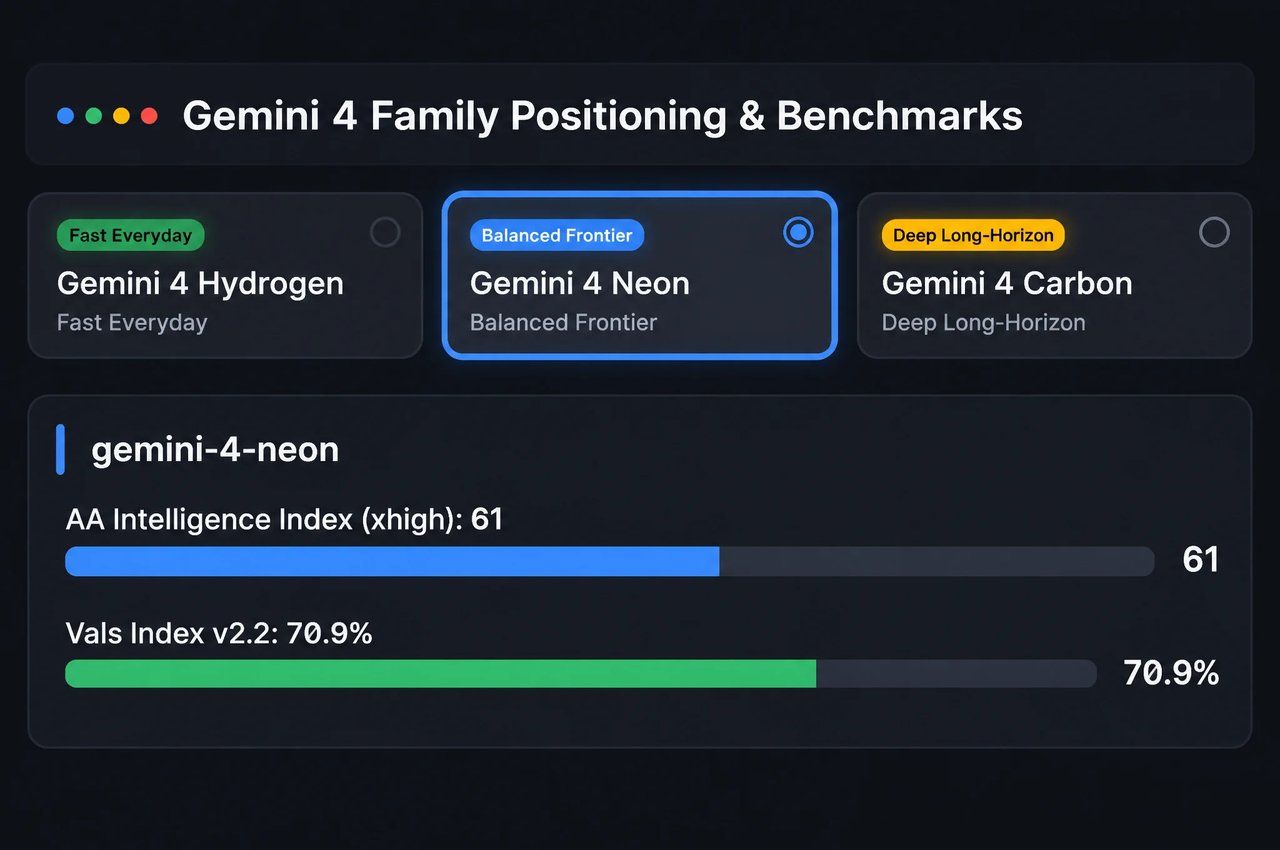
Созданная на базе Gemini 4 Carbon, модель Gemini 4 Neon занимает место между Hydrogen и Carbon в семействе Gemini 4, сочетая глубину рассуждений на уровне ведущих моделей с эффективным сквозным выполнением задач в сложной разработке ПО, аналитике, интеллектуальной работе и научных исследованиях.
Сбалансированные возможности рассуждения передового уровня в семействе Gemini 4
01

Сбалансированные возможности рассуждения передового уровня в семействе Gemini 4

В то время как Gemini 4 Carbon работает над самыми сложными долгосрочными проектами, а Gemini 4 Hydrogen обеспечивает быстрое выполнение повседневных задач, Google создала Gemini 4 Neon для баланса между глубиной рассуждений и эффективностью. По данным Google, модель набирает 61 балл (3-е место в общем зачёте) в рейтинге Artificial Analysis Intelligence Index на уровне xhigh и 70,9 % (2-е место в общем зачёте) в Vals Index v2.2.
Программирование на уровне репозитория и многофайловый рефакторинг
02

Программирование на уровне репозитория и многофайловый рефакторинг

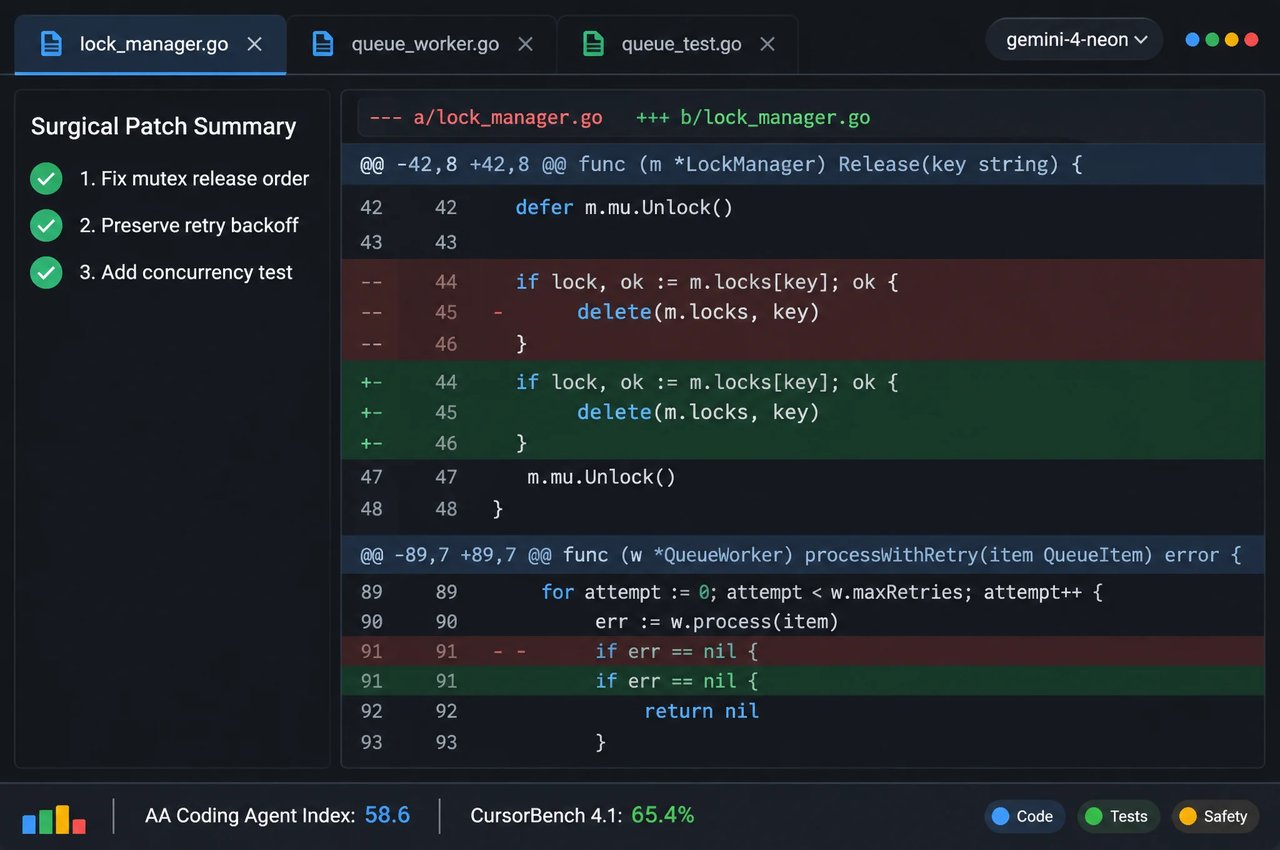
Google спроектировала Gemini 4 Neon для многофайловой отладки и рефакторинга кодовых баз с точечными правками, меньшим числом избыточных чтений файлов и надёжным сжатием контекста в длительных сессиях. По данным Google, на уровне high по умолчанию модель занимает 1-е место в AA Coding Agent Index (58,6), а также набирает 65,4 % в CursorBench 4.1, 65,2 % в Terminal-Bench 4.1 и 46,2 % в FrontierCode 2.0.
Четыре уровня рассуждения от low до xhigh
03

Четыре уровня рассуждения от low до xhigh

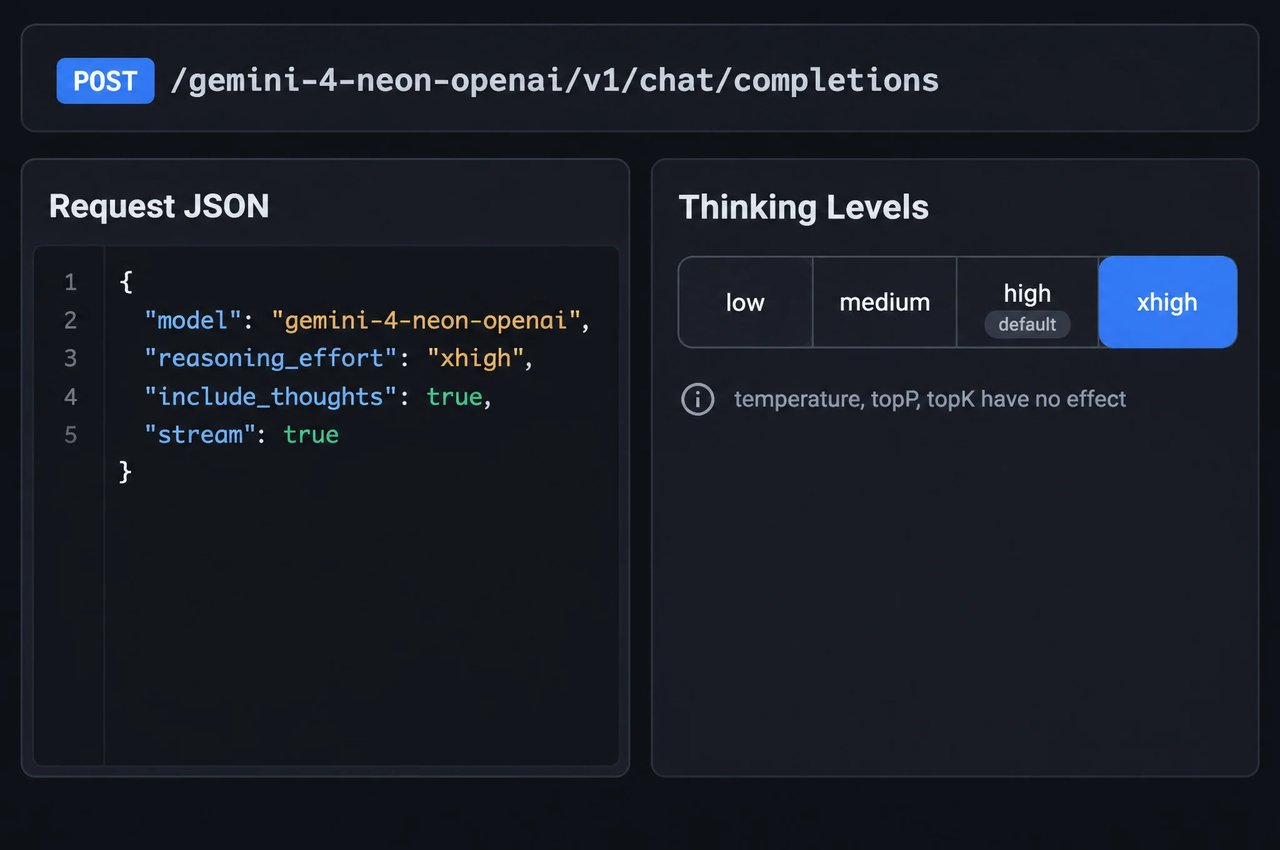
Управляйте глубиной рассуждений и расходом токенов с помощью четырёх уровней: low, medium, high (по умолчанию) и xhigh. В Kie.ai задайте reasoning_effort в OpenAI-совместимом API или generationConfig.thinkingConfig.thinkingLevel в нативном Gemini API (значение minimal игнорируется, а temperature, topP и topK не влияют на результат). Используйте high для большинства сложных задач программирования и мультимодального анализа, а xhigh оставьте для трудных многошаговых инженерных и научных проблем.
Единое мультимодальное контекстное окно на 1 млн токенов
04

Единое мультимодальное контекстное окно на 1 млн токенов

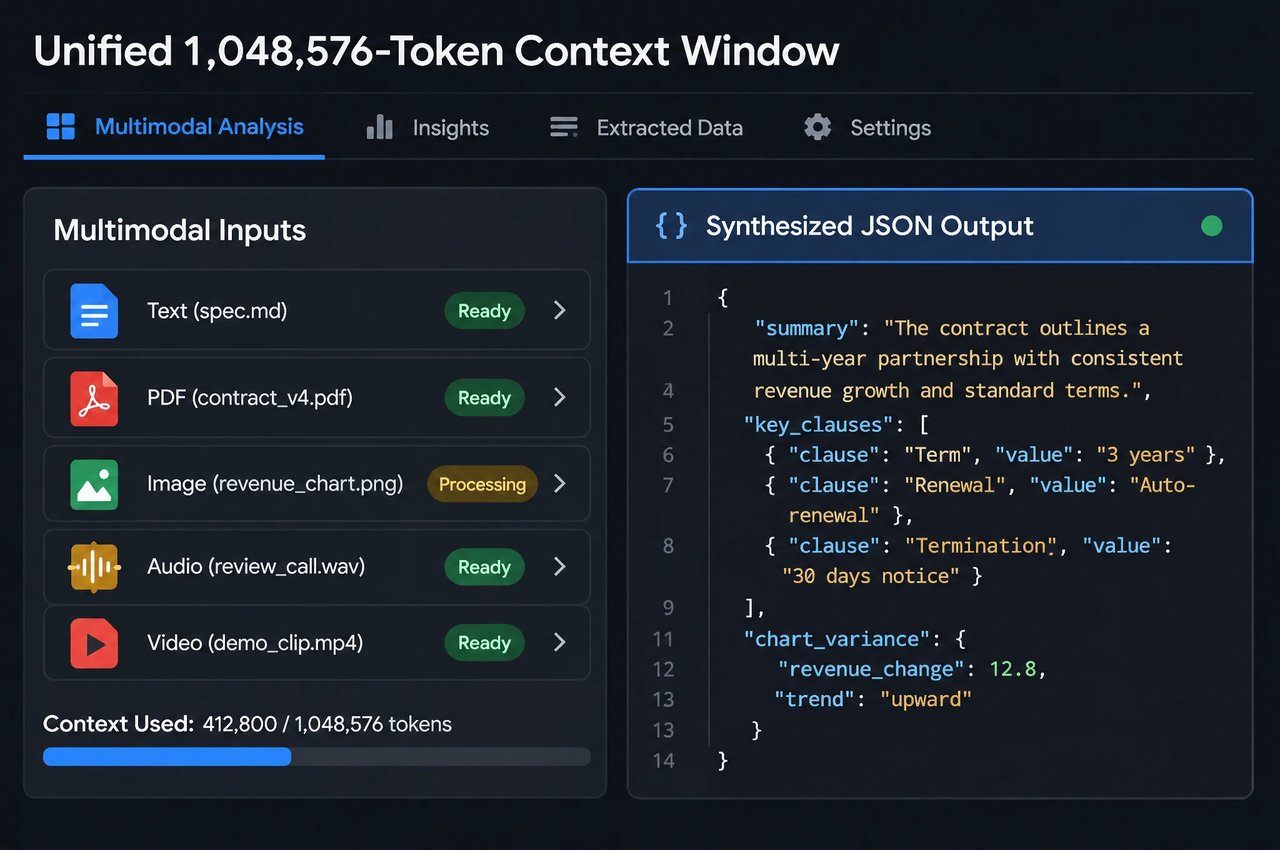
Токены ввода, рассуждения и вывода используют общее контекстное окно на 1 048 576 токенов, при этом по умолчанию на один синхронный ответ отводится до 65 536 выходных токенов с учётом токенов рассуждения. Передавайте текст и до 10 файлов изображений, видео, аудио или PDF в одном запросе для анализа договоров, насыщенных графиков и записей встреч с получением структурированного текста; эффективность работы с длинным контекстом подтверждают результаты 95,2 % в GraphWalks (от 256K до 1M) и 89,0 % в LVBench.
Аналитические, юридические и научные рабочие процессы
05

Аналитические, юридические и научные рабочие процессы

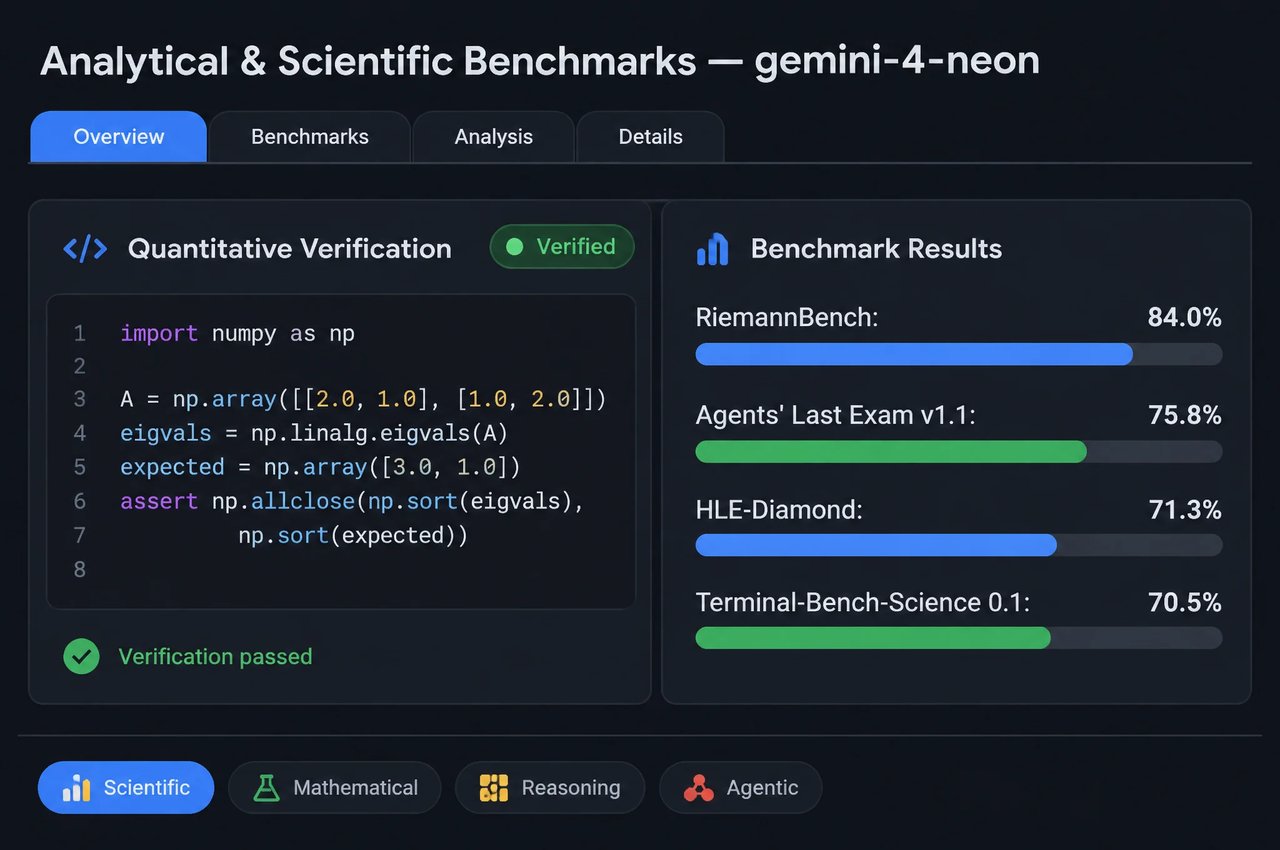
Google сообщает о 1-х местах в Legal Research Bench, Tax Agent Bench и AutomationBench от Zapier (56,3 %), а также о результатах 75,8 % в Agents' Last Exam v1.1 и 73,5 % в Chartography. В математике и научных рассуждениях Neon достигает 84,0 % в RiemannBench, 71,3 % в HLE-Diamond и 70,5 % в Terminal-Bench-Science 0.1.
Безопасная генерация кода, обоснование ответов внешними данными и инструменты
06

Безопасная генерация кода, обоснование ответов внешними данными и инструменты

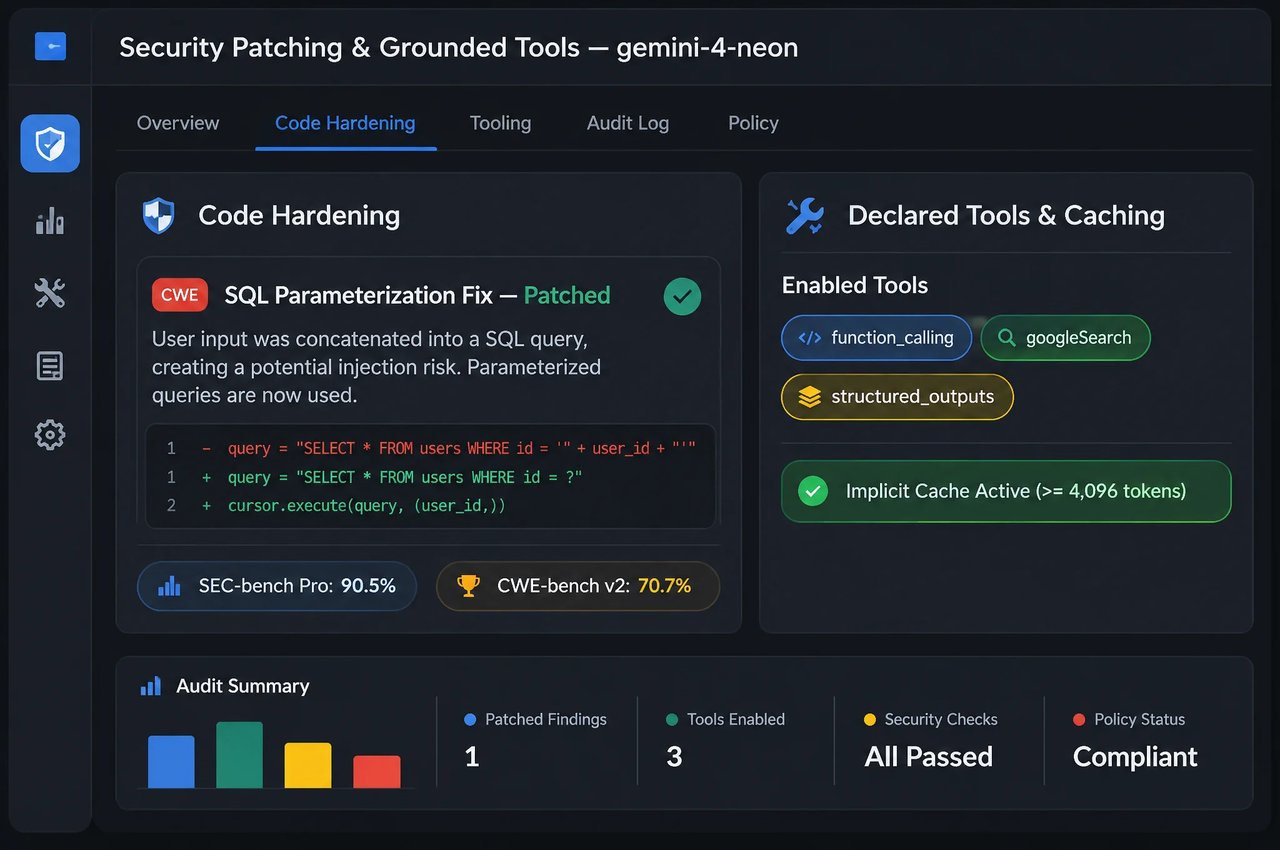
Gemini 4 Neon генерирует более безопасный код, чем Gemini 4 Carbon, в задачах лёгкого, среднего и сложного уровней в AutoBaxBench (76 % на сложном уровне), набирает 90,5 % в SEC-bench Pro и достигает 70,7 % в CWE-bench v2. Оба формата API на Kie.ai поддерживают обоснование ответов данными поиска Google (googleSearch), пользовательские объявления функций, потоковую передачу с полем credits_consumed в финальном чанке и неявное кэширование контекста.
SpecificationGemini 4 Neon
DeveloperGoogle (Google DeepMind)
Идентификаторы моделей на Kie.aigemini-4-neon-openai (OpenAI-совместимый); gemini-4-neon (нативный Gemini)
Дата выпуска18 ноября 2026 г.
Основана наGemini 4 Carbon
ModalitiesВвод текста, изображений, видео, аудио и PDF (до 10 файлов на запрос); текстовый вывод
Контекстное окно1 048 576 токенов, общих для ввода, рассуждения и вывода
Максимум выходных токеновДо 65 536 токенов на один синхронный ответ по умолчанию (токены рассуждения учитываются в объёме вывода)
Уровни рассужденияlow, medium, high (по умолчанию), xhigh через reasoning_effort или thinkingLevel (minimal игнорируется; include_thoughts / includeThoughts опциональны)
Форматы API на Kie.aiPOST /gemini-4-neon-openai/v1/chat/completions (stream default false); POST /gemini/v1/models/gemini-4-neon:streamGenerateContent (stream default true)
Инструменты и параметры на Kie.aiОпора на Google Search (googleSearch), вызов функций, JSON-схема response_format (совместимая с OpenAI), неявное кэширование (temperature, topP и topK не влияют; только для чат-запросов)
Дата отсечения знанийМарт 2026 г.
BenchmarkGemini 4 NeonЧто оценивает
AA Intelligence Index v5.0.161 (3-е место в общем зачёте, на уровне xhigh)Индекс общих возможностей
Vals Index v2.270,9 % (2-е место в общем зачёте; 1-е место в Legal Research и Tax Agent)Оценка для корпоративного сектора, юриспруденции и налогообложения
AA Coding Agent Index58,6 (1-е место в общем зачёте)Оценка навыков разработки ПО
CursorBench 4.1 / Terminal-Bench 4.165,4 % / 65,2 % (с поправкой на читинг)Работа с кодом в репозиториях и выполнение команд в терминале
FrontierCode 2.0 / SWE-sweep46,2 % (на уровне high) / 39,0 % (среда Antigravity), 12,8 % (mini-SWE)Бенчмарки разработки ПО
Agents' Last Exam v1.1 / AutomationBench75,8 % / 56,3 % (1-е место в общем зачёте)Многоэтапная интеллектуальная работа и автоматизация рабочих процессов
RiemannBench / HLE-Diamond / Terminal-Bench-Science 0.184.0% / 71.3% / 70.5%Математика и научные рассуждения
GraphWalks (от 256K до 1M, BFS F1)95.2%Поиск и логический вывод в длинном контексте
LVBench / Chartography / MKA89.0% / 73.5% / 56.5%Длинные видео, диаграммы с высокой плотностью данных и мультимодальные рассуждения
SEC-bench Pro / CWE-bench версии 2 / WebExploitBench v1.290.5% / 70.7% / 51.3%Обнаружение уязвимостей, исправление ошибок безопасности и безопасность веб-приложений

Как работать с Gemini 4 Neon

Четыре рекомендации по выбору модели, бюджетам рассуждений, мультимодальным входным данным и потоковой передаче на Kie.ai.
  1. 1

    Шаг 1. Выберите между Hydrogen, Neon и Carbon

    Используйте Gemini 4 Neon для сложных рабочих процессов в разработке ПО, аналитических рассуждениях и науке, где требуется глубина рассуждений передового уровня в сочетании с эффективным сквозным выполнением задач. Применяйте Gemini 4 Hydrogen для быстрого повседневного программирования и выполнения задач, а Gemini 4 Carbon оставьте для самых сложных долгосрочных проектов.
  2. 2

    Шаг 2. Начните с уровня high и оставьте xhigh для сложных задач

    По умолчанию на Kie.ai установлен уровень размышлений high. Установите параметр reasoning_effort (OpenAI-совместимый) или generationConfig.thinkingConfig.thinkingLevel (нативный) в значение medium или low для экономии токенов на простых промптах либо xhigh — для сложных многошаговых инженерных, аналитических и научных задач. Не задавайте параметры temperature, topP и topK, так как они не влияют на Gemini 4.
  3. 3

    Шаг 3. Оставьте запас для токенов размышлений и выходных токенов

    Входные токены, токены размышлений и выходные токены делят общее окно на 1 048 576 токенов, а бюджет вывода по умолчанию в 65 536 токенов включает как размышления, так и видимый текст ответа. При решении сложных задач с уровнем xhigh учитывайте, что более глубокие размышления потребляют больший объём этого общего бюджета вывода, и передавайте до 10 медиафайлов на запрос.
  4. 4

    Шаг 4. Используйте Grounding, инструменты вызова функций и кэширование префиксов

    Включайте googleSearch, когда для ответа нужны актуальные данные из интернета после марта 2026 года, определяйте собственные инструменты на основе функций в любом из эндпоинтов или передавайте JSON-схему в response_format при работе с OpenAI-совместимым эндпоинтом. Сохраняйте общие префиксы промптов неизменными между шагами диалога, чтобы повторяющийся контекст тарифицировался по цене кэшированного ввода.

Что можно создавать с помощью Gemini 4 Neon

Google позиционирует Gemini 4 Neon как решение для сложного программирования, аналитических рассуждений и науки. На Kie.ai модель сейчас поддерживает только чат-запросы, поэтому приведённые ниже сценарии выполняются через чат.

Многофайловая отладка и рефакторинг кодовой базы

Диагностируйте межмодульные ошибки, проверяйте пул-реквесты и генерируйте точечные многофайловые правки в крупных кодовых базах, затрагивая только нужные файлы.

Обобщение юридических, налоговых и финансовых документов

Обобщайте договоры, регуляторную отчётность, выписки по счетам, диаграммы и записи встреч — в виде текста, изображений, видео, аудио или PDF — в рамках общего контекста на 1 048 576 токенов, формируя структурированные отчёты или JSON.

Научный и количественный анализ

Прорабатывайте математические доказательства, задачи количественного моделирования, планирования экспериментов и технических исследований с настраиваемым уровнем рассуждений high или xhigh.

Защитная проверка кода и устранение уязвимостей

Используйте Gemini 4 Neon, чтобы генерировать более безопасный код, проверять репозитории на уязвимости и предлагать исправления, устраняющие первопричины проблем CWE.

Gemini 4 Neon на Kie.ai

01

Быстрый старт с Gemini 4 Neon API

Протестируйте Gemini 4 Neon в песочнице на этой странице или отправьте POST-запрос на https://api.kie.ai/gemini-4-neon-openai/v1/chat/completions с полем messages либо на https://api.kie.ai/gemini/v1/models/gemini-4-neon:streamGenerateContent с полем contents, передав заголовок Authorization: Bearer YOUR_API_KEY. Установите для reasoning_effort или thinkingLevel значение low, medium, high или xhigh. На Kie.ai эта модель сейчас поддерживает только чат-запросы и ещё не адаптирована для работы в агентах; подключение её к агенту может привести к ошибкам запросов или непредсказуемым результатам.
03

Один ключ для всего маркетплейса Kie.ai

Все модели на маркетплейсе Kie.ai используют один и тот же способ аутентификации — заголовок Authorization: Bearer YOUR_API_KEY с ключом со страницы управления API-ключами Kie.ai.
04

Кредиты с оплатой по мере использования

На Kie.ai действует оплата по мере использования без подписок: все модели расходуют единый бессрочный баланс кредитов, за неуспешные запросы средства не списываются, а проверить баланс можно через API получения остатка кредитов.

Часто задаваемые вопросы

Что такое Gemini 4 Neon?

Gemini 4 Neon (gemini-4-neon) — это модель семейства Gemini 4 от Google для сложных рабочих процессов в разработке ПО, аналитических рассуждениях, интеллектуальной работе и науке, выпущенная 18 ноября 2026 года и адаптированная на базе Gemini 4 Carbon. На Kie.ai она сейчас поддерживает только чат-запросы.

Чем Gemini 4 Neon отличается от Gemini 4 Hydrogen и Gemini 4 Carbon?

Google позиционирует Gemini 4 Neon между Gemini 4 Hydrogen и Gemini 4 Carbon. Hydrogen отвечает за быстрое повседневное программирование и выполнение задач, Carbon справляется с самыми сложными долгосрочными проектами, а Neon сочетает глубину рассуждений передового уровня с эффективным сквозным выполнением задач.

Каковы лимиты контекстного окна и выходных токенов у Gemini 4 Neon?

В Gemini 4 Neon предусмотрено единое контекстное окно на 1 048 576 токенов, общее для входных токенов, токенов размышлений и выходных токенов. Согласно карточке модели от Google, лимит по умолчанию составляет до 65 536 выходных токенов на синхронный ответ, а актуальность знаний ограничена мартом 2026 года.

Какие входные и выходные модальности поддерживает Gemini 4 Neon?

Модель принимает текст и до 10 медиафайлов на запрос — изображения, видео, аудио и PDF (передаваемые через единую структуру image_url в OpenAI-совместимом эндпоинте или через inline_data / file_data в нативном эндпоинте) — и возвращает текст. Генерация изображений, генерация аудио и Live API не поддерживаются.

Какие уровни мышления поддерживает Gemini 4 Neon?

Gemini 4 Neon поддерживает четыре уровня мышления: low, medium, high (по умолчанию) и xhigh. Укажите reasoning_effort в OpenAI-совместимом API или generationConfig.thinkingConfig.thinkingLevel в нативном Gemini API, а для возврата рассуждений используйте include_thoughts или includeThoughts. На Kie.ai режим minimal игнорируется, а параметры temperature, topP и topK не влияют на результат.

Как работает кэширование контекста в Gemini 4 Neon?

Неявное кэширование контекста запускается автоматически, когда повторяющиеся запросы содержат неизменный префикс промпта (по документации Google минимум составляет 4 096 токенов), а кэшированные входные токены тарифицируются по ставке для кэшированных входных токенов на Kie.ai.

Может ли Gemini 4 Neon использовать инструменты и Grounding with Google Search?

Да. Оба эндпоинта на Kie.ai поддерживают Grounding with Google Search (googleSearch), чтобы ответы могли ссылаться на актуальные веб-источники, а также пользовательские объявления функций (и JSON-схемы response_format в OpenAI-совместимом эндпоинте).

Как вызвать Gemini 4 Neon API на Kie.ai?

Создайте API-ключ на странице управления API-ключами Kie.ai и передайте его в заголовке Authorization: Bearer YOUR_API_KEY. Отправьте POST-запрос на /gemini-4-neon-openai/v1/chat/completions для формата, совместимого с OpenAI, или на /gemini/v1/models/gemini-4-neon:streamGenerateContent для нативного формата Gemini; при потоковой передаче финальный чанк SSE включает метаданные использования и credits_consumed перед data: [DONE]. Эта модель сейчас поддерживает только чат-запросы и ещё не адаптирована для агентского использования. См. документацию по OpenAI-совместимому и нативному Gemini API.

Как тарифицируется Gemini 4 Neon на Kie.ai?

Gemini 4 Neon тарифицируется за миллион токенов по входным, кэшированным входным и выходным токенам; токены мышления учитываются в расходе выходных токенов, а ставки одинаковы для обоих эндпоинтов. Неуспешные запросы не оплачиваются, а кредиты никогда не сгорают. Актуальные ставки за миллион токенов указаны на карточке тарифов на этой странице.