01
Транскрибация на 40 языках
NVIDIA делит свои 40 языков транскрибации на три категории: 13 ведущих, 15 готовых к продакшену и 12 поддерживаемых. Модель может автоматически определять язык речи.
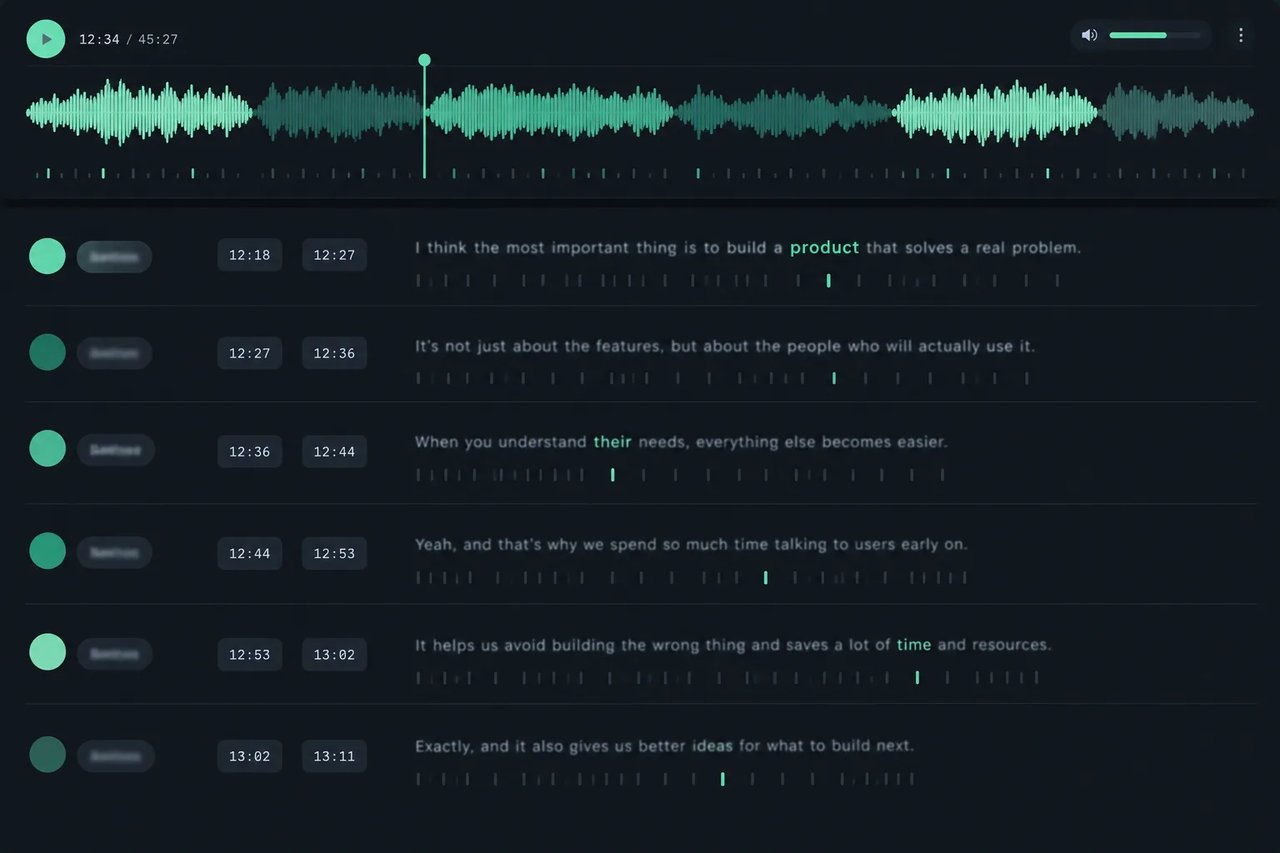
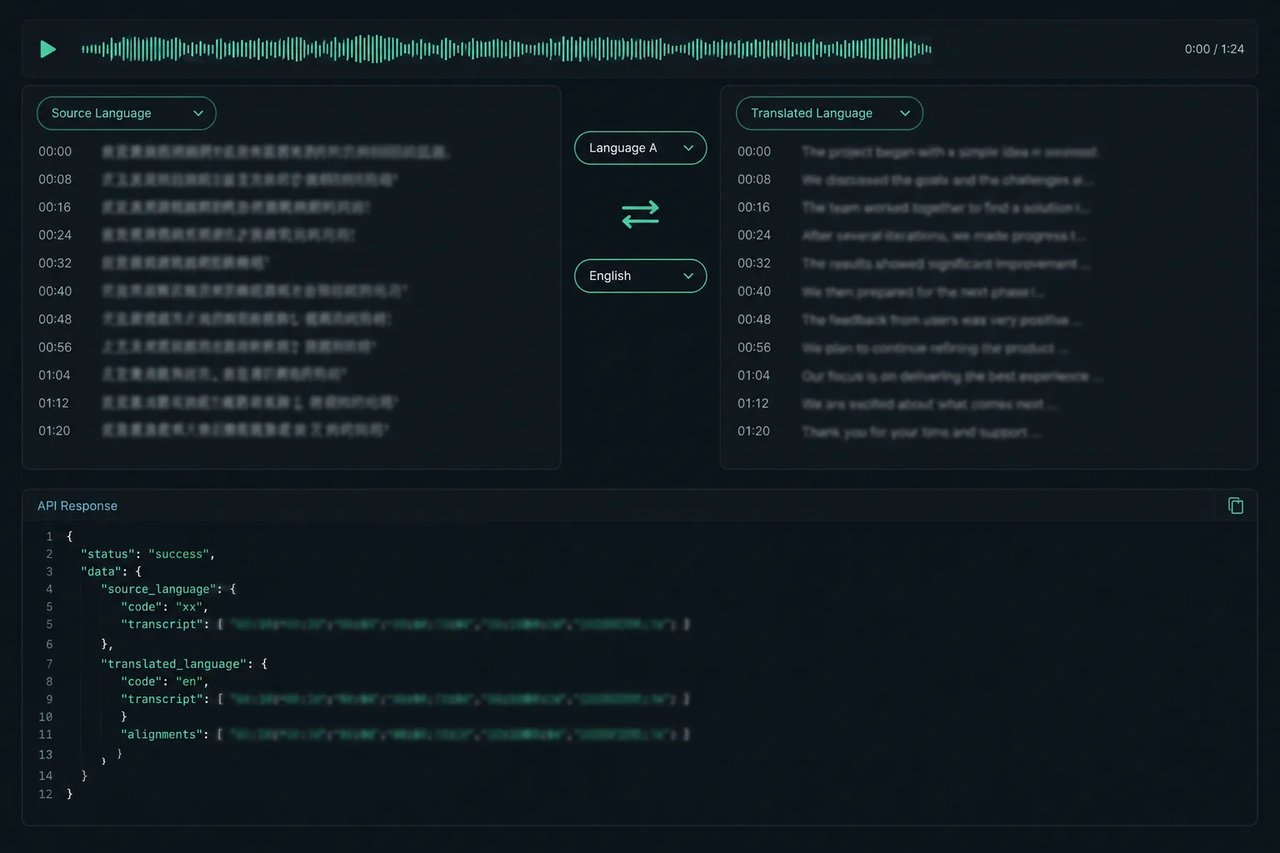
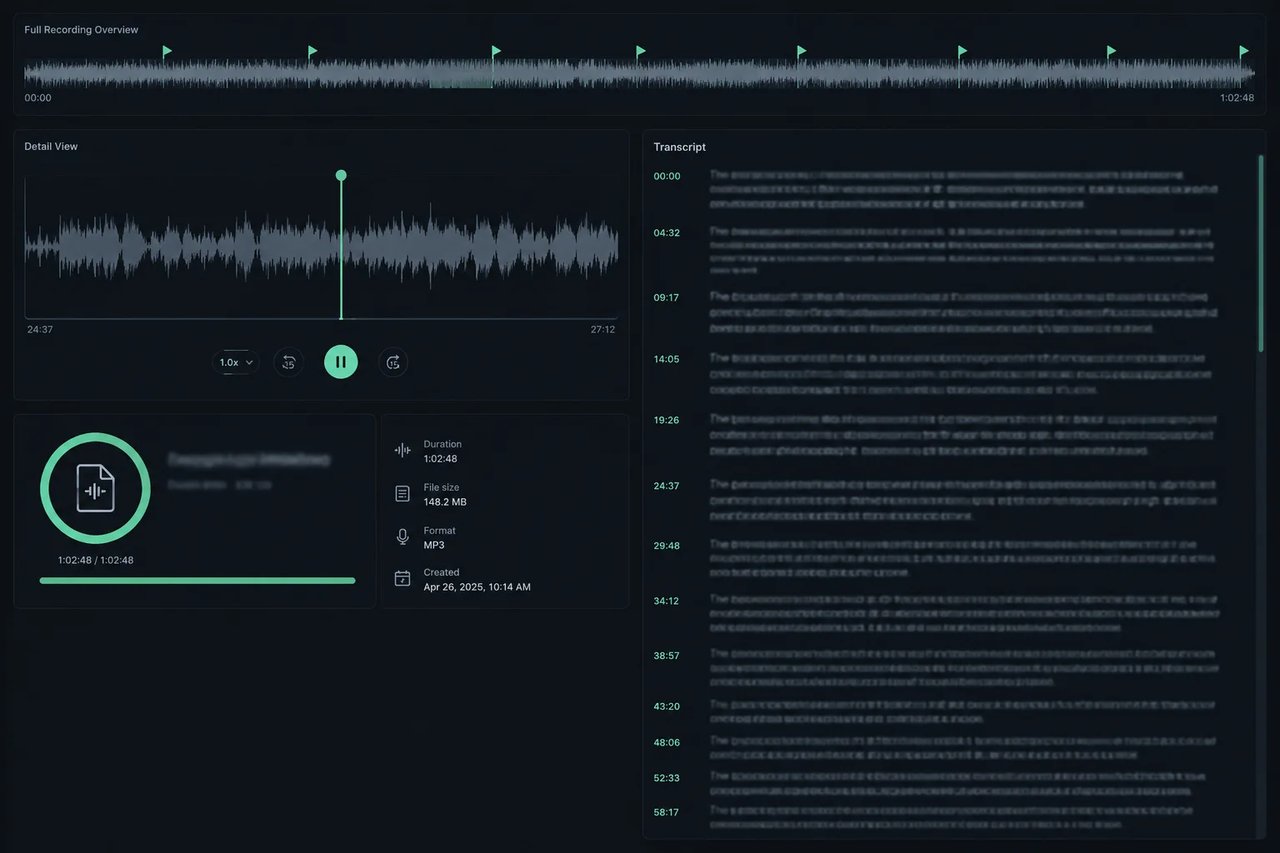
Созданная NVIDIA для распознавания речи модель Nemotron 3.5 Transcribe может возвращать транскрипт, пословные timestamps, метки дикторов и перевод речи между английским и 31 языком в одном запросе к API на Kie.ai.
Click to upload or drag and drop
Supported formats: MP4, QUICKTIME, WEBM Maximum file size: 200MB; Supported formats: MPEG, WAV, X-WAV, AAC, MP4, OGG, FLAC, OPUS Maximum file size: 200MB
Audio to transcribe: a publicly downloadable URL. Common formats work (MP3, WAV, M4A/AAC, FLAC, OGG/Opus, WEBM), and so do videos with an audio track (MP4, MOV); only the sound is used. Up to 60 minutes and 200 MB per file. The language is detected automatically.
Also return word-level start and end times and speaker labels in the result file. Transcription only: not available together with target_language. The example output was produced with timestamps on and lists only the first 40 words; the API result file contains every word.
Leave empty (default) to transcribe in the spoken language. Pick a language to translate the speech into it instead. Translation is guaranteed between English and the other listed languages: non-English speech into English (en), or English speech into another language.
Complete guide to using nvidia/nemotron-3-5-transcribe
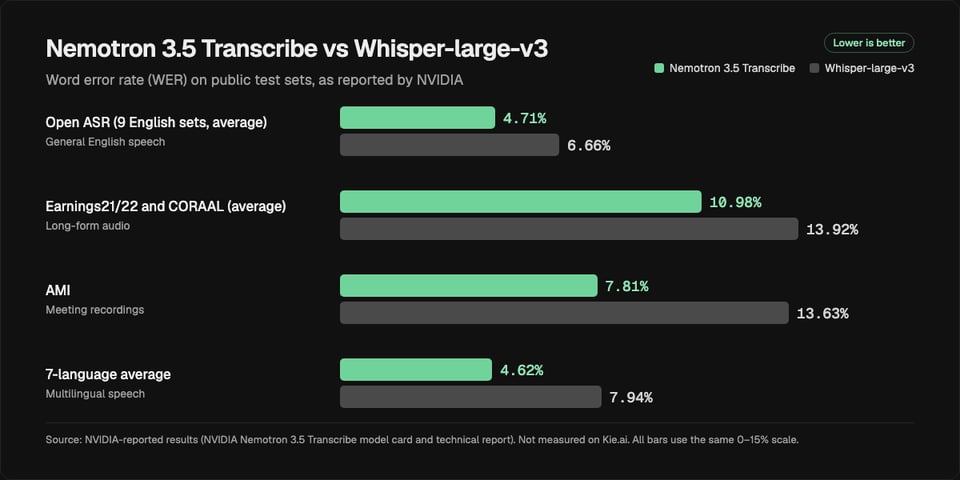
| Тестовый набор | Что охватывает | Nemotron 3.5 Transcribe | Whisper-large-v3 |
|---|---|---|---|
| Open ASR (9 англоязычных наборов, среднее) | Общая английская речь | 4.71% | 6.66% |
| Earnings21/22 и CORAAL (среднее) | Длинные аудиозаписи | 10.98% | 13.92% |
| AMI | Записи совещаний | 7.81% | 13.63% |
| Среднее по 7 языкам | Многоязычная речь | 4.62% | 7.94% |