Automatically append previous messages to maintain multi-turn context. May increase token usage.
How can I help you today?
README
Complete guide to using grok-4-7
API Grok 4.7 — Разрабатывайте на базе xAI Grok 4.7 на Kie AI
Получите доступ к API Grok 4.7 на Kie AI для продвинутого программирования, логических рассуждений, агентных рабочих процессов и профессиональной интеллектуальной работы. Попробуйте Grok 4.7 бесплатно со стартовыми бонусами и интегрируйте модель в свои приложения благодаря гибкой тарификации API.
Оцените возможности API Grok 4.7 на платформе Kie AI
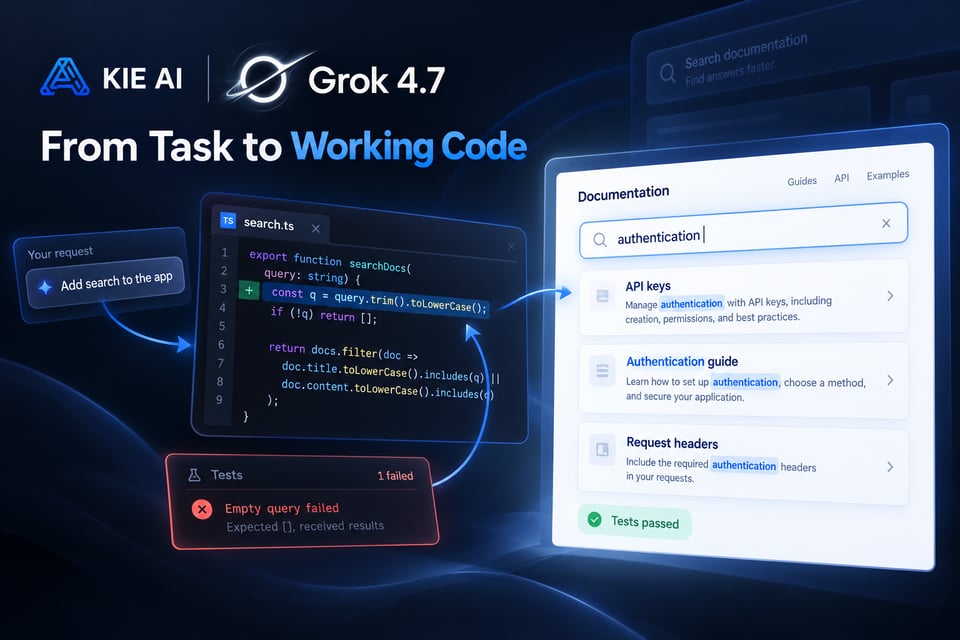
Решайте многоэтапные задачи с помощью API Grok 4.7
Используйте API Grok 4.7 для задач, требующих множества шагов и глубоких логических рассуждений. Модель Grok 4.7 обучалась на более сложном наборе задач с акцентом на задачи, требующие длительного выполнения. Такая архитектура поддерживает рабочие процессы, включая многоэтапное программирование, исследования, аналитику и выполнение задач ИИ-агентами.
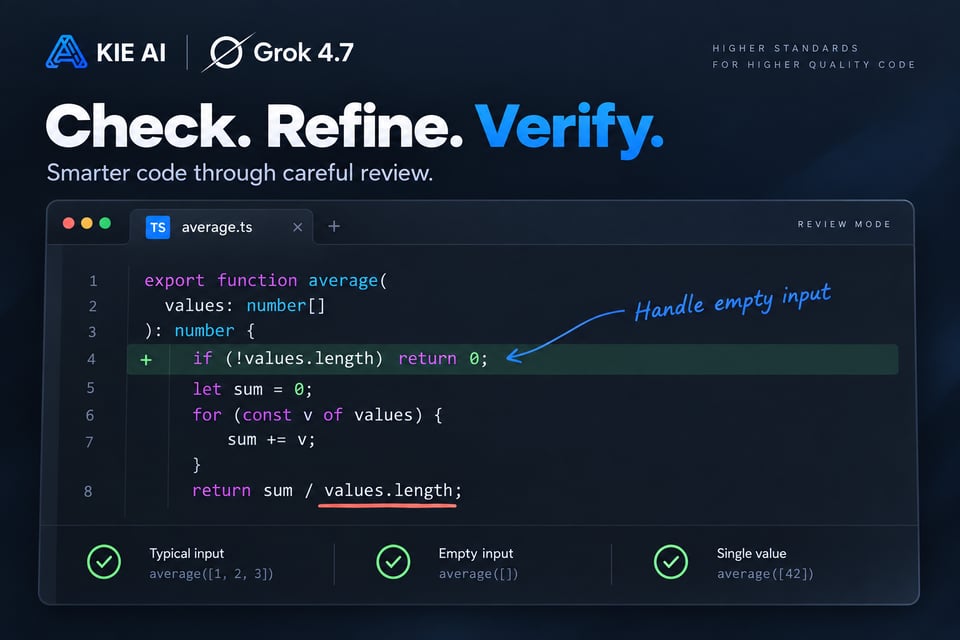
Оцените усиленную самопроверку с xAI Grok 4.7
Оптимизируйте сложные рабочие процессы с помощью модели, которая более тщательно проверяет собственные результаты. xAI Grok 4.7 обладает улучшенными возможностями самопроверки, помогая эффективнее анализировать промежуточные результаты и решать сложные задачи. С помощью API Grok 4.7 разработчики могут применять эту возможность в программировании, исследованиях, аналитике и других многоэтапных задачах, где критически важны точность и согласованность.
Создавайте продвинутые процессы разработки с API Grok 4.7
Используйте API Grok 4.7 для сложных задач разработки ПО: от генерации и отладки кода до анализа репозиториев и длительных циклов разработки. В ключевых бенчмарках по разработке ПО Grok 4.7 демонстрирует более высокие результаты, чем Grok 4.6, что делает его отличным выбором для ИИ-ассистентов программиста, инструментов разработчика и агентных приложений для работы с кодом.

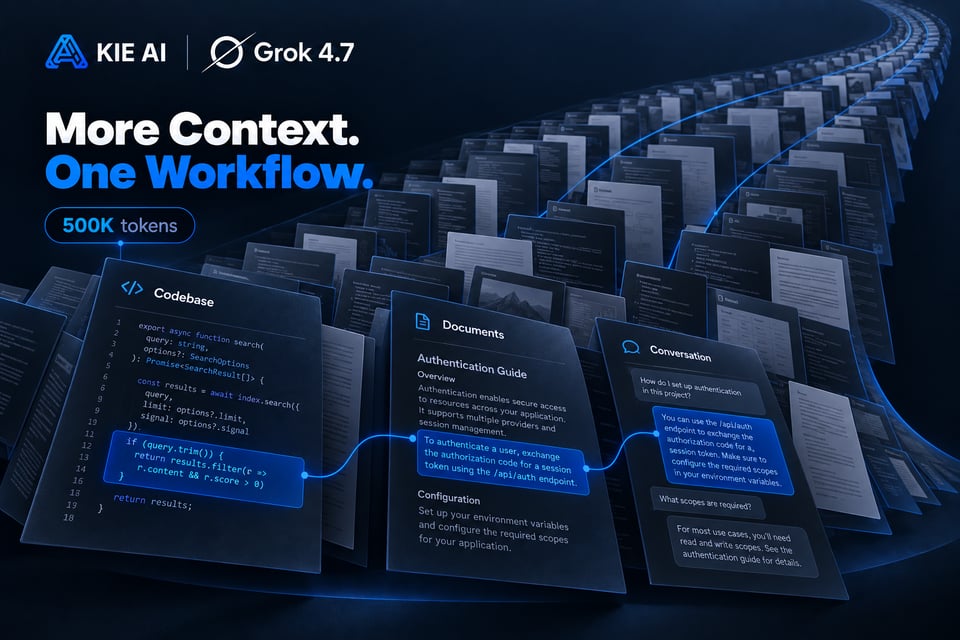
Обрабатывайте больше данных с контекстным окном API Grok в 500K токенов
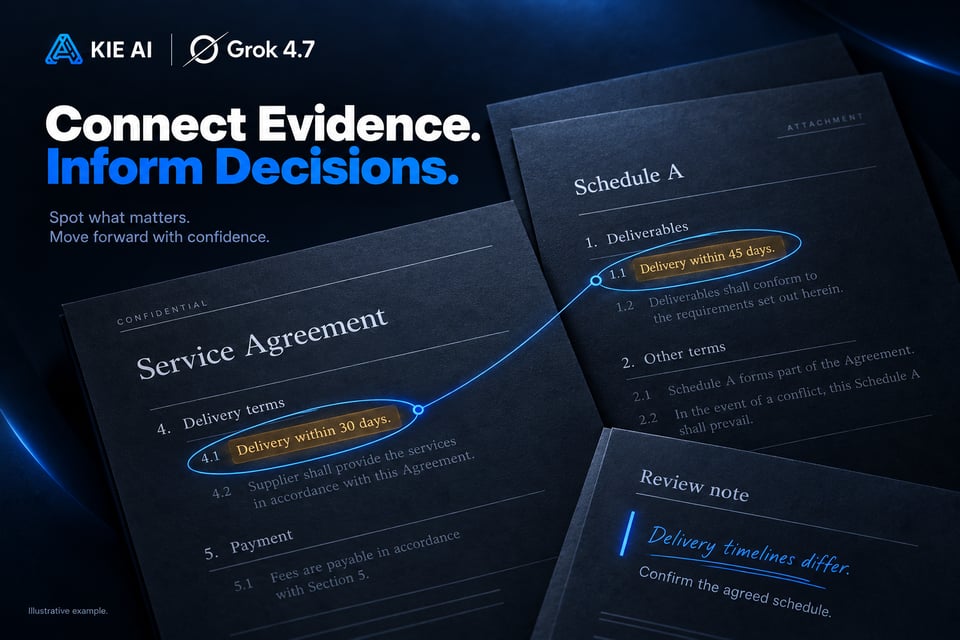
Используйте до 500 000 токенов контекста в рамках одной сессии Grok 4.7. Большое контекстное окно помогает API Grok 4.7 обрабатывать крупные базы кода, длинные документы, детальные инструкции и обширную историю диалогов. Разработчики могут передавать модели больше релевантного контекста, не разбивая сложные входные данные на множество мелких запросов.
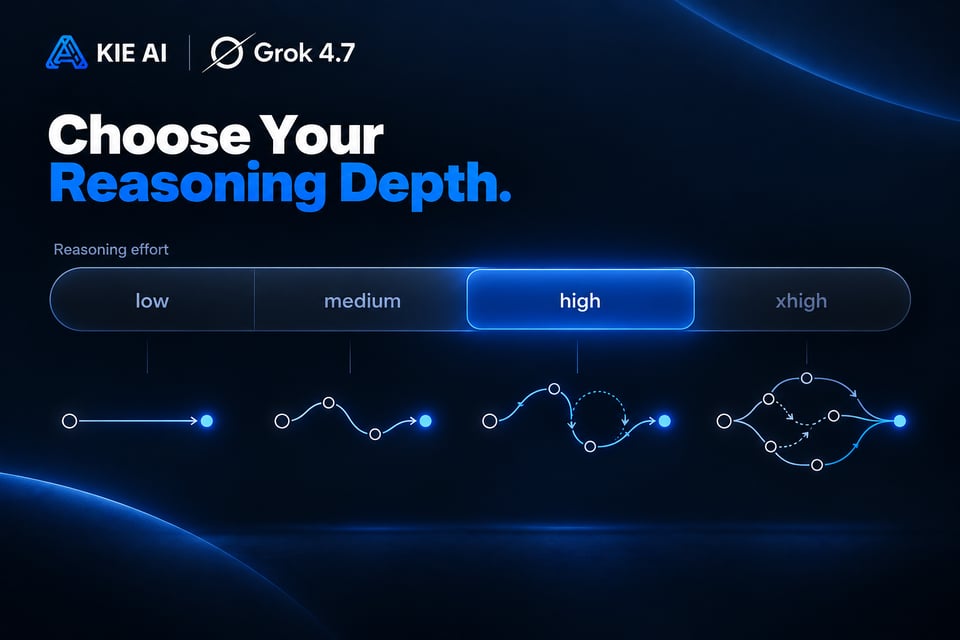
Управляйте глубиной рассуждений Grok 4.7 с помощью четырех уровней анализа
Настраивайте глубину рассуждений под потребности каждого приложения. API Grok 4.7 поддерживает несколько уровней глубины рассуждений (low, medium, high и xhigh), предоставляя разработчикам гибкий контроль над тем, насколько глубоко модель анализирует проблему. Используйте низкий уровень для простых задач или там, где важна минимальная задержка, и высокий — когда вашим рабочим процессам на базе API Grok требуется глубокий анализ и многоэтапная логика.
Решайте профессиональные интеллектуальные задачи с Grok 4.7
Применяйте API Grok 4.7 не только для программирования, но и для сложных профессиональных задач. Модель Grok 4.7 демонстрирует рост показателей в бенчмарках, охватывающих многочасовые офисные задачи, электротехнику, юриспруденцию и другие задачи с высокой интеллектуальной нагрузкой. Используйте API Grok 4.7 на платформе Kie AI для проведения исследований, анализа документов, рабочих процессов с профессиональным контентом и создания SaaS-инструментов, требующих глубокого логического анализа специализированной информации.
Тестирование производительности API Grok 4.7
Высокие результаты в программировании и решении профессиональных задач
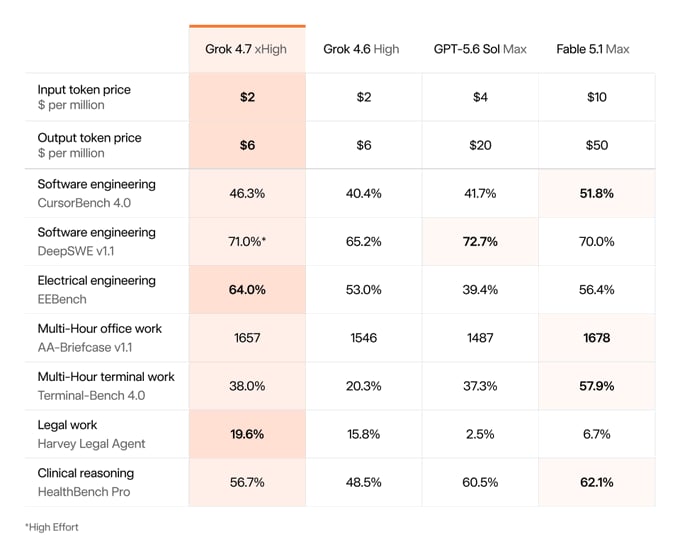
Согласно результатам бенчмарков, опубликованным SpaceXAI, Grok 4.7 набирает 46,3% в CursorBench 4.0, 71,0% в DeepSWE v1.1 при высоком уровне глубины рассуждений, 64,0% в EEBench и 1657 баллов в AA Briefcase v1.1. Эти тесты оценивают различные области, включая разработку ПО, многоэтапные задачи по программированию, электротехнику и профессиональные офисные задачи.
Сравнение Grok 4.7 и Grok 4.6: что изменилось?
По сравнению с Grok 4.6, Grok 4.7 использует новую, более масштабную базовую модель и более длительный цикл обучения с подкреплением, ориентированный на сложные и продолжительные задачи. Улучшенные механизмы проверки собственных ответов и работы с длинным контекстом позволяют API Grok 4.7 эффективнее справляться с написанием кода, проектированием, профессиональной интеллектуальной работой и другими комплексными процессами. Официальные бенчмарки подтверждают превосходство Grok 4.7 во всех семи тестах, представленных ниже.
| Бенчмарк | Grok 4.7 | Grok 4.6 |
|---|---|---|
| CursorBench 4.0 | 46.3% | 40.4% |
| DeepSWE v1.1 | 71.0%* | 65.2% |
| EEBench | 64.0% | 53.0% |
| AA Briefcase v1.1 | 1,657 | 1,546 |
| Terminal-Bench 4.0 | 38.0% | 20.3% |
| Harvey Legal Agent Benchmark | 19.6% | 15.8% |
| HealthBench Professional | 56.7% | 48.5% |
| Результат Grok 4.7 в тесте DeepSWE v1.1 получен с интенсивным использованием логики (high reasoning effort). Данные основаны на бенчмарках, предоставленных SpaceXAI. |
Как использовать API Grok 4.7 в Kie AI
Шаг 1: Попробуйте Grok 4.7 бесплатно в песочнице (Playground)
Шаг 2: Получите API-ключ Grok 4.7
Шаг 3: Отправьте свой первый API-запрос к Grok 4.7
Шаг 4. Интеграция API Grok 4.7 в ваше приложение
Создавайте мощные ИИ-приложения с помощью API Grok 4.7 на платформе Kie AI
Создавайте ИИ-агентов для работы с кодом на базе API Grok 4.7
Создавайте ИИ-помощников для написания кода, ассистентов по отладке, инструменты код-ревью и автономных агентов для разработки с помощью API Grok 4.7. Наделите свои приложения способностью понимать код, решать сложные инженерные задачи и справляться с длительными задачами по разработке. Grok API идеально подходит для продуктов для разработчиков, которым нужно нечто большее, чем базовое автодополнение кода.
Создавайте ИИ-ассистентов для SaaS на базе xAI Grok 4.7
Внедрите xAI Grok 4.7 в SaaS-продукты, сервисы для повышения продуктивности, внутренние инструменты и клиентские ИИ-функции. Используйте API Grok 4.7 для создания ассистентов, способных понимать детальные запросы, решать сложные задачи и помогать пользователям в многоэтапных рабочих процессах.
Анализируйте объемные документы с помощью API Grok 4.7
Создавайте приложения для работы с объемными документами и входными данными с широким контекстом. Благодаря контекстному окну в 500 тыс. токенов API Grok 4.7 поддерживает рабочие процессы, включающие отчеты, техническую документацию, контракты, исследовательские материалы и большие массивы текстов. Это делает его полезным для анализа и обобщения документов, извлечения информации и ответов на вопросы.
Автоматизируйте профессиональные задачи с помощью API Grok
Используйте API Grok 4.7 для автоматизации интеллектуальных задач в профессиональных рабочих процессах. Создавайте инструменты для создания документов, аналитики, составления отчетов, исследований и других задач, требующих глубокого и последовательного анализа. Разработчики могут интегрировать API Grok во внутренние системы или SaaS-продукты, чтобы сократить объем рутинной работы, сохраняя сложную информацию в контексте.
Усильте исследовательские приложения с помощью xAI Grok 4.7
Создавайте ИИ-ассистентов для исследований и приложения для работы со знаниями, способные детально обрабатывать информацию и находить взаимосвязи в больших объемах входных данных. API Grok 4.7 поддерживает обобщение исследовательских данных, ответы на вопросы, глубокое изучение документов и интеллектуальные рабочие процессы, где пользователям недостаточно простого сгенерированного ответа.
Создавайте ИИ-агентов с поддержкой внешних инструментов на базе API Grok 4.7
Создавайте ИИ-агентов, способных переходить от рассуждений к действиям. Интегрируйте API Grok 4.7 с вызовом функций, структурированным выводом, внешними API, базами данных и прикладными инструментами для создания агентов, способных выполнять реальные рабочие процессы. Используйте это для SaaS-автоматизации, ИИ-агентов для разработчиков, исследовательских систем и других приложений, которым необходимо взаимодействовать с инструментами за пределами самой модели.
Сравнение Grok 4.7, Fable 5.1 и GPT-6 Astra
Grok 4.7 против Fable 5.1: программирование и многоэтапные задачи
Обе модели ориентированы на решение сложных задач программирования и многоэтапные рабочие процессы. По данным SpaceXAI, результат Grok 4.7 в тесте DeepSWE v1.1 (в режиме high effort) составляет 71,0% против 70,0% у Fable 5.1. При этом Fable лидирует в ряде других бенчмарков для программирования и профессиональных задач. Независимое тестирование от Artificial Analysis также относит обе модели к числу лидеров для задач ИИ-агентов.
Grok 4.7 против GPT-6 Astra: производительность, эффективность и стоимость
Независимое тестирование демонстрирует разный баланс характеристик этих двух моделей. В рейтинге Intelligence Index от Artificial Analysis модель GPT-6 Astra Max набирает 53 балла, а Grok 4.7 xHigh — 46. При этом Grok 4.7 показывает более высокие результаты в ряде тестов на выполнение многоэтапных профессиональных задач и предлагает более низкую стоимость за токен.Платформа Kie AI поддерживает Grok 4.7, Fable 5.1, GPT-6 Astra и другие передовые модели через единую API-платформу, что упрощает тестирование и выбор моделей для различных рабочих нагрузок.
Почему стоит выбрать Kie AI для работы с API Grok 4.7
Доступ к нескольким API Grok в одном месте
Выйдите за рамки возможностей API Grok 4.7 с единой платформой для различных моделей и функций Grok. Kie AI открывает одновременный доступ к языковым моделям Grok, генерации изображений Grok и API Grok Imagine. Создавайте текстовые, графические и мультимодальные рабочие ИИ-процессы без необходимости переключаться между платформами.
Попробуйте Grok 4.7 бесплатно с кредитами для новых пользователей
Новым пользователям Kie AI начисляются бесплатные кредиты для старта. Используйте их, чтобы бесплатно протестировать Grok 4.7 в онлайн-песочнице, проверить реальные промпты и изучить возможности модели до перехода на платное использование. Когда вы будете готовы к разработке, то сможете перейти от тестирования напрямую к API Grok 4.7.
Доступные цены на API Grok 4.7
Сохраняйте гибкость расходов на API благодаря доступной тарификации по мере использования. Kie AI позволяет оплачивать API исходя из ваших фактических потребностей. Это делает API Grok 4.7 практичным решением для раннего тестирования, растущих SaaS-продуктов и масштабных рабочих нагрузок в продакшене без лишних авансовых платежей.
Простая интеграция API Grok с понятной документацией
Начните разработку без сложных настроек. Kie AI предоставляет понятную документацию по API и простой процесс интеграции, помогая разработчикам подключать API Grok 4.7 к SaaS-продуктам, ИИ-агентам, инструментам разработки и бэкенд-сервисам с меньшими усилиями.
Используйте самые актуальные версии API Grok
Продолжайте разработку с библиотекой моделей, которая развивается вместе с экосистемой ИИ. Kie AI постоянно добавляет новые и обновленные модели, интегрируя новейшие API Grok по мере их появления. Получите доступ к API Grok 4.7 и будущим моделям Grok в одном месте, чтобы тестировать новые возможности и быстрее внедрять их в свои приложения.
Получите круглосуточную поддержку интеграции API Grok
Получайте помощь в любое время благодаря круглосуточной службе поддержки. Если у вас возникли вопросы по API Grok 4.7, использованию аккаунта, оплате или проблемам с интеграцией, служба поддержки Kie AI всегда на связи, чтобы обеспечить бесперебойный процесс разработки.