Automatically append previous messages to maintain multi-turn context. May increase token usage.
How can I help you today?
README
Complete guide to using claude-opus-4-6
Kosteneffiziente Claude Opus 4.6 API auf Kie.ai
Zugriff auf die Anthropic Claude Opus 4.6 API über Kie.ai: Optimiert für Coding, Reasoning und Long-Context Workflows bei kosteneffizienterem Deployment.
Was ist neu bei der Anthropic Claude Opus 4.6 API
Leistungsfähigeres Coding, Debugging und Code-Review mit der Claude Opus 4.6 API
Die Claude Opus 4.6 API bietet ein deutliches Upgrade in der Software-Engineering-Performance. Sie bewältigt Coding-Aufgaben mit besserer Planung, erhöht die Debugging-Genauigkeit und führt Code-Reviews bei größeren und komplexeren Codebasen zuverlässiger durch. Im Vergleich zu früheren Opus-Modellen erkennt Claude Opus 4.6 Fehler besser, hinterfragt seine Schlussfolgerungen und hält die Qualität auch in mehrstufigen Entwicklungsprozessen hoch.
1-Million-Token-Kontextfenster für die Claude Opus 4.6 API
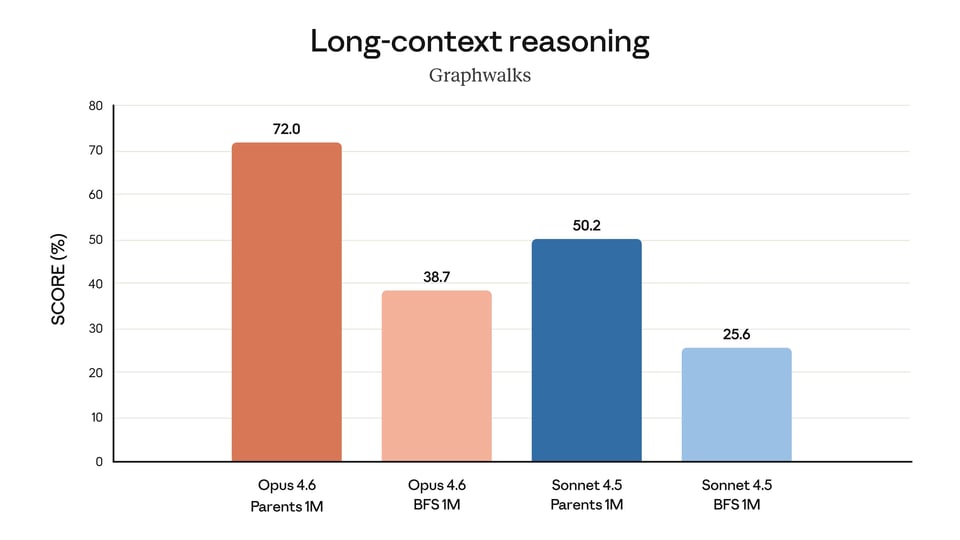
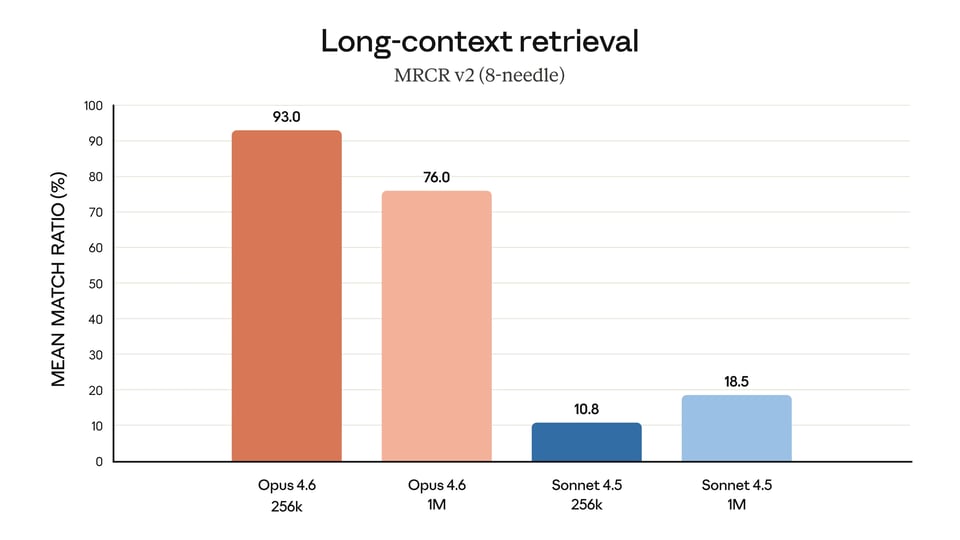
Eines der wichtigsten Updates in der Claude Opus 4.6 API ist die Einführung eines Kontextfensters von 1 Million Token (Beta). Dies verschafft der Claude Opus 4.6 API eine deutlich stärkere Basis für die Verarbeitung langer Dokumente, umfangreiche Kontextabrufe und erweitertes Reasoning bei komplexen Eingaben. Das Update minimiert Context Drift und verbessert die Leistung bei Aufgaben, die das Nachverfolgen von Informationen über sehr große Textmengen erfordern.
Adaptive Thinking, Effort Controls und Context Compaction in der Claude Opus 4.6 API
Die Claude Opus 4.6 API bietet neue Steuerungsoptionen, die das Modell für den Produktionseinsatz noch praktischer machen. Adaptive Thinking ermöglicht es der API, bei Bedarf tiefergehendes Reasoning anzuwenden, während Effort Controls Entwicklern mehr Flexibilität bieten, um Intelligenz, Latenz und Kosten optimal abzuwägen. Context Compaction unterstützt zudem längere Konversationen und agentenbasierte Workflows, indem ältere Kontexte zusammengefasst werden, bevor Limits erreicht sind.
128k Ausgabe-Token erweitern die Claude Opus 4.6 API für umfangreichere Aufgaben
Die Claude Opus 4.6 API unterstützt Ausgaben von bis zu 128k Token und eignet sich damit besser für Aufgaben, die umfangreiche Antworten in einem einzigen Request erfordern. Dies ist besonders nützlich für die Generierung langer Texte, große Code-Transformationen, strukturierte Dokumentenausgaben und andere Workflows, die sonst auf mehrere Requests aufgeteilt werden müssten. Mit der höheren Ausgabekapazität wird die Claude Opus 4.6 API deutlich effizienter für Anwendungen, die längere und vollständigere Ergebnisse benötigen.
So deployen Sie die Claude Opus 4.6 API kostengünstig mit Kie.ai
Legen Sie mit unserem Produkt in wenigen einfachen Schritten los...
Auf Kie.ai registrieren und Claude Opus 4.6 API-Key erhalten
Claude Opus 4.6 API kostenlos im Playground testen
Integrieren Sie die Claude Opus 4.6 API in Ihre Anwendung
Konfigurieren Sie die Claude Opus 4.6 API für Produktions-Workloads
Claude Opus 4.6 API skalierbar deployen mit Kie.ai
Claude Opus 4.6 im Vergleich zu Gemini 3.1 Pro, GPT-5.4 und anderen Claude-Modellen
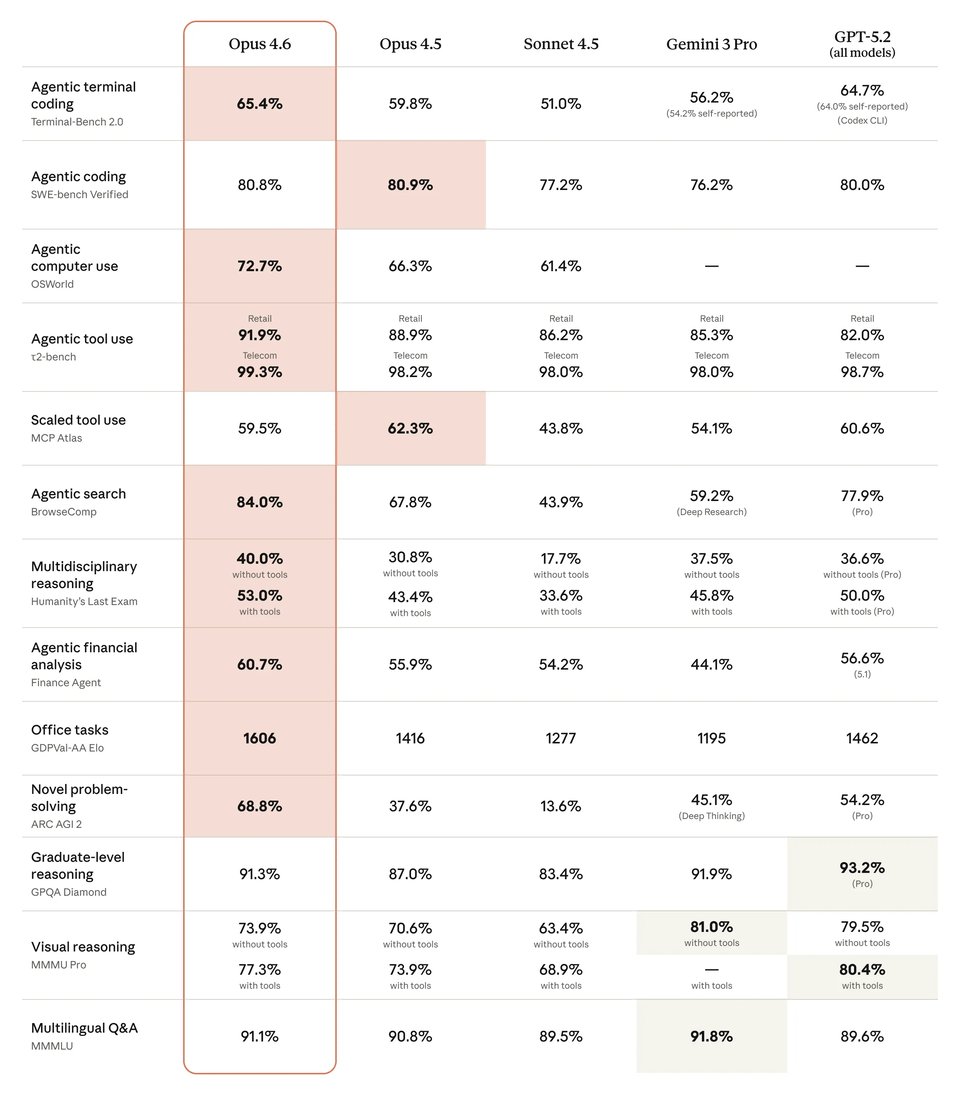
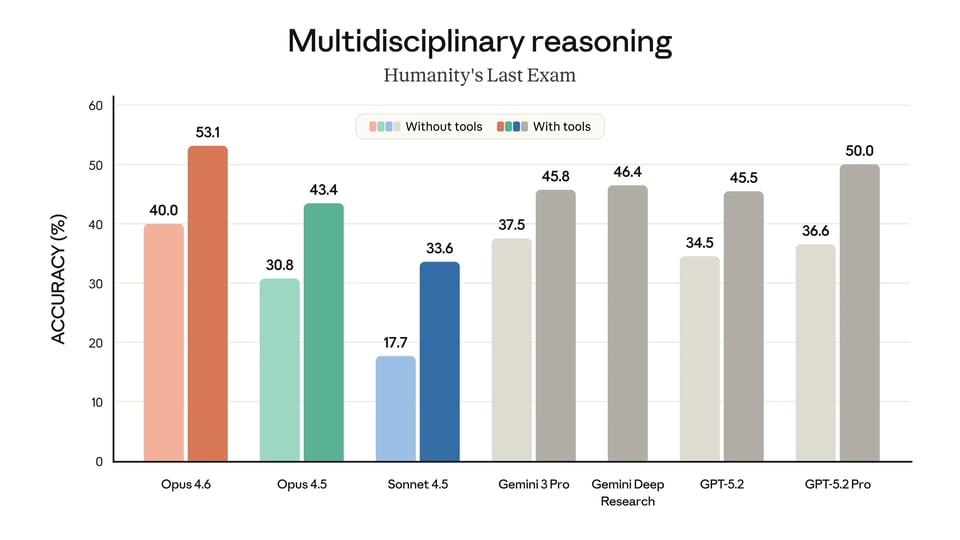
Claude Opus 4.6 zeigt ein starkes Benchmark-Profil in den Bereichen Coding, Computersteuerung, Suche und fortgeschrittenes Reasoning im Vergleich zu Gemini 3.1 Pro, GPT-5.4 und früheren Claude-Modellen. Der folgende Vergleich zeigt: Claude Opus 4.6 führt bei mehreren wichtigen Workflow-Benchmarks deutlich gegenüber Claude Opus 4.5, Claude Sonnet 4.5 und Gemini 3.1 Pro, während GPT-5.4 in Bereichen wie Terminal-Coding, Computersteuerung und Reasoning auf akademischem Niveau äußerst konkurrenzfähig bleibt. Dies macht Claude Opus 4.6 zu einer überzeugenden Wahl für Teams, die die Modellleistung für agentenbasierte Aufgaben und produktionsorientierte Wissensarbeit bewerten.
| Benchmark | Claude Opus 4.6 | Claude Opus 4.5 | Claude Sonnet 4.5 | Gemini 3.1 Pro | GPT-5.4 |
|---|---|---|---|---|---|
| Agentic terminal coding | 65.40% | 59.80% | 51.00% | 68.50% | 75.10% |
| Agentic computer use | 72.70% | 66.30% | 61.40% | — | 75.00% |
| Agentic search | 84.00% | 67.80% | 43.90% | 85.90% | 82.70% |
| Multidisciplinary reasoning (no tools) | 40.00% | 30.80% | 17.70% | 44.70% | 39.80% |
| Multidisciplinary reasoning (with tools) | 53.00% | 43.40% | 33.60% | — | 52.10% |
| Graduate-level reasoning | 91.30% | 87.00% | 83.40% | 94.30% | 92.80% |