Seedance 2.5 on KIE is ByteDance’s upgraded AI video model, built for longer, more controllable video generation. It supports up to 30-second videos, multimodal references, precise editing, and improved consistency for more cinematic and production-ready creative workflows.
Wan3.0 is Alibaba’s next-generation all-in-one video generation model built for multimodal creation. It supports text, image, video, audio, and structured references to produce more consistent, realistic, and controllable video content with enhanced storytelling and editing capabilities.
Seedance 2.0 on KIE is a multimodal Al video model by ByteDance, optimized for fast and realistic video generation. It supports high-quality virtual human video creation with strong multi-shot consistency, enabling more lifelike and cinematic outputs across scenes.
GPT Image 2 is OpenAI’s next-gen image model built for stronger photorealism, cleaner image editing, sharper text rendering, and more polished product photography. Designed for more advanced visual workflows, it pushes image generation beyond basic text-to-image output and into higher-quality creative, commercial, and design-ready use cases.
Meet Nano Banana 2, Google’s Gemini 3.1 Flash Image model, now available via Kie AI API. Built for developers, it combines lightning-fast speed with Pro-level quality, accurate text rendering, strong character consistency, and scalable image generation and editing workflows.
Grok 4.6 is xAI’s latest frontier AI model, designed to enhance long-running agents, advanced reasoning, coding intelligence, and interactive AI experiences. Building on Grok 4.5, it delivers improved performance for complex multi-step tasks, knowledge work, software engineering, and creative applications.
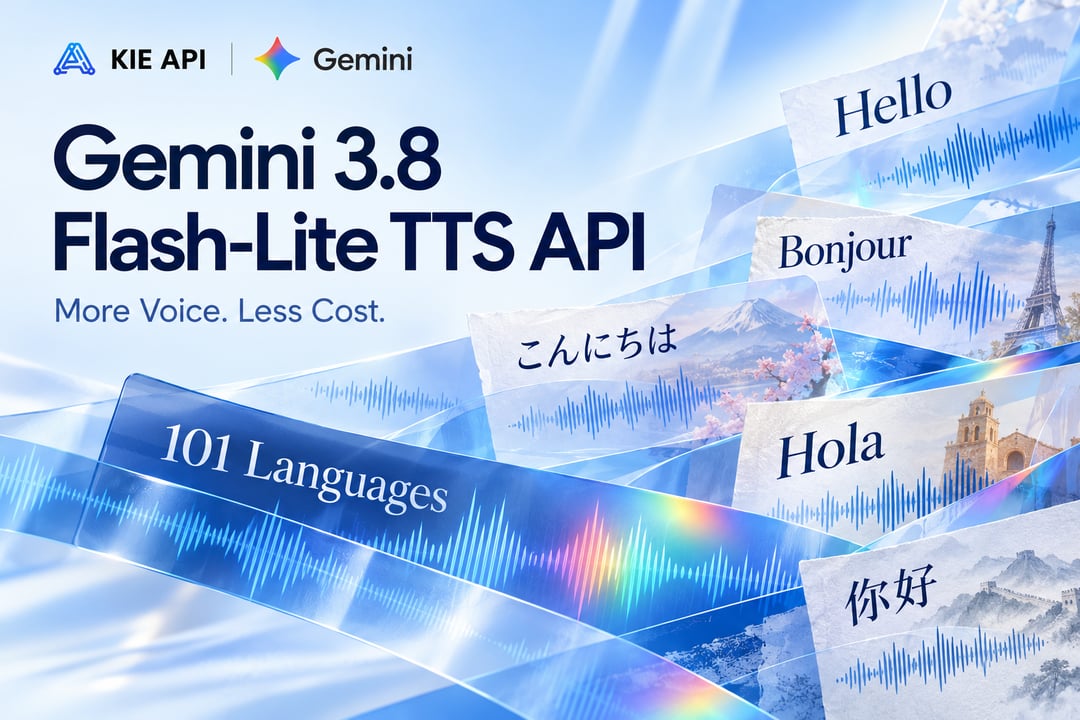
Google’s efficient text-to-speech model built for low-latency, high-throughput voice generation. Gemini 3.8 Flash-Lite TTS supports natural speech across 101 languages, voice replication, multi-speaker audio, and long-form generation, making it ideal for voice agents and high-volume TTS workflows.
Google’s flagship creative text-to-speech model for high-fidelity, expressive voice generation. Gemini 3.8 Flash TTS supports natural-language voice design, voice cloning from around 30s of authorized audio, multi-speaker dialogue, and speech generation across 130 languages.
Gemini 2.5 Pro Preview TTS is Google’s premium text-to-speech model designed for studio-quality, high-fidelity audio generation. It enables developers to create realistic AI voices with natural language instructions, expressive speech, and long-form audio capabilities.

API di Text to Speech per la generazione di voci AI
Costruisci esperienze con voci AI realiste grazie a un’API scalabile di text to speech. Accedi a diversi modelli di voci AI, inclusi ElevenLabs, con test gratuiti e integrazione veloce.
Caratteristiche Principali dell'API Text-to-Speech di Kie.ai
Generazione di voci AI naturali
Crea discorsi realistici con una potente API di sintesi vocale basata su AI, che offre tono naturale, pronuncia accurata e espressione umana e naturale. Genera contenuti con voce AI che risuonano in modo coinvolgente nei video, nelle app e nei prodotti digitali.
API Text-to-Speech Velocissima per Applicazioni in Tempo Reale
Crea esperienze vocali reattive con un'API Text-to-Speech a bassa latenza. Supporta flussi di lavoro in tempo reale per assistenti AI, chatbot, sistemi di supporto clienti e applicazioni interattive.
Come usare l’API di sintesi vocale di Kie.ai
Passo 1: Esplora e scegli un modello di API Text-to-Speech
Sfoglia i modelli disponibili dell'API Text-to-Speech e confronta qualità vocale, velocità, supporto linguistico e stili di pronuncia. Scegli l'API basata su AI che meglio si adatta alle esigenze del tuo prodotto.
Passo 2: Prova con Crediti Gratuiti per l'API Text-to-Speech
Usa il playground online e i crediti gratuiti per generare esempi audio. Verifica rapidamente la qualità dell'output dell'API TTS prima dell'integrazione.
Passo 3: Ottieni la tua Chiave API per l'API Text-to-Speech
Crea la tua chiave API e prepara l'ambiente per l'integrazione. Inizia a creare flussi di lavoro per la generazione di audio da testo con una configurazione semplice e accesso facile per sviluppatori.

Passo 4: Invia testo e genera audio con voce AI
Effettua una richiesta all’API di text-to-speech e trasforma immediatamente il testo in voce. Usa l’output vocale AI nelle tue app, piattaforme di contenuti, assistenti o strumenti di automazione.

Perché scegliere l’API di sintesi vocale Kie.ai
Più modelli di API di sintesi vocale tramite una singola integrazione
Crediti gratuiti per l’API di sintesi vocale per test rapidi
API di sintesi vocale AI economica e veloce
Integrazione semplice dell’API di sintesi vocale con documentazione chiara
Casi d’uso dell’API TTS per applicazioni SaaS e software
Voiceover AI per video e contenuti
Utilizza un’API di text-to-speech per generare voce AI naturale per video marketing, tutorial, podcast, contenuti brevi e contenuti per social media. Crea contenuti vocali AI in modo rapido, senza registrazione manuale.
API TTS per assistente virtuale e chatbot
Crea esperienze conversazionali con un’API TTS che genera voce sintetizzata naturale e reattiva. Integra processi vocali AI in assistenti virtuali, sistemi di supporto clienti e applicazioni di chat.
API text-to-audio per piattaforme di formazione
Trasforma le lezioni scritte in audio con un’API scalabile text-to-audio. Crea esperienze vocali AI per corsi online, app di apprendimento linguistico e piattaforme educative.
Voce AI per prodotti accessibili
Usa un’API text-to-speech AI per rendere il contenuto scritto più facile da leggere. Costruisci esperienze accessibili per articoli, siti web, app mobili e prodotti digitali attraverso la voce sintetizzata.
API text-to-speech gratuita per prototipi di prodotto
Inizia con il test gratuito dell’API text-to-speech e verifica la voce sintetizzata prima della produzione. Crea e testa rapidamente processi vocali AI per nuovi prodotti e sviluppo MVP.
24/7 Support for Text to Speech API Developers
Get support anytime for text to speech API integration, workflow questions, and technical issues. Build and scale AI voice text to speech applications with confidence.
Domande Frequenti su Kie.ai Text-to-Speech API
Che cos'è un’API text-to-speech?
Un’API di text-to-speech converte il testo scritto in un output audio naturale tramite richieste API. Gli sviluppatori utilizzano un’API di text-to-speech per integrare funzionalità vocali nelle applicazioni, nei siti web e nei prodotti AI.
Kie.ai mette a disposizione un’API di text-to-speech gratuita?
Sì. Kie.ai offre crediti gratuiti per l’API di text-to-speech per test. Gli sviluppatori possono provare i flussi di lavoro dell’API di text-to-speech e valutare la qualità della voce prima di passare alla produzione.
Come posso integrare un’API di text-to-speech nelle mie applicazioni?
Puoi integrare un’API di text-to-speech creando una chiave API, inviando il testo tramite endpoint API e ricevendo l’output audio generato per il flusso di lavoro dell’applicazione. Per maggiori dettagli sull’implementazione, consulta la nostra documentazione API.
Kie.ai include il text-to-speech di ElevenLabs?
Sì. Kie.ai fornisce accesso al text-to-speech di ElevenLabs e continua ad espandere la sua libreria di API di text-to-speech con nuovi modelli AI. Gli sviluppatori possono accedere a più opzioni vocali, funzionalità e capacità man mano che vengono aggiunti nuovi modelli.
Quali prodotti usano spesso un’API di text-to-speech?
Le API di text-to-speech sono ampiamente utilizzate in assistenti AI, chatbot, piattaforme educative, strumenti di accessibilità, app per la creazione di contenuti e prodotti SaaS con funzionalità vocali.